RAG Là Gì? Hướng Dẫn Xây Dựng Hệ Thống Trả Lời Câu Hỏi Tự Động
RAG (Retrieval-Augmented Generation) là kỹ thuật kết hợp tìm kiếm thông tin với mô hình ngôn ngữ lớn (LLM) để tạo ra câu trả lời chính xác hơn. Thay vì chỉ dựa vào kiến thức từ training data, LLM sẽ truy xuất tài liệu liên quan trước khi trả lời. Đây là một trong những công nghệ AI quan trọng nhất năm 2025, được áp dụng rộng rãi trong chatbot doanh nghiệp, hỗ trợ khách hàng và tìm kiếm tri thức nội bộ.
1. RAG Hoạt Động Như Thế Nào?
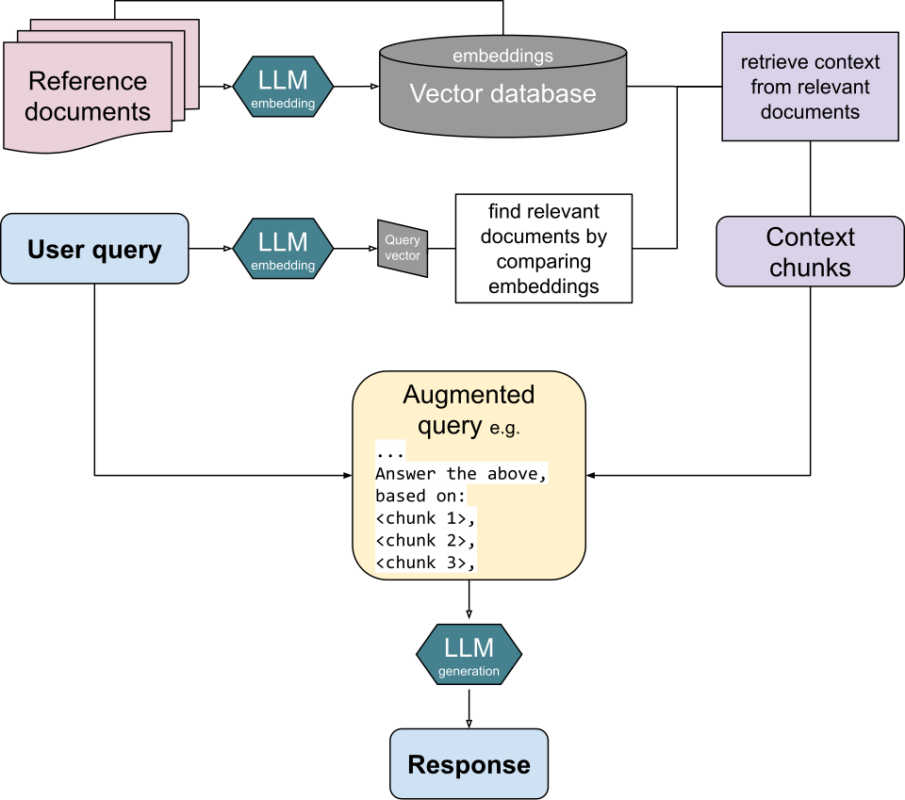
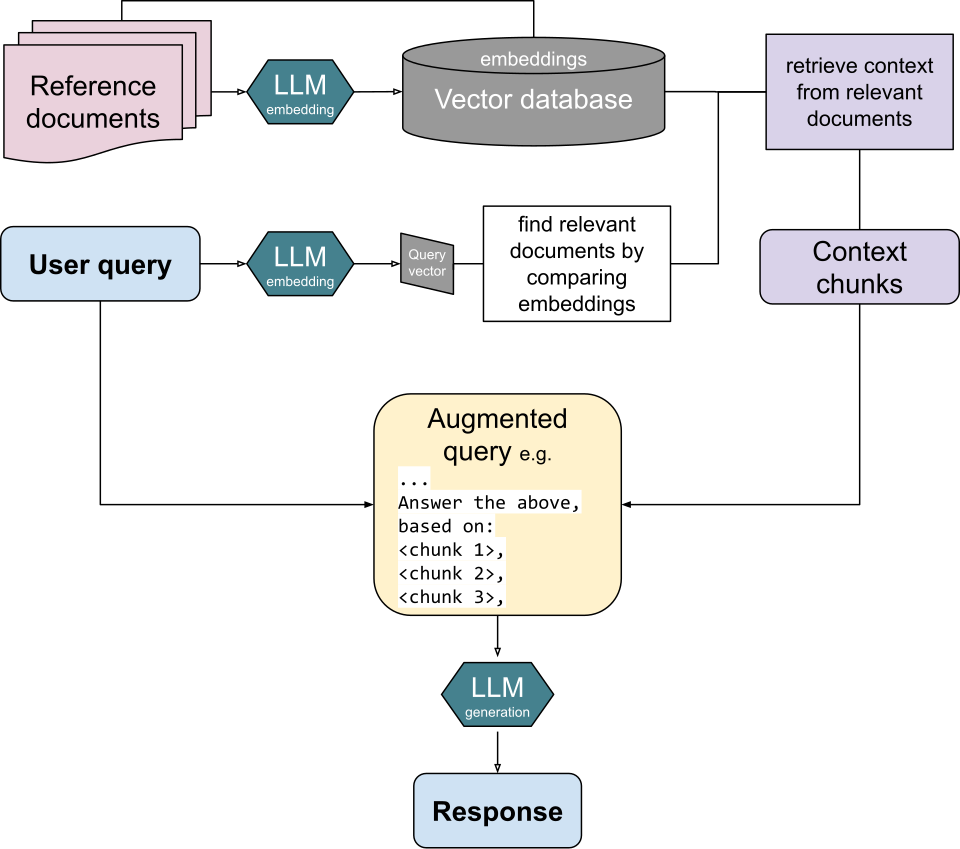
Quy trình RAG gồm 3 giai đoạn chính:
- Truy xuất (Retrieval): Hệ thống tìm kiếm các tài liệu liên quan đến câu hỏi của người dùng từ cơ sở dữ liệu. Ví dụ: người dùng hỏi “Chính sách đổi hàng của công ty”, hệ thống tìm các đoạn văn bản liên quan trong kho tài liệu.
- Tăng cường (Augmentation): Các tài liệu tìm được được gắn vào prompt của LLM như ngữ cảnh bổ sung.
- Sinh câu trả lời (Generation): LLM đọc cả câu hỏi + ngữ cảnh và tổng hợp câu trả lời có trích dẫn nguồn.
2. Tại Sao Cần RAG Khi Đã Có LLM?
LLM truyền thống có 3 hạn chế lớn:
- Kiến thức tĩnh: LLM chỉ biết những gì có trong training data. Nếu sự kiện thay đổi sau khi training, LLM sẽ trả lời sai.
- Hallucination (ảo giác): LLM có thể bịa ra thông tin khi không chắc chắn. Theo nghiên cứu của MIT Technology Review, LLM thậm chí có thể trích dẫn pháp lý không tồn tại.
- Không truy cập dữ liệu riêng: LLM không biết về tài liệu nội bộ công ty, hợp đồng, báo cáo tài chính.
RAG giải quyết cả 3 vấn đề này bằng cách cung cấp ngữ cảnh thực tế từ nguồn dữ liệu đáng tin cậy.
3. Các Bước Xây Dựng Hệ Thống RAG
Bước 3.1: Chuẩn Bị Dữ Liệu
Thu thập tài liệu nguồn: PDF, Word, web pages, cơ sở dữ liệu. Chất lượng dữ liệu quyết định chất lượng câu trả lời.
Bước 3.2: Chunking – Chia Nhỏ Tài Liệu
Tài liệu dài được chia thành các “chunk” (đoạn văn bản nhỏ) kích thước 256-512 token. Mỗi chunk cần đủ ngữ cảnh để hiểu ý nghĩa độc lập.
- Cố định kích thước: Chia theo số token cố định, dễ triển khai
- Overlapping chunks: Chia chồng lấp 10-20% để giữ ngữ cảnh xuyên chunk
- Semantic chunking: Chia theo ý nghĩa câu, phức tạp hơn nhưng chính xác hơn
Bước 3.3: Tạo Embedding
Mỗi chunk được chuyển thành vector số bằng mô hình embedding (ví dụ: OpenAI text-embedding-3-small, hoặc mô hình mã nguồn mở như BGE, E5). Vector này đại diện cho “ý nghĩa” của đoạn văn bản.
Bước 3.4: Lưu Trữ Trong Vector Database
Vector database lưu trữ và tìm kiếm nhanh các vector dựa trên độ tương đồng ngữ nghĩa. Các lựa chọn phổ biến:
| Database | Loại | Ưu điểm |
|---|---|---|
| Pinecone | Cloud | Quản lý đơn giản, scale tự động |
| Weaviate | Open-source | Hybrid search, multi-modal |
| ChromaDB | Open-source | Nhẹ, tích hợp Python dễ dàng |
| Qdrant | Open-source | Tốc độ cao, filter mạnh |
Bước 3.5: Xây Dựng Pipeline Truy Vấn
Khi người dùng hỏi câu hỏi:
- Câu hỏi được chuyển thành vector bằng cùng mô hình embedding
- Tìm kiếm top-K chunk có vector gần nhất với câu hỏi
- Các chunk tìm được được gắn vào prompt với instructions cho LLM
- LLM tạo câu trả lời dựa trên ngữ cảnh đã truy xuất
4. Công Cụ Xây Dựng RAG Phổ Biến
- LangChain: Framework Python phổ biến nhất cho RAG. Hỗ trợ nhiều LLM, vector DB, và chunking strategies.
- LlamaIndex: Tối ưu cho RAG với dữ liệu có cấu trúc, hỗ trợ index đa dạng.
- Haystack: Framework của deepset, mạnh cho production pipelines.
5. Ứng Dụng Thực Tế Của RAG
- Chatbot hỗ trợ khách hàng: trả lời dựa trên tài liệu sản phẩm, FAQ
- Tìm kiếm tri thức nội bộ: nhân viên tìm kiếm chính sách, quy trình
- Hỗ trợ pháp lý: phân tích hợp đồng, trích dẫn điều luật
- Y tế: tra cứu tài liệu y khoa, hỗ trợ chẩn đoán
Kết Luận
RAG đang trở thành kiến trúc tiêu chuẩn cho các ứng dụng AI thực tế. Thay vì bỏ hàng triệu USD để fine-tune LLM, RAG cho phép cập nhật kiến thức chỉ bằng cách thêm tài liệu mới vào database. Kết hợp với các công cụ như LangChain, LlamaIndex, việc xây dựng hệ thống RAG không còn là bài toán quá phức tạp. Bước tiếp theo là tối ưu retrieval quality — chunking strategy, embedding model choice, và hybrid search.
Tham khảo thêm: RAG Original Paper (Lewis et al.) | LangChain | LlamaIndex | arXiv