Self-attention là gì: cơ chế Q, K, V trong mô hình ngôn ngữ
Self-attention là gì: Q, K, V và cách mô hình ngôn ngữ tính ngữ cảnh Self-attention là cơ chế cho phép mô hình ngôn ngữ tự tính mối quan hệ…
Xem thêm
RAG là gì: retrieval-augmented generation và cách hoạt động
RAG là gì: retrieval-augmented generation và cách hoạt động Retrieval-augmented generation (RAG) là một kỹ thuật tiên tiến trong lĩnh vực AI giúp mô hình ngôn ngữ lớn (LLM) truy…
Xem thêm
Prompt engineering là gì: kỹ thuật viết lệnh cho AI hiệu quả
Prompt engineering là gì: kỹ thuật viết lệnh cho AI Prompt engineering là kỹ thuật thiết kế và tinh chỉnh câu lệnh (prompt) gửi cho mô hình AI để đạt…
Xem thêm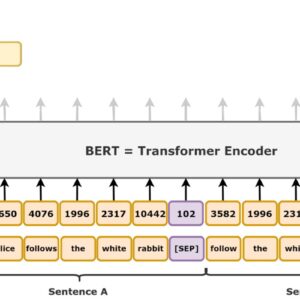
BERT là gì: mô hình nền tảng cho xử lý ngôn ngữ tự nhiên
BERT là gì: mô hình nền tảng cho xử lý ngôn ngữ tự nhiên BERT (Bidirectional Encoder Representations from Transformers) là mô hình ngôn ngữ hai chiều dựa trên kiến…
Xem thêm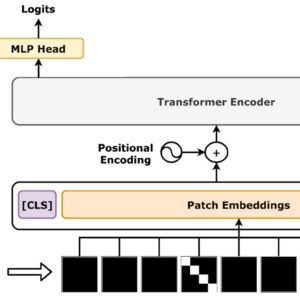
Vision Transformer là gì: cách AI nhìn ảnh qua cơ chế tự chú ý
Vision Transformer (ViT) là kiến trúc mô hình AI xử lý ảnh bằng chính cơ chế tự chú ý (self-attention) của Transformer, thay cho tích chân tích. Thay vì quét…
Xem thêm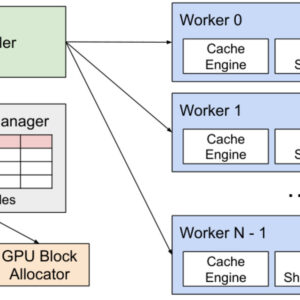
KV cache là gì: bộ nhớ chi phối tốc độ sinh văn bản của LLM
KV cache là gì? là bộ nhớ tạm trong quá trình suy luận mô hình ngôn ngữ lớn, dùng để lưu lại kết quả trung gian của lớp attention mỗi…
Xem thêm
NPU là gì: bộ xử lý AI chuyên dụng và cách đọc chỉ số TOPS
NPU là gì và vì sao con số TOPS trên hộp điện thoại ngày càng phóng đại. Neural Processing Unit là bộ xử lý chuyên dụng cho mô hình AI,…
Xem thêm
Mô hình khuếch tán là gì? Cách AI tạo ảnh chất lượng cao từ nhiễu
Mô hình khuếch tán là gì? Cách AI tạo ảnh chất lượng cao từ nhiễu Mô hình khuếch tán (diffusion model) là một lớp mô hình sinh tạo dữ liệu…
Xem thêm
Knowledge distillation là gì? Nén mô hình AI nhỏ gọn hơn
Knowledge distillation (KD) là một kỹ thuật nén mô hình trí tuệ nhân tạo cho phép chuyển giao kiến thức từ một mô hình lớn, phức tạp (gọi là teacher…
Xem thêm
Speculative decoding: kỹ thuật tăng tốc sinh văn bản LLM
Speculative decoding (giải mã suy đoán) là kỹ thuật tăng tốc sinh văn bản cho Large Language Model (LLM) mà không làm thay đổi phân phối đầu ra. Ý tưởng…
Xem thêm