RAG: Retrieval-Augmented Generation Hướng Dẫn Thực Hành Cho AI
RAG (Retrieval-Augmented Generation) là kỹ thuật cho phép mô hình ngôn ngữ lớn (LLM) truy xuất và tích hợp thông tin từ nguồn dữ liệu bên ngoài. Thay vì chỉ dựa vào dữ liệu huấn luyện tĩnh, RAG giúp AI trả lời chính xác hơn, giảm ảo giác, và trích dẫn nguồn đáng tin cậy.
LLM truyền thống có những hạn chế nghiêm trọng: chúng chỉ biết những gì được huấn luyện, không thể truy cập thông tin mới sau khi triển khai, và thường “ảo giác” — tạo ra thông tin sai lệch với vẻ tự tin. Ví dụ, khi Google Bard lần đầu ra mắt, LLM đã cung cấp thông tin sai về Kính thiên văn James Webb, gây thiệt hại 100 tỷ USD vốn hóa cho Google.
RAG giải quyết bằng cách kết hợp mô hình ngôn ngữ với cơ chế truy xuất thông tin. Trước khi trả lời, LLM tham khảo tài liệu liên quan từ cơ sở dữ liệu, tài liệu uploaded, hoặc web sources. Kết quả: câu trả lời bám sát sự thật, có trích dẫn nguồn, và giảm đáng kể ảo giác.
Quy Trình Hoạt Động Của RAG
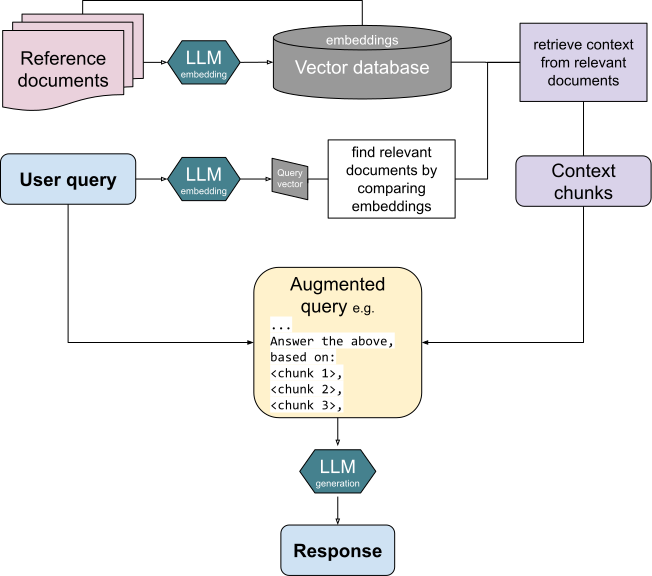
RAG hoạt động qua các giai đoạn chính:
- Chuẩn bị dữ liệu: Tài liệu được chia nhỏ thành các chunk, sau đó chuyển thành vector embeddings — biểu diễn toán học trong không gian nhiều chiều.
- Truy xuất (Retrieval): Khi người dùng đặt câu hỏi, câu hỏi được chuyển thành vector. Hệ thống tìm kiếm các chunk có vector gần nhất với câu hỏi bằng thuật toán similarity search.
- Tăng cường (Augmentation): Các chunk truy xuất được đưa vào prompt của LLM như ngữ cảnh bổ sung.
- Tạo câu trả lời (Generation): LLM tổng hợp câu trả lời dựa trên cả ngữ cảnh truy xuất và kiến thức huấn luyện sẵn.
Ứng Dụng Thực Tế Của RAG
- Chatbot doanh nghiệp: Trả lời câu hỏi nhân viên dựa trên tài liệu nội bộ công ty — chính sách, quy trình, FAQ — mà không cần chỉnh sửa LLM.
- Hệ thống hỏi đáp pháp lý: Luật sư truy xuất án lệ, điều luật liên quan từ cơ sở dữ liệu pháp lý, LLM tóm tắt và phân tích.
- Hỗ trợ kỹ thuật: Đội IT tra cứu tài liệu kỹ thuật, hướng dẫn cấu hình hệ thống phức tạp.
- Y tế: Bác sĩ tra cứu nghiên cứu y khoa mới nhất để hỗ trợ chẩn đoán.
Hạn Chế Và Thách Thức
RAG không phải giải pháp hoàn hảo. Nếu nguồn dữ liệu truy xuất chứa thông tin sai, LLM vẫn có thể tạo ra kết quả sai. RAG poisoning — tấn công đầu độc dữ liệu truy xuất — là mối đe dọa mới. Chất lượng RAG phụ thuộc trực tiếp vào: (1) chất lượng chunking và embeddings, (2) độ chính xác của retriever, (3) khả năng tổng hợp của LLM.
Công Cụ Triển Khai RAG Phổ Biến
| Công cụ | Đặc điểm |
|---|---|
| Haystack | Framework Python linh hoạt, hỗ trợ nhiều retriever và generator |
| LangChain | Hệ sinh thái phong phú, tích hợp nhiều LLM và vector store |
| LlamaIndex | Tối ưu cho dữ liệu có cấu trúc và index truy xuất |
| OpenAI Assistants API | RAG tích hợp sẵn, không cần quản lý hạ tầng |
RAG được giới thiệu trong bài báo năm 2020 và nhanh chóng trở thành phương pháp được áp dụng rộng rãi trong các hệ thống AI hiện đại. Khả năng kết hợp kiến thức tĩnh của LLM với dữ liệu động từ bên ngoài giúp RAG trở thành nền tảng không thể thiếu cho các ứng dụng AI doanh nghiệp. Nhiều công ty công nghệ lớn như Google, Microsoft, OpenAI đã tích hợp RAG vào sản phẩm của mình, từ chatbot hỗ trợ khách hàng đến hệ thống trợ lý lập trình.
RAG So Với Fine-Tuning
Nhiều developer nhầm lẫn giữa RAG và fine-tuning. Cả hai đều cải thiện hiệu suất LLM, nhưng cách tiếp cận hoàn toàn khác nhau. Fine-tuning thay đổi trọng số của mô hình bằng cách huấn luyện thêm trên dữ liệu mới — tốn kém về tài nguyên tính toán, yêu cầu expertise, và mất khả năng rollback. RAG thì không thay đổi mô hình — chỉ bổ sung ngữ cảnh vào prompt. Điều này có nghĩa RAG:
- Nhanh hơn: Không cần huấn luyện lại, triển khai ngay lập tức
- Rẻ hơn: Không cần GPU đắt tiền cho training
- Cập nhật được: Thay đổi dữ liệu truy xuất không cần retrain
- Minh bạch hơn: Nguồn truy xuất hiển thị rõ ràng, dễ audit
Tuy nhiên, RAG không phải lúc nào cũng thay thế fine-tuning. Khi cần LLM hiểu sâu về domain-specific language (ví dụ: thuật ngữ y tế chuyên sâu), fine-tuning kết hợp RAG cho kết quả tốt nhất.
Thiết Kế Hệ Thống RAG Hiệu Quả
Xây dựng RAG production-ready đòi hỏi chú ý nhiều khía cạnh:
- Chunking strategy: Chia tài liệu thành chunk quá nhỏ sẽ mất ngữ cảnh, quá lớn sẽ mất precision. Thường dùng 256-512 token với overlap 50-100 token.
- Embedding model: Chọn model phù hợp với ngôn ngữ. Cho tiếng Việt, cần model hỗ trợ multilingual như multilingual-e5-large hoặc openai/text-embedding-3-large.
- Hybrid search: Kết hợp vector search (semantic) với BM25 (keyword) để cải thiện recall. Nhiều hệ thống dùng weighted fusion.
- Re-ranking: Sau retrieval, dùng cross-encoder model để re-rank kết quả — cải thiện precision đáng kể.
- Metadata filtering: Lọc theo ngày, tác giả, category trước khi vector search — giảm nhiễu.
Với sự bùng nổ của AI tạo sinh, RAG đã trở thành kiến thức cơ bản mà mọi developer AI cần nắm. Từ startup đến enterprise, RAG là cầu nối giữa LLM và dữ liệu thực tế, biến mô hình ngôn ngữ thành công cụ hữu ích trong thế giới thực.