MoE (Mixture of Experts) trong LLM: Nguyên lý và ứng dụng thực tế
Mixture of Experts (MoE) là một kiến trúc mạng nơ ron mạnh mẽ đã thay đổi cách chúng ta xây dựng các mô hình ngôn ngữ lớn (LLM). Thay vì sử dụng một mạng nơ ron đồng nhất cho tất cả các đầu vào, MoE chia mô hình thành nhiều “expert” mạng nơ ron chuyên biệt và một cơ chế điều phối (gating network) để chọn ra những expert phù hợp nhất cho mỗi đầu vào.
Nguyên lý cơ bản của MoE
Trong một lớp MoE truyền thống, chúng ta có N expert networks (thường là các feed-forward network) và một gating network. Gating network nhận đầu vào và tạo ra một phân phối xác suất yli N expert, chỉ chọn top-k expert (thường k=2) để xử lý đầu vào này. Điều này cho phép mô hình có khả năng tổng tham số rất lớn (do nhiều expert) nhưng chỉ 활성화 một phần nhỏ của tham số cho mỗi lần tính toán.
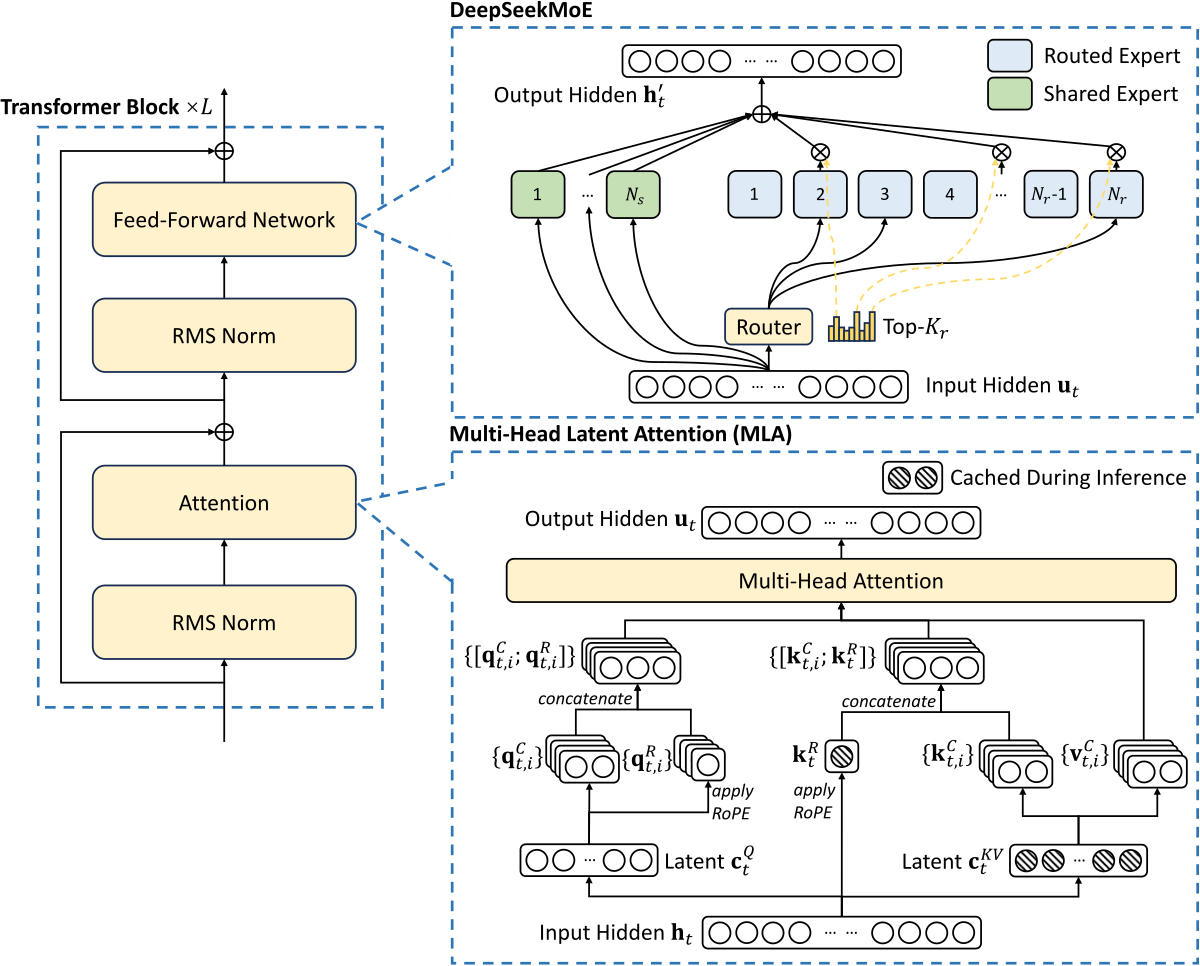
Lợi thế chính của MoE là hiệu quả về tính toán. Mặc dù tổng số tham số có thể đạt đến hàng trăm tỷ hoặc ngàn tỷ, nhưng mỗi token chỉ cần kích hoạt một phần rất nhỏ của các tham số này (thường là 2-4 expert trong tổng số 64-128). Điều này giúp quá trình inference và training hiệu quả hơn rất nhiều so với các mô hình dense có cùng kích thước.
Các mô hình MoE nổi tiếng
- Mixtral 8x7B: MoE với 8 expert, mỗi expert là một mô hình 7B, nhưng chỉ sử dụng 2 expert cho mỗi token, tương đương với một mô hình 14B dense về tính toán.
- Google’s Switch Transformer: Một trong những mô hình MoE đầu tiên với khả năng mở rộng đến hàng trăm tỷ tham số.
- DeepSeek MoE: Série các mô hình MoE từ DeepSeek với hiệu suất cực tốt trên các tác vụ mã toán và lý luận.
- GLaM (Google): MoE với 1.2 nghìn tỷ tham số nhưng chỉ kích hoạt một phần nhỏ cho mỗi token.
Chiến lược routing trong MoE
Một trong những yếu tố quan trọng nhất của MoE là cơ chế định tuyến (routing). Có hai chiến lược chính:
- Top-k routing: Gating network chọn ra k expert có điểm số cao nhất cho mỗi token. Đây là chiến lược được sử dụng trong Mixtral và nhiều mô hình hiện đại.
- Hash routing: Gán token vào expert dựa trên hàm băm, giảm chi phí tính toán nhưng có thể dẫn đến phân phối không đồng đều.
- GShard routing: Kết hợp giữa top-k và load balancing để phân phối token đồng đều hơn giữa các expert.
Chất lượng của routing quyết định trực tiếp đến hiệu suất của mô hình. Một cơ chế routing tốt cần cân bằng giữa hai mục tiêu mâu thuẫn: chọn đúng expert cho từng token và phân phối tải đều giữa tất cả expert.
Ứng dụng thực tế của MoE
MoE đã được áp dụng thành công trong nhiều lĩnh vực:
- Ngôn ngữ xử lý tự nhiên: Cải thiện chất lượng dịch thuật, tóm tắt văn bản và trả lời câu hỏi mà không tăng tỉ lệ tính toán tương ứng.
- Mã máy tính: Các mô hình như DeepSeek Coder V2 sử dụng MoE để đạt hiệu suất xuất sắc trong việc sinh mã và hiểu ngữ cảnh lập trình.
- Đa modal: Kết hợp MoE với xử lý hình ảnh, âm thanh để tạo ra các mô hình đa modal hiệu quả.
- Hệ thống đề xuất: Xử lý các mục/item đa dạng và đặc trưng thưa hiệu quả.
Thách thức và hướng phát triển
Mặc dù có nhiều ưu điểm, MoE cũng đối mặt với một số thách thức:
- Imbalanced expert utilization: Một số expert có thể được sử dụng quá nhiều trong khi những expert khác ít được gọi đến.
- Routing instability: Gating network có thể thay đổi quyết định thường xuyên giữa các bước training.
- Memory overhead: Cần lưu trữ tất cả expert ngay cả khi chỉ sử dụng một phần của chúng.
Các nghiên cứu hiện tại tập trung vào việc cải thiện lại load balancing expert, phát triển các chiến lược routing ổn định hơn và tối ưu hóa bộ nhớ cho việc triển khai trên phần cứng.
MoE trong thực tế triển khai
Khi triển khai MoE trong sản xuất, có một số điểm cần lưu ý:
- Chọn số lượng expert phù hợp: Quá nhiều expert có thể làm tăng độ phức tạp của routing và giảm hiệu quả sử dụng. Thông thường 8-16 expert là đủ cho hầu hết các ứng dụng.
- Tối ưu hóa batch size: MoE hoạt động tốt nhất với batch size lớn để tận dụng được sự song song giữa các expert.
- Giám sát utilization: Cần theo dõi tỷ lệ sử dụng của từng expert để phát hiện sớm vấn đề mất cân bằng.
- Chọn đúng hardware: MoE cần bộ nhớ lớn để lưu trữ tất cả expert, vì vậy GPU có VRAM cao thường được ưu tiên.
Với sự phát triển của các framework như DeepSpeed-MoE và Fairseq, việc triển khai MoE đã trở nên dễ dàng hơn rất nhiều so với trước đây.
Kết luận
Mixture of Experts đại diện cho một hướng đi đầy hứa hẹn trong việc xây dựng các mô hình ngôn ngữ lớn hơn và mạnh mẽ hơn. Bằng cách kích hoạt có chọn lọc các phần khác nhau của mô hình, MoE cho phép chúng ta mở rộng đến quy mô trước đây không thể tưởng tượng được, đồng thời duy trì hiệu quả tính toán. Với sự cải tiến liên tục của phần cứng và thuật toán, chúng ta có thể mong đợi nhiều kiến trúc MoE sáng tạo hơn được áp dụng trong các lĩnh vực AI khác nhau.
Tham khảo thêm:
- Switch Transformer: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity
- Mixtral of Experts
- DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models