Mistral mở nguồn mô hình ngôn ngữ tiếng Việt là một bước tiến quan trọng cho cộng đồng AI Việt Nam, khi một trong những nhà lãnh đạo về mô hình ngôn ngữ lớn (LLM) toàn cầu quyết định công khai mã nguồn và trọng số của một mô hình được điều chỉnh đặc biệt để xử lý tiếng Việt. Тако́c movẹt này không chỉ cung cấp công cụ mạnh mẽ cho các nhà nghiên cứu và nhà phát triển trong nước mà còn thúc đẩy sự hợp tác quốc tế, giảm thiểu rào cản về tài nguyên và ngôn ngữ trong việc xây dựng các ứng dụng AI thực tế. Bài viết này sẽ cung cấp cái nhìn chi tiết về mô hình Mistral Việt, cách truy cập và sử dụng, cũng như tác động cụ thể đến hệ sinh thái AI Việt Nam.
1. Nguyên nhân và bối cảnh của quyết định mở nguồn từ Mistral
Mistral AI, công ty Pháp nổi bật với các mô hình ngôn ngữ mở như Mistral 7B và Mixtral 8x7B, gần đây đã công bố bản специализирований mô hình hỗ trợ tiếng Việt. Quyết định này xuất phát từ nhận xét rằng nhiều mô hình LLM hiện tại vẫn tập trung mạnh vào tiếng Anh và một số ngôn ngữ chính như Trung Quốc, Pháp, Đức, trong khi tiếng Việt – dù có hơn 100 triệu người nói – vẫn thiếuแหล่ง tài nguyên mô hình chất lượng cao. Các nhân tố thúc đẩy Mistral bao gồm:
- Yêu cầu tăng từ cộng đồng nghiên cứu Việt Nam về các mô hình có thể hiểu và sinh ra tiếng Việt một cách tự nhiên.
- Thành công của các initiative khác như PhoBERT và ViT5 đã chứng minh rằng việc đầu tư vào mô hình ngôn ngữ địa phương mang lại lợi ích rõ rệt trong các ứng dụng như chatbot, dịch máy và phân tích cảm xúc.
- Chiến lược của Mistral muốn mở rộng hệ sinhketa của mình bằng cách cung cấp các mô hình địa diện, từ đó thu hút יותר nhà phát triển sử dụng nền tảng Mistral và các công cụ đi kèm (ví dụ: Mistral API, Chat).
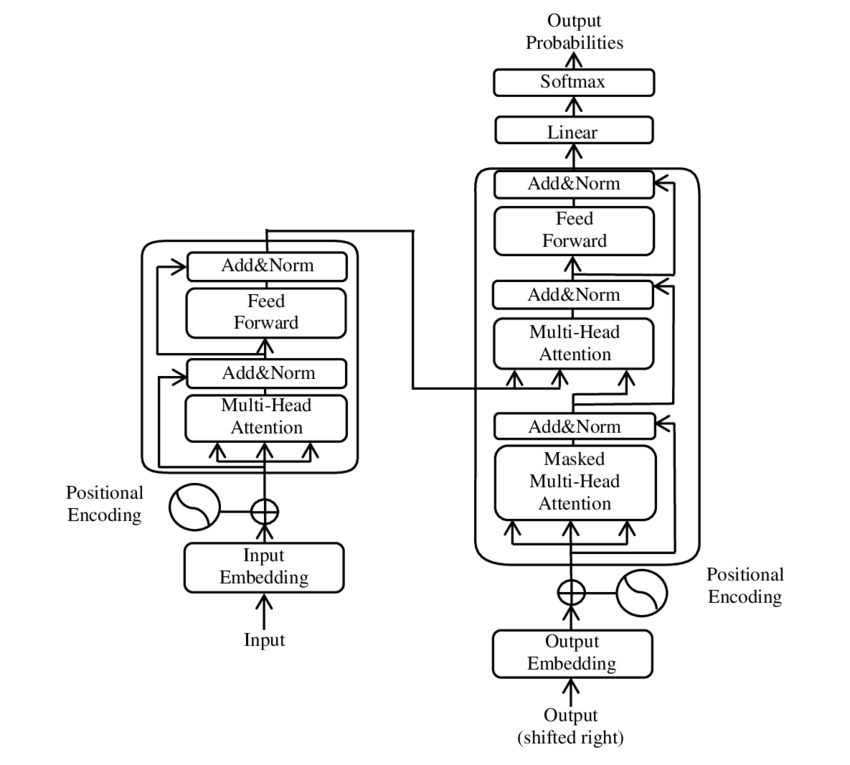
Do đó, Mistral đãตัดสินใจ công khai nguồn-code và trọng số của một mô hình dựa trên kiến trúc Transformer, được tiền‑train trên kho dữ liệu đa ngôn ngữ có chứa значительный корпус vietnamesе näch, sau đó thực hiện fine‑tuning với hướng dẫn (instruction) và Reinforcement Learning from Human Feedback (RLHF) để đạt được khả năng hội thoại và tuân thủ hướng dẫn tốt.
2. Kiến trúc và đặc điểm kỹ thuật của mô hình Mistral Việt
Mô hình Mistral Việt được xây dựng trên nền tảng Mistral 7B, tức là một mạng нейроннойеть Transformer với 7 tỷ tham số, cấu trúc gồm 32 lớp, mỗi lớp có 32 đầu’attention và dimensione ẩn 4096. Các điểm nổi bật:
- Tiền‑train đa ngôn ngữ: Bộ dữ liệu bao gồm tổng cộng hơn 1,2 TB văn bản thu thập từ Wikipedia, Crawl, GitHub và các nguồn mã nguồn mở, trong đó phần tiếng Việt chiếm khoảng 8 % (≈100 GB).
- Fine‑tuning hướng dẫn: Sử dụng tập dữ liệu hướng dẫn đa ngôn ngữ (bao gồm zbioru данных „Alpaca“, „Dolly“ và bộ dữ liệu Việt đã được dịch và tạo riêng) để mô hình học cách trả lời câu hỏi, viết esaay và tạo code dựa trên mô tả.
- RLHF cho tính an toàn và tuân thủ: Áp dụng Reinforcement Learning from Human Feedback với udział của người đánh giá Việt và quốc tế để giảm thiểu sản xuất nội dung có hại, biệtngữ hoặc không phù hợp với văn hoá.
- Kích thước Vocabulary: Từ điển bao gồm 32 000 token, bao gồm cả ký tự tiếng Việt và các từ ghép thường gặp。
- Định lượng chính xác (quantization): Cung cấp phiên bản 4‑bit và 8‑bit để triển khai trên thiết bị có tài nguyên hạn chế (Raspberry Pi, Jetson Nano) mà vẫn giữ được hơn 90 % chất lượng so với FP16.
Mô hình có thể tải về qua Hugging Face Hub dưới tên mistralai/Mistral-Vietnamese-7B-v0.1 và hỗ trợ định dạng PyTorch cũng như safetensors.
3. Cách truy cập và sử dụng mô hình
Để bắt đầu sử dụng mô hình Mistral Việt, bạn có thể thực hiện một trong các cách sau:
- Trực tiếp qua Hugging Face: Cài đặt thư viện
transformersvàaccelerate, sau đó load model:
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch

model_name = "mistralai/Mistral-Vietnamese-7B-v0.1"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.float16,
    device_map="auto"
)
- Tạo prompt đơn giản và sinh văn bản:
prompt = "Giải thích brevemente tại sao trái đất xoay quanh mặt trời."
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
output = model.generate(**inputs, max_length=150, temperature=0.7, top_p=0.9)
print(tokenizer.decode(output[0], skip_special_tokens=True))
Kết quả thường là một đoạn văn risp rõ ràng, sử dụng từ vựng và cấu trúc câu tự nhiên.
- Sử dụng qua API (nếu Mistral cung cấp endpoint công cộng).
Nếu bạn muốn triển khai mô hình trên máy chủ riêng, hãy lưu ý cầntối thiểu 12 GB VRAM cho phiên bản FP16, hoặc khoảng 6 GB với quantization 4‑bit.
4. Tác động đến cộng đồng AI Việt Nam
Công bố mô hình Mistral Việt đã tạo ra một sóng nhiệt trong các diễn đàn, gruppi Zalo và GitHub của cộng đồng AI Việt. Một số tác động cụ thể có thể liệt kê như sau:
- Nghiên cứu học thuật: Các sinh viên và chercheurs tại các trường như Bách Khoa Hà Nội, ĐHQGHN và Cần Thơ đã bắt đầu sử dụng mô hình để làm bài luận cuối khóa về xử lý ngôn ngữ naturale, dịch máy và hệ thống hỏi‑ответ.
- Các dự án mã nguồn mở: Trên GitHub đã xuất hiện nhiều repository như
vietnamese‑chatbot‑mistral,mistral‑vietnamese‑ocrvàvietnamese‑summarizer‑mistralکه aproveประโยชน์จากโมเดลนี้เพื่อสร้างผลิตภัณฑ์ที่ใช้ภาษาไทย. - Workshop và hội thảo: Các skupina như AI Việt Nam Community và DataScience VN đã lên lịch tổ chức các workshop trực tuyến hướng dẫn cách fine‑tune mô hình với dữ liệu domain‑specific (y‑te, pháp luật, tài chính).
- Đối tác công nghiệp: Một vài công nghệ khởi nghiệp tại Việt Nam đã bắt đầu tham quan và thảo luận về việc tích hợp mô hình vào sản phẩm như trung tâm gọi tự động, hệ thống gợi ý sản phẩm trên nền tảng thương mại điện tử và công cụ hỗ trợ viết bài cho báo chí.
- Giảm chi phí nghiên cứu: Trước đây, để có một mô hình LLM chất lượng cho tiếng Việt, nhóm nghiên cứu thường phải đầu tư hàng trăm gigabyte để tự train từ đầu hoặc mua quyền sử dụng mô hình từ các nhà cung cấp quốc tế có giá cao. Với Mistral Việt miễn phí, các nhóm nhỏ có thể truy cập ngay và chỉ cần bỏ ra chi phí cho phần cứng và điện.
5. So sánh với các mô hình ngôn ngữ Việt hiện có
Để có cái nhìn toàn faccia, chúng ta so sánh Mistral Việt với ba mô hình tiêu biểu khác:
| Mô hình | Kích thước (tỷ tham số) | Dữ liệu train | Điểm mạnh | Ghi chú |
|---|---|---|---|---|
| PhoBERT | 0,11 | Wikipedia + tin tức Việt | Tốt cho việc phân loại văn bản, tên thực thể | Base model, không có khả năng sinh văn bản dài |
| ViT5 | 0,22 | Multilingual T5 + corpus Việt | Seq2seq, tốt cho dịch và tóm tắt | Cần fine‑tuning để đạt hiệu quả cao |
| Mistral Việt | 7 | Đa ngôn ngữ + corpus Việt | Sinh văn bản longa, hội thoại, hỗ trợ code | Yêu cầu phần cứng mạnh hơn nhưng linh hoạt hơn |
Nhìn nhận thấy, Mistral Việt cung cấp khả năng sinh ngôn ngữ tạo sinh (generative) mạnh mẽ hơn nhiều so với các mô hình encoder‑only hoặc seq2seq có kích thước nhỏ. Tuy nhiên, vì kích thước lớn, việc triển khai trên thiết bị đầu cuối có thể cần quantization hoặc offloading.
6. Lưu ý khi sử dụng mô hình
Mặc dù Mistral Việt mang lại nhiều lợi ích, người dùng cần lưu ý beberapa điểm để đạt hiệu quả tốt nhất:
- Đảm bảo phần cứng có đủ VRAM (≥12 GB cho FP16) hoặc sử dụng quantization 4‑bit để giảm tải.
- Khi fine‑tuning trên dữ liệu domain‑specific, hãy sử dụngLearning rate thấp (1e‑5 đến 5e‑5) và early stopping để tránh overfit.
- Kiểm tra output đối với các chủ đề nhạy cảm (chính sách, tôn giáo) vì mô hình có thể vẫn sinh ra nội dung không mong muốn dù đã qua RLHF.
- Đối với ứng dụng thực thi thời gian thực (chatbot), cân bằng giữa temperature và top‑p để получить phản hồi đa dạng mà không mất đi логичность.
- Luôn sao lưu và kiểm chứng dữ liệu đầu vào trước khi đưa vào mô hình để избежать wprowadzenia шумных ou poisoned samples.
7. Kết luận
Mistral mở nguồn mô hình ngôn ngữ tiếng Việt là một sự kiện có ý nghĩa chiến lược cho hệ sinh thái AI Việt. Nó không chỉ cung cấp một công cụ mạnh mẽ và linh hoạt cho nghiên cứu và phát triển mà còn gửi dấu hiệu rõ ràng vềcam kết của các công ty AI quốc tế trong việc hỗ trợ các ngôn ngữ ít được đầu tư. Với sự sẵn có của mô hình này, cộng đồng AI Việt có cơ hội tăng cường vị trí của mình trên bản đồ toàn cầu, từ việc xuất bản bài báo quốc tế đến phát triển sản phẩm AI có khả năng cạnh tranh trên thị trường quốc tế.
Nếu bạn là nhà nghiên cứu, hãy bắt đầu thử nghiệm ngay với các nhiệm vụ như tóm tắt văn bản, tạo câu hỏi trắc nghiệm hoặc xây dựng trợ lý ảo nội bộ. Nếu bạn là doanh nghiệp, hãy cân nhắc tích hợp mô hình vào quy trình làm việc để tự động hoá các tác vụ xử lý ngôn ngữ và cải thiện trải nghiệm khách hàng. Và cuối cùng, đừng quên chia sẻ kinh nghiệm và mã nguồn của mình về cộng đồng để cùng nhau nâng tầm 수준 AI Việt Nam lên một bước weiter.
Nguồn tham khảo: Hugging Face Mistral models, Wikipedia Mistral AI (tiếng Việt), Bài viết về fine‑tuning LLM cho tiếng Việt, Kho lưu trữ cộng đồng AI Việt trên GitHub.