Small language models (SLMs) trên thiết bị edge: Phi-3, Gemma và xu hướng AI nhẹ
Những năm gần đây, xu hướng phát triển các mô hình ngôn ngữ nhỏ (Small Language Models – SLMs) đang ngày càng phổ biến, đặc biệt trong bối cảnh nhu cầu triển khai AI trên thiết bị edge như điện thoại thông minh, IoT, và các hệ thống nhúng. Các mô hình như Microsoft Phi-3, Google Gemma, và LLaMa.cpp đang mở ra khả năng chạy AI trực tiếp trên thiết bị mà không cần kết nối đám mây, giúp giảm độ trễ, tăng bảo mật dữ liệu và giảm chi phí hạ tầng.
Trong bài viết này, chúng ta sẽ khám phá tại sao SLMs quan trọng, các kiến trúc kỹ thuật phổ biến, và cách triển khai thực tế trên các nền tảng edge hiện nay.
Tại sao SLMs là xu hướng?
Các mô hình ngôn ngữ lớn (LLMs) như GPT-4 hoặc Claude 3 mang lại hiệu suất cao nhưng đòi hỏi tài nguyên tính toán lớn, thường chỉ chạy được trên GPU đám mây hoặc các server mạnh. Điều này tạo ra những hạn chế:
- Độ trễ cao do dữ liệu phải đi lại giữa thiết bị và máy chủ.
- Chi phí duy trì hạ tầng đám mây đắt đỏ.
- Nag lo về quyền riêng tư khi dữ liệu nhạy cảm phải được gửi lên đám mây.
SLMs giải quyết những vấn đề này bằng cách giảm kích thước mô hình xuống hàng chục đến hàng trăm triệu tham số, vẫn duy trì đủ khả năng hiểu và sinh ngôn ngữ cho nhiều trường hợp sử dụng cụ thể. Nhờ đó, chúng có thể chạy trên CPU của điện thoại, chip vi xử lý nhúng, hoặc các accelerator chuyên dụng như NPU.
Các kiến trúc SLM tiêu biểu
Nhiều nhà nghiên cứu và công ty đã phát triển các SLM với các phương pháp tối ưu khác nhau:
1. Knowledge Distillation
Phương pháp này huấn luyện một mô hình học sinh (student model) nhỏ hơn để học cách phản chiếu hành vi của một mô hình giáo viên (teacher model) lớn hơn. Kết quả là mô hình học sinh có kích thước nhỏ hơn nhưng vẫn giữ được phần lớn kiến thức của giáo viên. Ví dụ: DistilBERT là phiên bản nhỏ hơn của BERT được tạo bằng knowledge distillation.
2. Quantization
Giảm độ chính xác của các trọng số và kích hoạt từ số thực 32-bit xuống 16-bit, 8-bit, thậm chí 4-bit hoặc 2-bit. Quantization giúp giảm đáng kể kích thước bộ nhớ và tăng tốc độ suy luận mà ít ảnh hưởng đến độ chính xác. Các công cụ như GGUF (GPT-Generated Unified Format) được sử dụng rộng rãi để lưu trữ các mô hình LLaMa đã được quantization.
3. Pruning
Loại bỏ các kết nối (neuron hoặc lớp) không quan trọng trong mạng neural dựa trên các tiêu chí như độ đóng góp đến đầu ra hoặc gradient. Pruning giúp tạo ra mạng lưới mỏng hơn nhưng vẫn duy trì hiệu suất.
4. Các kiến trúc thiết kế đặc biệt
Một số SLM được thiết kế từ đầu để tối ưu cho edge, ví dụ:
- Microsoft Phi-3:gồm các mô hình: Phi-3-mini (3.8B tham số), Phi-3-small (7B), và Phi-3-medium (14B), được huấn luyện trên dữ liệu chất lượng cao và tối ưu cho cả CPU và GPU.
- Google Gemma: Gemma 2B và 7B là các mô hình mở nguồn từ Google, được thiết kế để chạy hiệu quả trên thiết bị có tài nguyên hạn chế.
- LLaMa.cpp: Không phải là một mô hình riêng mà là một framework cho phép quantization và chạy các mô hình LLaMa trên CPU với hiệu suất cao.
Triển khai SLM trên thiết bị edge
Để triển khai SLM trên thiết bị edge, người phát triển thường thực hiện các bước sau:
- Chọn mô hình phù hợp: Xác định nhu cầu về độ chính xác, kích thước, và tốc độ suy luận dựa trên trường hợp sử dụng.
- Chuyển đổi và quantization: Chuyển mô hình sang định dạng phù hợp (ví dụ: GGUF, ONNX, TensorFlow Lite) và thực hiện quantization nếu cần.
- Tối ưu hóa runtime: Sử dụng các engine suy luận như TensorRT, OpenVINO, hoặc llama.cpp để tối ưu hóa hiệu suất trên phần cứng cụ thể.
- Tích hợp vào ứng dụng: Triển khai mô hình như một phần của ứng dụng mobile hoặc embedded, sử dụng API cục bộ để thực hiện suy luận.
Các nền tảng phổ biến cho triển khai edge AI bao gồm:
- NVIDIA Jetson: Série board với GPU mạnh mẽ hỗ trợ CUDA và TensorRT, lý tưởng cho robotics và visão máy tính.
- Google Coral: Board có Edge TPU accelerator tối ưu cho TensorFlow Lite models.
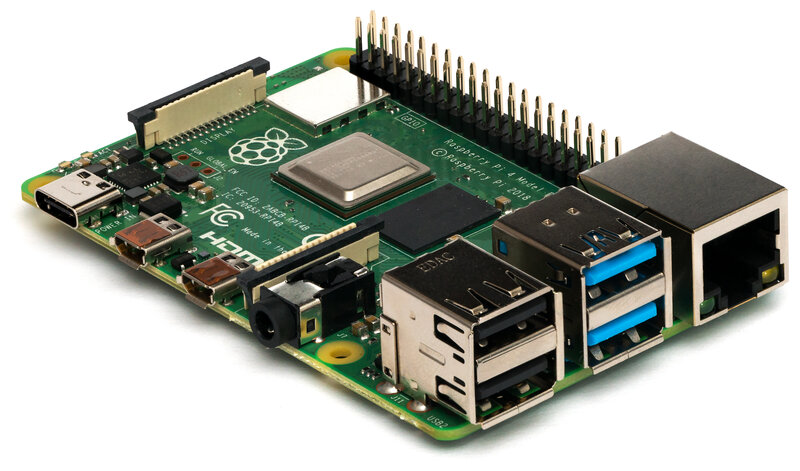
- Raspberry Pi: Với khả năng chạy các mô hình quantization qua CPU hoặc sử dụng các accelerator bên ngoài như Google Coral USB.
- Các chip điện thoại: Qualcomm Hexagon NPU, Apple Neural Engine, và Samsung NPs hỗ trợ chạy AI trên thiết bị di động.
Trường hợp sử dụng thực tế
SLMs đang được áp dụng rộng rãi trong nhiều ngành:
1. Trợ lý ảo cá nhân trên thiết bị
Các ứng dụng như asistente voce trên smartphone có thể xử lý các lệnh cơ bản (gọi điện, nhắc nhở, điều khiển nhà thông minh) trực tiếp trên thiết bị mà không cần internet, tăng độ riêng hồi và độ phản hồi nhanh.
2. Dịch và nhận dạng giọng nói realtime
Các ứng dụng dịch tiếng nước ngoài hoặc chuyển giọng nói thành văn bản có thể chạy trên thiết bị để bảo mật nội dung cuộc trò chuyện.
3. Kiểm soát chất lượng trong sản xuất
Trên dây chuyền sản xuất, SLM có thể phân tích hình ảnh từ camera để phát hiện lỗi sản phẩm trong thời gian thực, giúp giảm lãng phí và tăng hiệu quả.
4. Guvernánce và an toàn
Trong xe tự động lái, SLM có thể xử lý dữ liệu từ cảm biến để ra quyết định ngay lập tức mà không phụ thuộc vào kết nối mạng.
Thách thức và tương lai
Mặc dù SLM mang lại nhiều lợi thế, còn tồn tại một số thách thức:
- Cân bằng giữa kích thước mô hình và độ chính xác: việc làm nhỏ mô hình quá mức có thể dẫn đến giảm hiệu suất đáng kể.
- Hạn chế về bộ nhớ trên thiết bị rất nhỏ (microcontrollers).
- Cần có công cụ và framework tốt hơn để tối ưu hoá và triển khai trên đa dạng phần cứng.
Trong tương lai, chúng ta có thể mong đợi thấy:
- Các mô hình SLM đặc biệt cho từng ngành (y tế, tài chính, sản xuất).
- Cải thiện về hiệu suất năng lượng nhờ các chip AI chuyên dụng mới.
- Sự ra mắt của các tiêu chuẩn mở để triển khai AI trên edge một cách nhất quán.
- Kết hợp SLM với các phương pháp tính toán phân tán như federated learning để tăng cường bảo mật và tính mở rộng.
Kết luận
Small language models không chỉ là một xu hướng 기술 vorübergehend mà là một bước phát triển quan trọng trong việc lan tỏi công nghệ AI đến với milliards của thiết bị trên toàn thế giới. Nhờ khả năng chạy trực tiếp trên thiết bị, SLM mở ra cánh cửa cho các ứng dụng AI thời gian thực, bảo mật cao và chi phí thấp. Với sự phát triển liên tục về phần cứng, phần mềm và các kỹ thuật tối ưu hóa, SLM sẽ ngày càng đóng vai trò then chốt trong tương lai của AI trên edge.
Nếu bạn quan tâm đến triển khai AI trên thiết bị nhúng hoặc muốn khám phá cách SLM có thể giúp doanh nghiệp của bạn tối ưu hóa quy trình, hãy theo dõi các dự án như Phi-3, Gemma, và LLaMa.cpp để cập nhật những tiến bộ mới nhất.