B+ tree là gì? Đây là cấu trúc dữ liệu cây cân bằng tự thân, được dùng làm chỉ mục (index) mặc định trong hầu hết cơ sở dữ liệu quan hệ và hệ thống tệp. B+ tree mở rộng khái niệm cây nhị phân tìm kiếm (binary search tree) bằng cách cho phép mỗi nút có nhiều hơn hai nút con, từ đó giảm chiều cao cây xuống mức tối thiểu. Bài viết này giải thích nguyên lý hoạt động, lý do B+ tree thắng trong bối cảnh ổ cứng, và cách bạn dùng nó trong SQL thực tế.
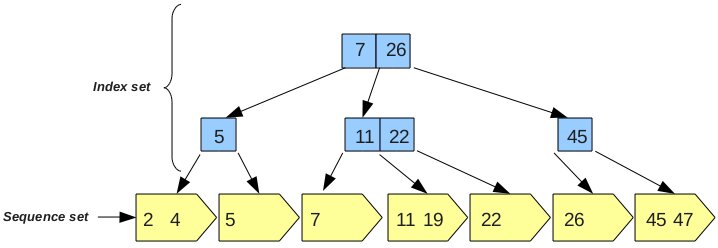
B+ tree là gì
B+ tree là một loại cây tìm kiếm cân bằng tự động, giữ dữ liệu luôn ở trạng thái sắp xếp và cho phép tìm kiếm, duyệt tuần tự, chèn và xoá trong thời gian logarithmic. Ý tưởng gốc do Rudolf Bayer và Edward McCreight đề xuất khi làm việc tại phòng thí nghiệm Boeing, nhằm quản lý các trang chỉ mục của những tệp truy cập ngẫu nhiên có dung lượng rất lớn. Bài báo gốc mang tên Organization and maintenance of large ordered indices, lưu hành nội bộ năm 1970 rồi công bố trên tạp chí Acta Informatica.
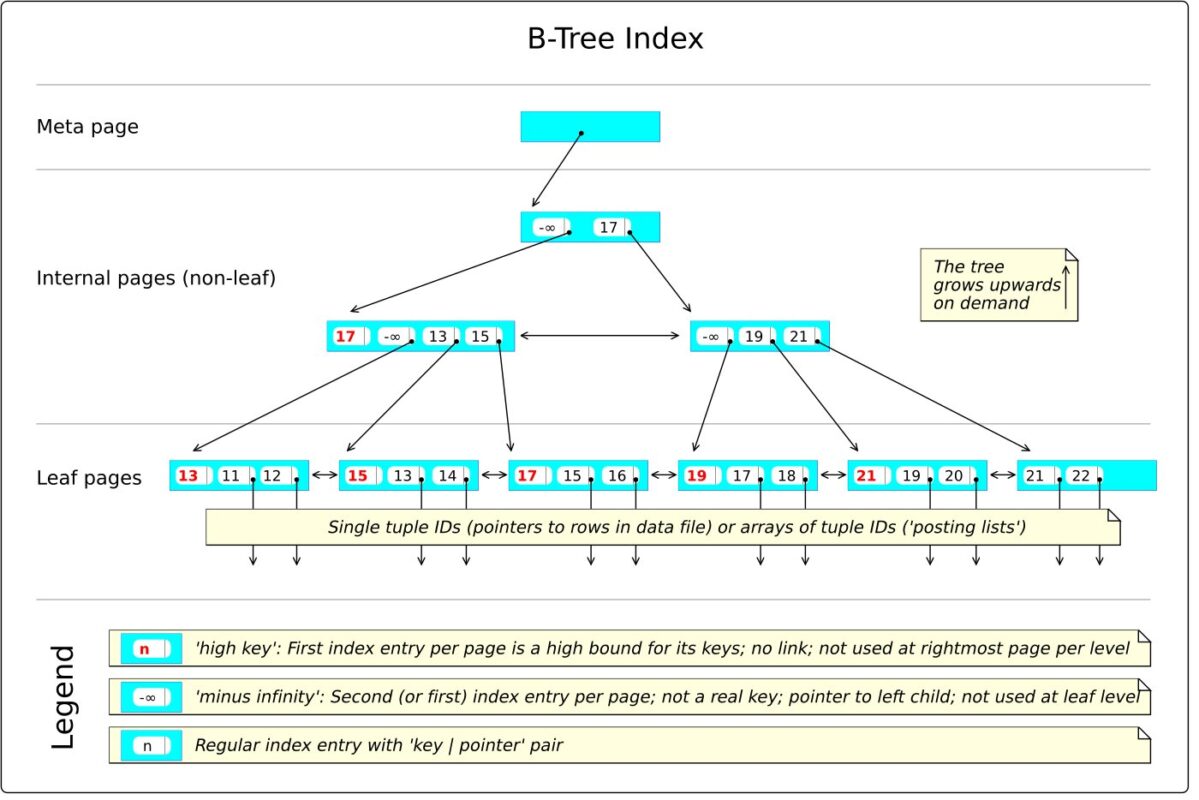
Khác biệt cốt lõi giữa B+ tree và B-tree cổ điển nằm ở chỗ: trong B+ tree, toàn bộ khóa (key) và dữ liệu đều nằm ở tầng lá, còn các nút nội bộ chỉ giữ khóa dùng làm mốc phân chia. Nhờ vậy các nút lá được nối thành một danh sách liên kết, nên quét toàn bộ bảng chỉ tốn thời gian tuyến tính và không phải quay lui trên cây. Đây là lý do B+ tree được chọn cho phần lớn thao tác quét bảng trong SQL.
Vì sao B+ tree phù hợp với dữ liệu lưu trên đĩa
Ổ cứng và SSD không tối ưu cho việc đọc từng byte lẻ. Chúng tối ưu cho việc đọc theo khối (page hoặc block) có dung lượng vài kilobyte. B+ tree được thiết kế đúng cho mô hình này: một nút thường được chọn kích thước vừa đúng bằng một khối đĩa, nên mỗi lần đọc đĩa là một lần nạp nguyên một nút chứa hàng chục tới hàng trăm khóa.
Chi phí thực tế của một lần tìm kiếm không phải là số phép so sánh, mà là số lần phải ra đĩa. Mỗi lần ra đĩa tốn hàng microsecond, trong khi so sánh trong bộ nhớ tốn vài nanosecond. Chính vì vậy B+ tree cố gắng giữ cây thấp: với khoá khoảng 20 và mỗi nút chứa 100 khóa, chỉ cần hai tầng là đủ bao phủ 10.000 bản ghi.
| Đặc điểm | Cây nhị phân tìm kiếm | B+ tree |
|---|---|---|
| Số nhánh tối đa mỗi nút | 2 | Hàng chục tới hàng trăm |
| Chiều cao cây | Log2(n), cao | Logm(n), thấp |
| Số lần đọc đĩa cho một lần tìm | Nhiều | Rất ít |
| Quét tuần tự toàn bộ cây | Phải quét lại từ gốc | Đi thẳng qua danh sách lá |
| Dữ liệu nằm ở đâu | Mọi nút | Chỉ ở tầng lá |
Cấu trúc và tính chất cân bằng
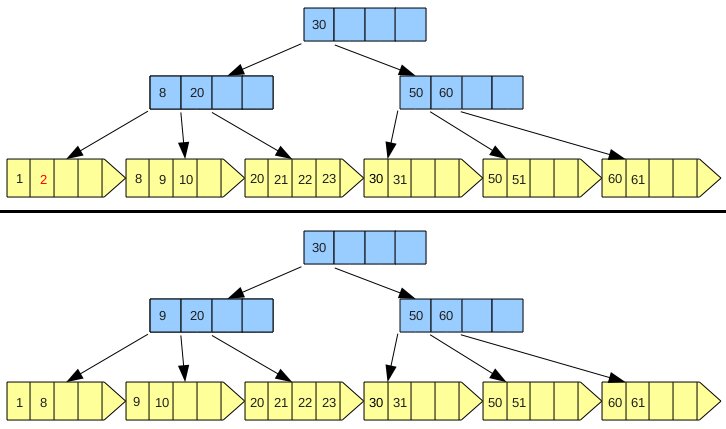
Theo định nghĩa của Knuth, một cây B+ tree bậc m thỏa các tính chất: mỗi nút có nhiều nhất m nút con; mọi nút trừ nút gốc và tầng lá có ít nhất ceil(m/2) nút con; nút gốc có ít nhất hai nút con trừ khi nó vốn là lá; và toàn bộ tầng lá nằm trên cùng một mức. Một nút không phải lá có k nút con thì chứa k trừ 1 khóa, và các khóa đó làm ranh giới cho các cây con: mọi giá trị bên trái khóa đầu nhỏ hơn khóa đó, giá trị giữa hai khóa nằm trong khoảng, và giá trị bên phải lớn hơn.
Ràng buộc trên làm cây tự cân bằng theo cơ chế. Khi một nút tràn, nó tách thành hai nút hợp lệ và đẩy một khóa lên nút cha. Ngược lại, khi một nút thiếu chỗ sau khi xoá, nó được gộp với nút anh em và mượn một khóa từ nút cha. Vì mọi nút luôn có tối thiểu một nửa chỗ trống nên cây không bao giờ suy biến thành một danh sách tuyến tính, kể cả khi dữ liệu được chèn hoàn toàn theo thứ tự tăng dần, trường hợp kinh điển làm cây nhị phân nhị phân suy biến.
Chi phí của mỗi thao tác chèn hoặc xoá là O(log n) về số nút phải đi qua, kèm một số lần tách hoặc gộp không đổi lượng. Một cây B+ tree bậc m giữ n khoá có chiều cao khoảng logm(n), và mỗi tầng thêm một tầng giúp chứa gấp m lần số phần tử so với tầng trước.
Các thao tác chính
Tìm kiếm điểm. Bắt đầu từ nút gốc, so sánh khóa cần tìm với các mốc trong nút để chọn nhánh con phù hợp, lặp lại cho tới tầng lá. Vì mọi tầng lá cùng độ sâu nên số bước đi luôn bằng chiều cao cây.
Quét theo khoảng. Tìm điểm bắt đầu như trên, sau đó đi theo danh sách liên kết giữa các nút lá. Với một bảng lớn, đây là con đường nhanh nhất và là lý do lệnh quét bảng có thể dùng index một cách hiệu quả.
Chèn. Đi tới lá đích. Nếu lá còn chỗ, chèn khóa tại đúng vị trí để giữ thứ tự. Nếu đầy, tách lá thành hai, phân bổ lại khóa và đẩy khóa phân cách lên tầng trên, lặp lại nếu nút cha cũng tràn.
Xoá. Xoá ở tầng lá. Nếu nút lá rơi xuống dưới ngưỡng tối thiểu, gộp với nút anh em kề bên và điều chỉnh con trỏ ở nút cha.
B+ tree trong thực tế với cơ sở dữ liệu
PostgreSQL dùng B-tree làm kiểu chỉ mục mặc định, mở rộng thêm so với mô hình gốc. MySQL và MariaDB cũng chọn B+ tree cho InnoDB. Những gì cơ sở dữ liệu thêm vào gồm chỉ mục không duy nhất, chỉ mục toàn cục, kiểu chỉ mục trên biểu thức và khả năng tìm kiếm theo khoảng thay vì chỉ tiền tố.
Hệ quả thực hành rất quan trọng: một chỉ mục B+ tree trên cột email giúp tìm nhanh khi truy vấn có điều kiện bằng, nhưng gần như vô dụng với điều kiện không bằng như LIKE '%abc' hay một hàm bao quanh cột như LOWER(email), vì khi đó thứ tự trong chỉ mục không còn khớp với thứ tự giá trị thực. Muốn dùng được, bạn phải tạo chỉ mục trên biểu thức đúng với biểu thức truy vấn.
Bạn có thể xem chiều cao cây chỉ mục của mình bằng cách xem từ khoá btree trong kết quả EXPLAIN. Con số này cho biết cấp độ của cây, và nó là chỉ báo trực tiếp cho việc truy vấn có đang phải ra đĩa nhiều lần hay không. Chỉ số thường từ 3 trở xuống là ổn với bảng trên đĩa.
Một lưu ý về thiết kế: chỉ mục B+ tree không miễn phí. Mỗi lần chèn, xoá hoặc cập nhật đều phải ghi lại các nút trên đường đi, và những nút đó có thể không còn đủ chỗ, dẫn tới tách trang và phân mảnh. Cũng vì vậy một bảng có nhiều chỉ mục sẽ chậm ghi kể cả tìm nhanh hơn. Chọn chỉ mục luôn bắt đầu từ câu hỏi truy vấn nào thực sự cần nó, không phải từ mọi cột đều có thể lọc.
Chi tiết về mô hình B-tree và lịch sử phát triển được ghi trong bài B-tree trên Wikipedia. Nếu muốn đi sâu vào phần chỉ mục của PostgreSQL, hãy xem tài liệu chính thức B-tree của PostgreSQL, phần này mô tả rõ cách tách trang, cách dùng chỉ mục một phần và cách bảo đảm VACUUM hoạt động đúng trên cấu trúc này.