Redis là gì và vì sao nó xuất hiện trong gần như mọi kiến trúc backend hiện đại? Câu trả lời nằm ở hai đặc điểm: toàn bộ dữ liệu nằm trong RAM, và Redis dùng mô hình dữ liệu đơn giản đến mức tốn rất ít thời gian xử lý. Kết quả là thao tác đọc ghi tính bằng micro giây, nhanh hơn cơ sở dữ liệu quan hệ truyền thống một đẵng cấp.
Bài viết này phân tích kiến trúc nội bộ, các kiểu dữ liệu, cấu hình Sentinel và Cluster, đồng thời chỉ ra những lỗi phổ biến khiến nhiều đội dùng Redis sai cách rồi mất dữ liệu ngoài ý muốn.
Redis là gì
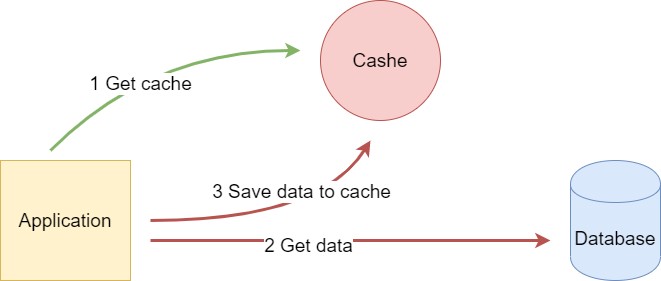
Redis là gì — đó là một kho dữ liệu key-value mã nguồn mở, lưu dữ liệu trong bộ nhớ. Dự án bắt đầu từ năm 2009 bởi Salvatore Sanfilippo, hiện được quản lý bởi Redis Ltd và dưới giấy phép BSD. Redis phục vụ ba vai trò chính: cache phía trước cơ sở dữ liệu chính, hàng đợi tin nhắn (pub/sub, stream) và cấu trúc dữ liệu phong phú như bộ đếm, hash, tập hợp có thứ tự.
Điểm khác biệt so với Memcached: Redis không chỉ lưu sống và quên. Nó hỗ trợ ghi file snapshot xuống đĩa theo chu kỳ và nhật ký append-only, nhờ vậy có thể phục hồi dữ liệu sau khi server sập.
Mô hình đơn luồng và vì sao nhanh
Redis xử lý lệnh trong một vòng lặp đơn luồng. Không có khoá, không có cơ chế phân trang, không cạnh tranh giữa các luồng. Chỉ có một lệnh được thực thi tại một thời điểm, và điều đó loại bỏ gần như toàn bộ độ trễ do phân vị CPU và đồng bộ khoá.
Nhưng cái giá phải trả là mọi lệnh nặng đều chặn toàn bộ server. Một KEYS * trên tập dữ liệu vài triệu key có thể đóng băng Redis hàng giây. Cùng lý do đó, Redis không hỗ trợ truy vấn phức tạp kiểu SQL — kết nối lâu vào database là sai lầm thiết kế.
Tám kiểu dữ liệu và khi nào dùng
| Kiểu | Cấu trúc | Dùng cho |
|---|---|---|
| String | Chuỗi byte tối đa 512 MB | Cache HTML, JSON, số đếm |
| Hash | Bảng băm field giá trị | Profile người dùng, thuộc tính sản phẩm |
| List | Mảng hai đầu | Hàng đợi đơn giản, danh sách bài gần đây |
| Set | Tập hợp không thứ tự | Tag bài viết, thành viên nhóm, theo dõi |
| Sorted Set | Tập hợp có điểm số | Bảng xếp hạng, bảng giá cổ phiếu |
| Bitmap | Chuỗi bit | Đánh dấu đã đọc, thống kê hoạt động |
| HyperLogLog | Bộ đếm xấp xỉ | Ước lượng số người truy cập duy nhất |
| Stream | Log có vùi nhận | Hàng đợi bền vững, event sourcing nhẹ |
Chọn đúng kiểu dữ liệu quyết định hiệu năng. Ví dụ lưu bộ đếm lượt xem bằng INCR rẻ hơn nhiều so với GET rồi tăng rồi SET, vì lệnh chạy trong O(1) và không cần round-trip.
Quy tắc bộ nhớ và cấu hình loại bỏ
Cache chết không phải lỗi, vấn đề chỉ xuất hiện khi bộ nhớ đầy mà không có cơ chế loại bỏ hợp lý. Redis cung cấp sẵn nhiều chính sách, và lựa chọn sai thường gây mất dữ liệu khi đang cần nó nhất.
maxmemory 256mb
maxmemory-policy allkeys-lru
Với allkeys-lru, khi đạt giới hạn, Redis loại bỏ key được dùng gần nhất lâu nhất, kể cả key gốc. Với volatile-lru, chỉ những key có TTL mới bị loại — phù hợp khi bạn coi Redis là cache và muốn dữ liệu không TTL được bảo vệ. Lựa chọn phổ biến cho hệ thống cache thuần là allkeys-lru và allkeys-lfu, vì noeviction sẽ khiến lệnh ghi báo lỗi khi đầy bộ nhớ.
Redis Cluster và phân mảnh dữ liệu
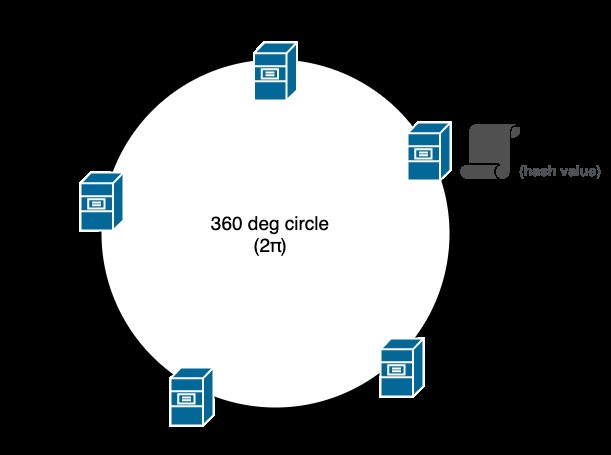
Một node Redis đơn lẻ là điểm chết cứng. Cluster giải quyết bằng cách chia key theo 16384 slot, mỗi slot thuộc một nút, và nhân bản mỗi nút thành primary cùng một hoặc nhiều replica. Khi primary chết, tự động failover sang replica trong vài giây.
Ứng dụng kết nối vào một nút bất kỳ, nút đó chuyển tiếp lệnh đến nút chịu trách nhiệm slot cần truy cập nếu có. Người dùng không cần biết key nào nằm ở đâu, nhưng vẫn cần nhớ rằng mọi lệnh MULTI hay script Lua chỉ chạy được trong một slot, nên thiết kế key nên gắn hashtag ví dụ user:{123}:profile để nhóm các key liên quan cùng nằm trên một nút.
Sentinel và độ sẵn sàng cao
Redis Sentinel là lựa chọn nhẹ hơn cho hệ thống không cần sharding. Nó giám sát các node chính, tự động chuyển đổi khi node lỗi và thông báo cho ứng dụng qua địa chỉ mới. Kiến trúc điển hình gồm ba Sentinel theo dõi nhau để tránh điểm chết đơn lẻ, với nguyên tắc đạt được khi đa số đồng ý thì mới failover.
Khi nào không nên dùng Redis
- Cần truy vấn phức tạp, join, báo cáo nhiều chiều — hãy dùng cơ sở dữ liệu quan hệ.
- Không chấp nhận mất dữ liệu khi sập và chưa cấu hình bền vững — bật RDB hoặc AOF trước.
- Tập dữ liệu vượt quá RAM — Redis không tự spill xuống đĩa như một số cấu hình của SQL Server.
- Cần độ trễ dưới một phần triệu giây ở quy mô lớn — hãy dùng lưu trữ bên trong tiến trình.
- Dữ liệu nhạy cảm không được mã hoá — Redis chạy không mã hoá mặc định, cần kích hoạt TLS và mã hoá ở tầng ứng dụng.
Bảo mật và vận hành
Đừng mở cổng 6379 ra toàn Internet. Thiết lập requirepass hoặc ACL theo user, chỉ cho phép truy cập từ mạng nội bộ, và bật TLS nếu traffic đi qua internet. Đồng thời giám sát chỉ số chính: used_memory so với maxmemory, tỉ lệ keyspace_misses, độ trễ p99 và số client đang kết nối. Tỉ lệ miss cao bất thường thường báo hiệu cache đang bị xoá sạch liên tục.
Việc KEYS trên môi trường thật là sai lầm nghiêm trọng và bị chặn trong các bản Redis mới. Hãy dùng SCAN để duyệt dần, hoặc UNLINK thay vì DEL để không chặn luồng.
Kết luận
Trả lời lại câu hỏi ban đầu: Redis là gì — đó là một kho key-value trong bộ nhớ, đồng thời là cache, hàng đợi và kho cấu trúc dữ liệu. Giá trị lớn nhất của nó nằm ở tốc độ và sự đơn giản; giới hạn lớn nhất nằm ở việc dữ liệu nằm trong RAM và mọi lệnh nặng đều chặn server. Dùng Redis đúng lúc, đúng cách, nó là viên gạch nền của hầu hết hệ thống web tốc độ cao.
Tài liệu chính thức nằm tại trang Redis Documentation, phần Memory Optimization giải thích chi tiết chính sách loại bỏ và cấu trúc dữ liệu tiết kiệm bộ nhớ. Bạn cũng nên xem Redis Sentinel Documentation nếu đang cân nhắc mô hình master-replica.