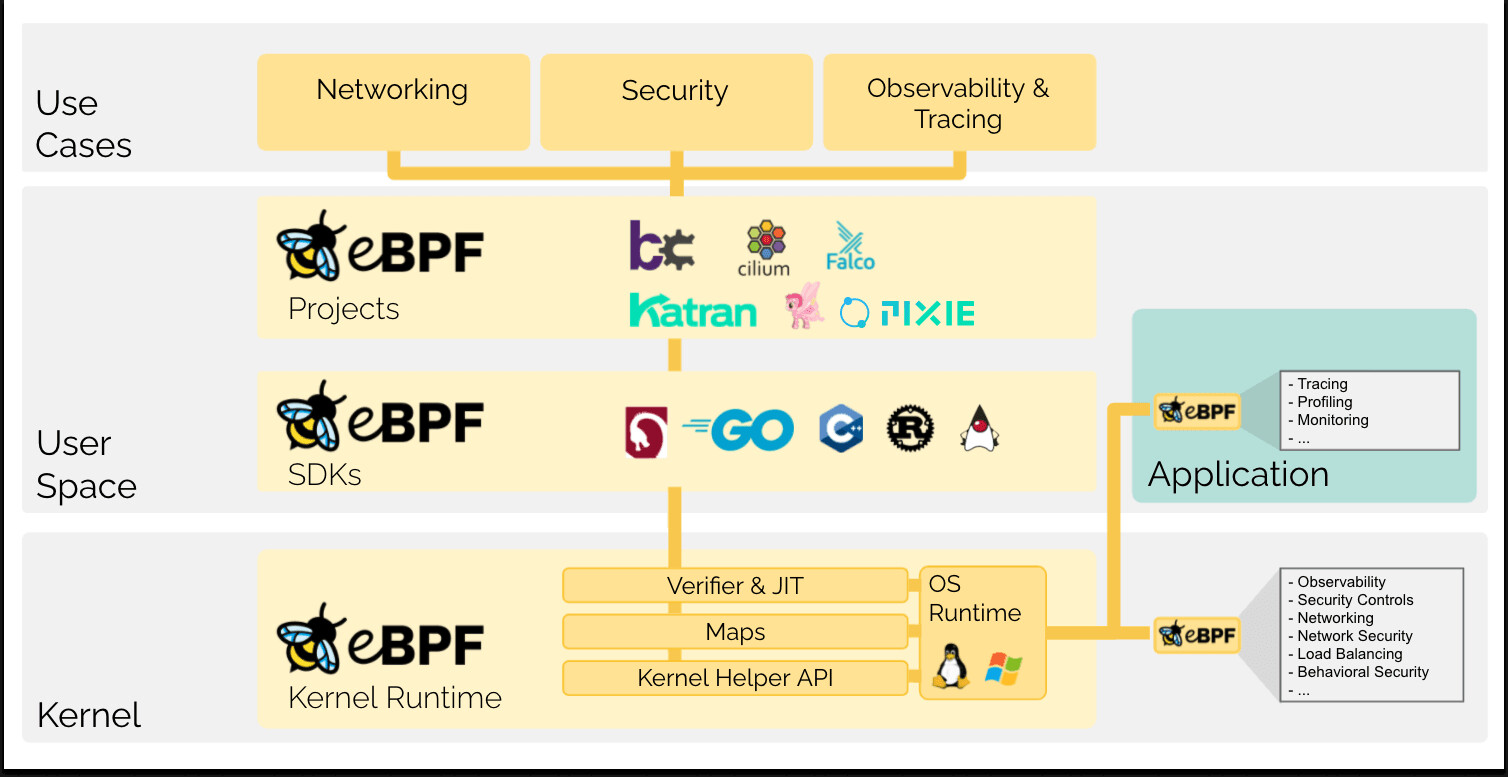
eBPF là gì? eBPF (extended Berkeley Packet Filter) là công nghệ cho phép chạy các chương trình nhỏ gọn, an toàn ngay bên trong nhân Linux mà không cần sửa mã nguồn kernel hay biên dịch lại toàn bộ hệ điều hành. Ban đầu eBPF được thiết kế để lọc gói tin mạng, nhưng ngày nay nó đã trở thành nền tảng cho rất nhiều công cụ hạ tầng hiện đại như quan sát hệ thống, bảo mật runtime, tường lửa và mạng container.
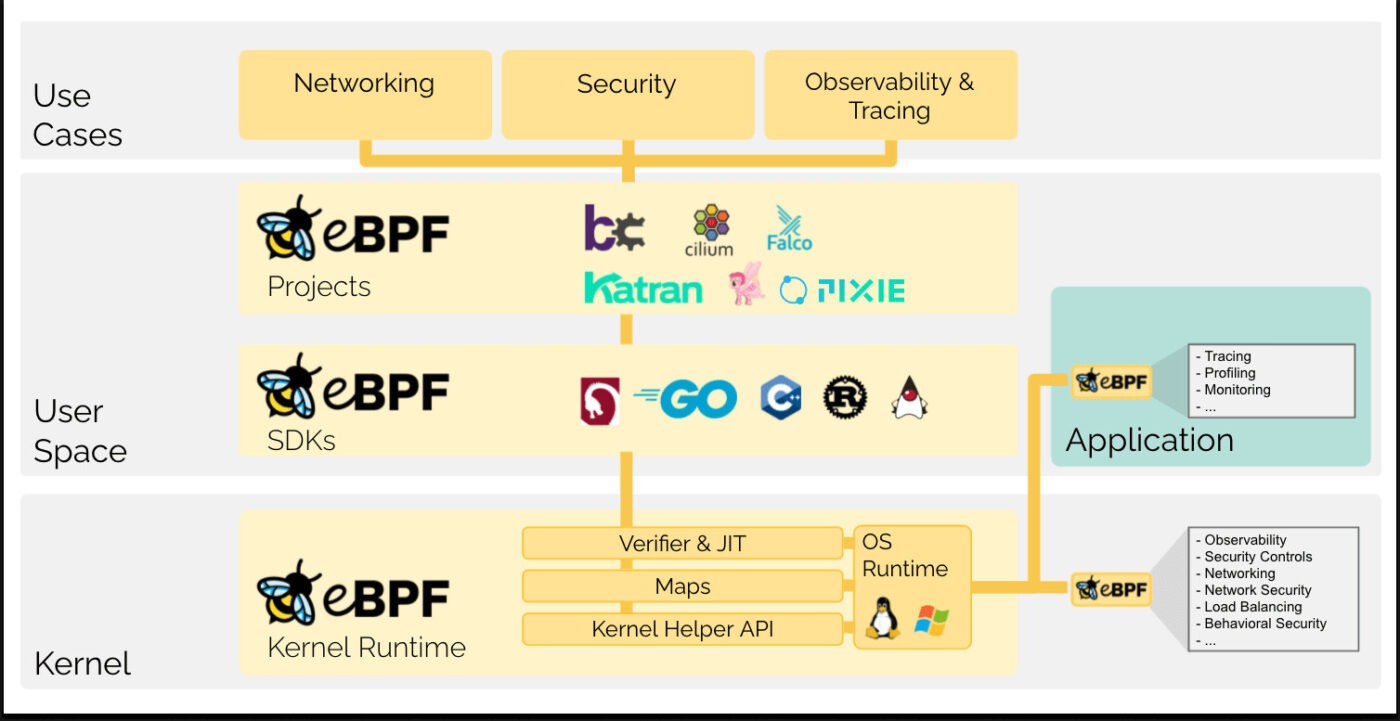
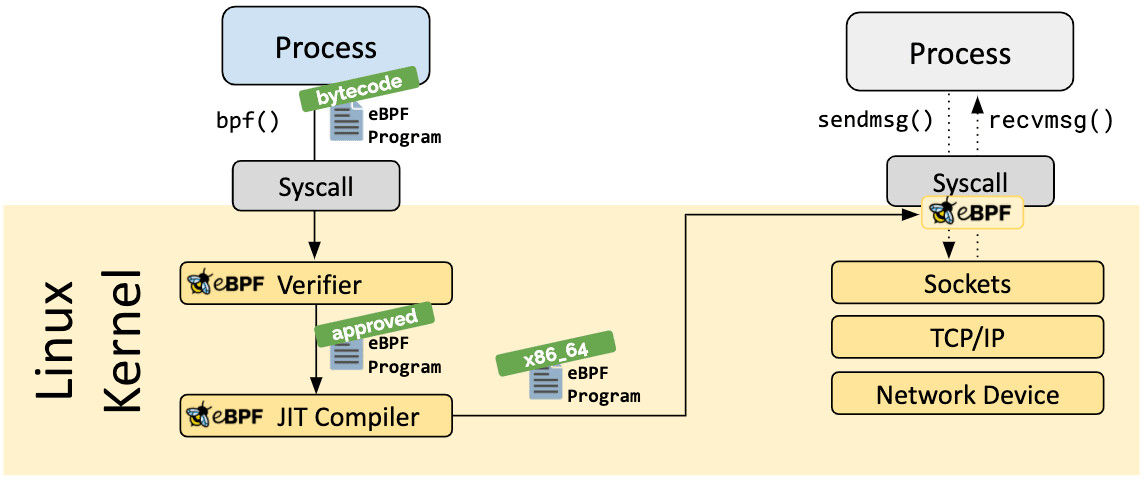
Điểm khác biệt cốt lõi của eBPF so với các cách lập trình kernel truyền thống là an toàn theo thiết kế. Mọi chương trình eBPF đều phải vượt qua một bộ kiểm tra gọi là verifier trước khi được phép chạy. Verifier phân tích mã bytecode để đảm bảo chương trình không gây treo máy, không truy cập vùng nhớ ngoài quyền, và luôn kết thúc trong thời gian hữu hạn. Chỉ sau khi vượt qua bước này, bytecode mới được biên dịch bởi JIT compiler thành mã máy gốc và gắn vào các điểm móc (hook) bên trong kernel.
eBPF giải quyết vấn đề gì?
Trước khi có eBPF, để theo dõi hoặc thay đổi hành vi của nhân Linux, lập trình viên chỉ có ba lựa chọn:
- Viết kernel module: mạnh nhưng rủi ro. Một module lỗi có thể làm sập cả hệ thống, và phải biên dịch lại cùng ký lại module mỗi lần thay đổi trên máy chủ production.
- Dùng ptrace hoặc LD_PRELOAD: an toàn hơn nhưng rất chậm, vì mỗi lần gọi hệ thống đều phải chuyển ngữ cảnh sang và về giữa không gian người dùng và không gian kernel.
- Nâng cấp kernel lên bản mới hơn: chậm chạp, phụ thuộc bên thứ ba, và nhiều thay đổi bảo mật quan trọng không được đưa xuống các bản dài hỗ trợ doanh nghiệp.
eBPF cắt ngang vấn đề này. Nhờ JIT, chương trình eBPF chạy với tốc độ gần bằng kernel module thông thường, nhưng lại được cô lập và kiểm soát chặt chẽ hơn nhiều. Chính vì vậy ngay cả khi chương trình bị lỗi, hệ thống vẫn không bị sập, chỉ mất hiệu năng tạm thời.
Ba thành phần chính của eBPF
1. Chương trình ở không gian người dùng
Chương trình eBPF được viết bằng C hoặc Rust, sau đó biên dịch bằng Clang/LLVM với target bpf thành một tệp bytecode. Từ bytecode này, chương trình được nạp vào kernel thông qua lời gọi hệ thống bpf().
2. Verifier trong nhân Linux
Verifier là hàng rào bảo mật quan trọng nhất. Nó duyệt từng lệnh bytecode, theo dõi trạng thái của mọi thanh ghi và con trỏ, rồi từ chối toàn bộ chương trình nếu phát hiện bất kỳ đường đi nào có thể gây hại. Nhờ đó, một chương trình eBPF bị lỗi chỉ bị từ chối tải lên, chứ không làm sập máy chủ.
3. JIT compiler và các hook
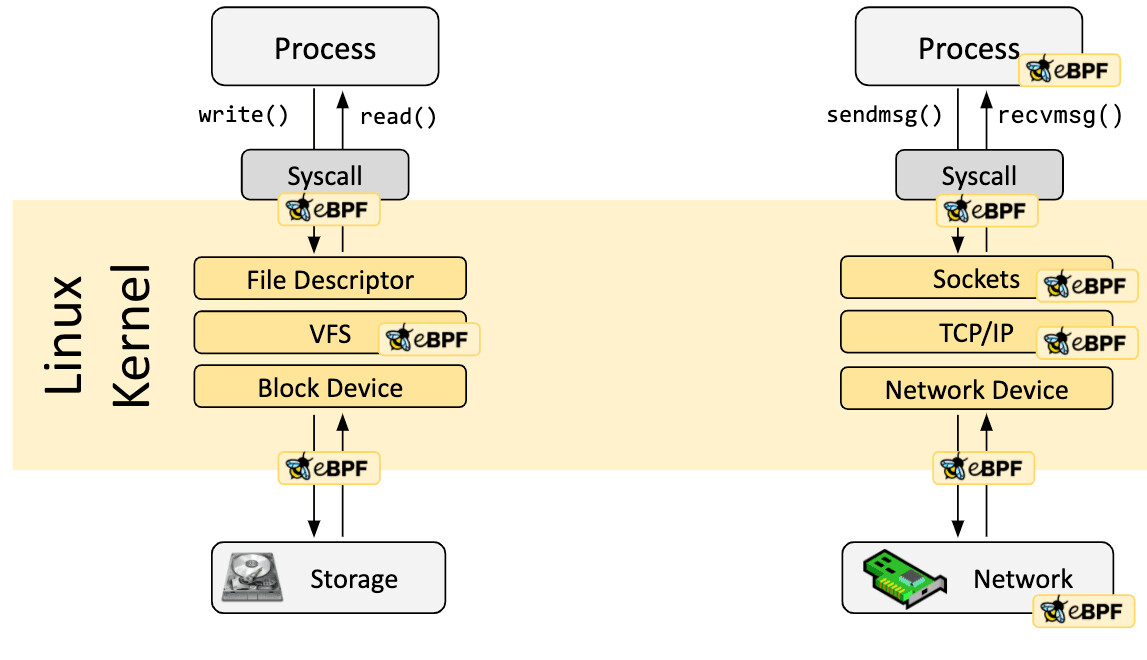
Sau khi verifier chấp thuận, JIT compiler dịch bytecode thành mã máy gốc của kiến trúc CPU đang chạy. Mã này được gắn vào một trong rất nhiều hook bên trong kernel, ví dụ khi tiến trình gọi một syscall, khi gói tin đi qua card mạng, hoặc khi một tệp tin được mở ra.
Verifier hoạt động như thế nào?
Verifier không chỉ kiểm tra từng lệnh một, mà theo dõi trạng thái tại mọi nhánh điều khiển. Ví dụ, khi chương trình đọc một giá trị từ bộ nhớ dùng chung, verifier yêu cầu biết trước giá trị đó có hợp lệ hay không. Nếu không chắc chắn, nó đòi bổ sung một nhánh kiểm tra tường minh (explicit bounds check) trước khi sử dụng con trỏ.
Cơ chế này giải quyết những lỗ hổng kinh điển của mã hệ thống. Chẳng hạn, lỗ hổng Heartbleed năm ngoái là do đọc quá số byte từ bộ đệm, một loại lỗi mà eBPF gần như không thể mắc phải vì verifier chặn ngay từ khi tải chương trình.
Có ba loại chương trình eBPF cơ bản:
- Tracepoint program: gắn vào các điểm dấu vết có sẵn trong kernel, chi phí thấp nhất.
- kprobe và uprobe program: gắn vào bất kỳ hàm nào trong kernel hoặc trong binary người dùng, linh hoạt hơn nhưng có chi phí cao hơn một chút.
- LSM program: gắn vào khung bảo mật Linux Security Module, cho phép chặn hoặc sửa đổi một thao tác trước khi nó được thực thi.
Bản đồ và helper function: hai khái niệm cần biết
Chương trình eBPF không thể tự do truy cập bộ nhớ. Mọi thao tác phải thông qua map, một cấu trúc dữ liệu do kernel quản lý dùng chung giữa không gian kernel và không gian người dùng. Các loại map phổ biến gồm hash map, array, LRU hash map và ring buffer, mỗi loại phù hợp với một kiểu bài toán khác nhau.
Ngoài ra, chương trình eBPF chỉ được gọi các hàm trợ giúp (helper function) do kernel cung cấp, chẳng hạn bpf_map_lookup_elem để tra cứu phần tử trong map, hay bpf_trace_printk để in thông tin ra ring buffer. Danh sách helper được giới hạn và có sẵn trong tài liệu chính thức, đảm bảo chương trình không thể làm hỏng hệ thống.
Một giới hạn đáng lưu tâm là kích thước chương trình. Verifier giới hạn số lệnh thực thi theo một đường đi tuyến tính, hiện khoảng một triệu lệnh. Đây là lý do các chương trình eBPF phức tạp thường được chia thành nhiều chương trình nhỏ nối tiếp bằng cơ chế tail call.
Ứng dụng thực tế của eBPF
Ngày nay eBPF xuất hiện trong rất nhiều sản phẩm quen thuộc:
- Quan sát hiệu năng: bộ công cụ BCC (BPF Compiler Collection) cung cấp các lệnh như
opensnoop,biosnoop,execsnoopđể theo dõi hoạt động I/O và tiến trình mà không cần sửa ứng dụng. Nền tảng bpftrace cho phép viết script theo dõi bằng cú pháp gần giống AWK. - Bảo mật runtime: Falco và Tetragon sử dụng eBPF LSM hook để phát hiện hành vi bất thường như một tiến trình thực thi tệp nhị phân chưa được cho phép, hoặc tạo kết nối ra ngoài một danh sách cho phép.
- Mạng và service mesh: Cilium dùng eBPF thay cho iptables và iptables mở rộng, xử lý hàng triệu kết nối với mức tiêu thụ CPU thấp hơn nhiều.
- Quản lý container: các giải pháp như Inspektor Gadget hay Kubernetes runtime security đều xây dựng trên nền tảng eBPF.
So sánh eBPF với các lựa chọn khác
| Tiêu chí | eBPF | Kernel module | ptrace |
|---|---|---|---|
| Độ an toàn | Cao, có verifier | Thấp, lỗi làm sập máy | Cao |
| Hiệu năng | Gần module | Gần module | Thấp |
| Cập nhật nóng | Có | Cần biên dịch lại | Không áp dụng |
| Không cần đặc quyền root | Không, vẫn cần | Không | Không |
| Số lượng chương trình đồng thời | Rất nhiều | Ít | Trung bình |
Nói ngắn gọn, eBPF thắng ở cả ba tiêu chí quan trọng nhất: an toàn, hiệu năng và khả năng triển khai linh hoạt. Đổi lại, lập trình viên phải tuân theo một bộ ràng buộc nghiêm ngặt của verifier và viết bằng một tập lệnh riêng, không phải C thông thường.
Bắt đầu với eBPF
Cài đặt bộ công cụ cơ bản trên Ubuntu hoặc Debian:
# Cài Clang/LLVM và các thư viện hỗ trợ
sudo apt-get install -y clang llvm libelf-dev libbpf-dev linux-headers-$(uname -r)

# Kiểm tra phiên bản kernel, cần từ 4.1 trở lên
uname -r
Chương trình eBPF tối giản đếm số lần hệ thống được gọi:
#include <linux/bpf.h>
#include <bpf/bpf_helpers.h>
#include <bpf/bpf_tracing.h>

SEC("tracepoint/syscalls/sys_enter_execve")
int count_exec(struct trace_event_raw_sys_enter *ctx) {
    bpf_printk("mot tien trinh moi duoc thuc thi\n");
    return 0;
}

char LICENSE[] SEC("license") = "GPL";
Biên dịch rồi nạp vào kernel:
clang -O2 -g -target bpf -D__TARGET_ARCH_x86 -c count_exec.c -o count_exec.o
bpftool prog load count_exec.o /sys/fs/bpf/count_exec
bpftool prog show pinned /sys/fs/bpf/count_exec
Sau khi nạp xong, có thể theo dõi log với bpftool prog run hoặc dùng bpftrace để tương tác linh hoạt hơn mà không cần biên dịch lại.
Kinh nghiệm thực hành
Dù eBPF rất mạnh, có vài điểm nên lưu ý khi triển khai trong môi trường thật:
- Bắt đầu từ tracepoint thay vì kprobe, vì chi phí thấp hơn hẳn.
- Luôn có đường lùi: một chương trình eBPF lỗi có thể làm tăng tải CPU đột ngột. Hãy giới hạn số chương trình chạy đồng thời và theo dõi overhead khi mới triển khai.
- Cân nhắc chi phí dữ liệu: kernel gửi dữ liệu qua ring buffer sang không gian người dùng. Nếu chương trình ghi quá nhiều, chính nó sẽ trở thành nút thắt cần tối ưu.
- Kiểm tra phiên bản kernel: các loại map và hook mới hơn chỉ có từ một số phiên bản nhất định trở đi.
Kết luận
eBPF đã thay đổi cách chúng ta xây dựng công cụ hạ tầng trên Linux. Nhờ kết hợp giữa mô hình bảo mật tập trung của verifier và tốc độ gần bằng mã kernel được biên dịch, eBPF cho phép thêm khả năng quan sát, kiểm soát và bảo mật vào hệ thống đang chạy mà không cần khởi động lại hay biên dịch lại kernel.
Đối với kỹ sư vận hành hệ thống, đây là kỹ năng đáng đầu tư: nó vừa giải quyết được những bài toán vốn rất tốn công theo cách truyền thống, vừa mở ra một lớp công cụ mới mà các hãng lớn như Google, Meta, Netflix và Microsoft đều đã triển khai ở quy mô lớn trong hạ tầng của họ.
Tài liệu tham khảo
- Trang chủ eBPF Foundation: ebpf.io
- Tài liệu eBPF của Cilium: docs.cilium.io
- Bộ công cụ BCC: github.com/iovisor/bcc
- Các công cụ hiệu năng BPF của Brendan Gregg: brendangregg.com/ebpf