DuckDB là hệ thống quản lý CSDL quan hệ định hướng cột (column-oriented RDBMS) mã nguồn mở, được thiết kế để tối ưu hiệu năng cho các truy vấn phức tạp trên cơ sở dữ liệu nhúng. DuckDB chuyên biệt cho workload phân tích OLAP — tức đọc và tổng hợp lượng dữ liệu lớn — thay vì các thao tác giao dịch OLTP đòi hỏi ghi nhiều như PostgreSQL hay MySQL. Cùng một câu lệnh SQL, DuckDB có thể xử lý bảng có hàng trăm cột và hàng tỷ dòng ngay trong RAM của tiến trình đang chạy.
Điểm khác biệt lớn nhất của DuckDB so với phần lớn CSDL là mô hình in-process. Thay vì phải khởi động một máy chủ CSDL riêng rồi kết nối qua socket hoặc TCP, DuckDB chạy ngay bên trong tiến trình ứng dụng. Nhờ vậy, việc phân tích một tập tin CSV hay Parquet vài gigabyte diễn ra trong mili giây, không tốn thêm một máy chủ nào cả. Đây là lý do DuckDB được ví như “SQLite của thế giới phân tích dữ liệu”.
Lịch sử phát triển
DuckDB được tạo ra bởi hai nhà nghiên cứu Mark Raasveldt và Hannes Mühleisen tại Viện Toán học và Khoa học máy tính Centrum Wiskunde & Informatica (CWI) ở Hà Lan. Bản phát hành đầu tiên ra mắt năm 2019 với mục tiêu rõ ràng: xây dựng một CSDL OLAP chạy trong tiến trình, khắc phục khoảng trống giữa các công cụ phân tích quy mô lớn tốn kém tài nguyên và các thư viện xử lý dữ liệu nhẹ nhưng yếu về truy vấn. Phiên bản 1.0.0 được phát hành vào tháng 6 năm 2024 với mã hiệu SnowDuck, đánh dấu cột mốc dự án đã ổn định đủ để dùng trong sản xuất.
Hiện dự án được quản lý bởi DuckDB Foundation, một tổ chức phi lợi nhuận độc lập nắm giữ phần lớn quyền sở hữu trí tuệ của dự án và được tài trợ bằng quyên góp. Điều khoản của quỹ cam kết giữ DuckDB mã nguồn mở theo giấy phép MIT vĩnh viễn, đảm bảo dự án không bị thương mại hóa hoàn toàn. Công ty DuckLabs của đồng tác giả Hannes Mühleisen cũng tuyên bố không nhận vốn đầu tư mạo hiểm, với lý do muốn giữ hướng phát triển của dự án nằm trong tay cộng đồng thay vì bị áp lực thương mại hóa. Dự án hiện ghi nhận hơn 6 triệu lượt tải mỗi tháng và được các công ty lớn như Meta, Google và Airbnb sử dụng cho công việc phân tích nội bộ.
Kiến trúc và tính năng nổi bật
DuckDB dùng engine xử lý truy vấn vector hóa (vectorized query execution). Thay vì xử lý từng ô dữ liệu một, engine gom một lô hàng trăm giá trị cùng kiểu rồi áp dụng phép tính lên cả lô bằng vector hóa SIMD của CPU. Cách này giảm mạnh chi phí gọi hàm và tận dụng được đường ống dữ liệu của bộ xử lý hiện đại, chính là nơi phần lớn CSDL truyền thống thường thua thiệu về tốc độ quét bảng.
Điểm đáng chú ý khác là DuckDB không có bất kỳ phụ thuộc bên ngoài nào và có thể biên dịch chỉ bằng một trình biên dịch C++17. Bộ phân tích cú pháp SQL của DuckDB bắt nguồn từ thư viện pg_query, vốn được xây dựng từ bộ phân tích cú pháp PostgreSQL đã bỏ bớt, giúp tương thích cú pháp gần như toàn diện với PostgreSQL. Dự án cũng biên dịch được DuckDB sang WebAssembly bằng công cụ emscripten, cho phép chạy truy vấn SQL ngay trong trình duyệt — một tính năng hay xuất hiện trong các công cụ phân tích dữ liệu nhúng trực tuyến.
| Tính năng | Mô tả |
|---|---|
| Định dạng lưu trữ | File đơn, tối ưu cho quét hàng loạt, chèn và xóa khối dữ liệu |
| Mô hình chạy | In-process, không cần máy chủ CSDL riêng |
| Hệ sinh thái ngôn ngữ | Python, R, C, C++, Java, Node.js, Go, Rust, Swift qua thư viện binding |
| Định dạng đọc trực tiếp | CSV, Parquet, JSON, Arrow, và các bảng ngoài qua httpfs |
| Extension | Hơn 30 extension cộng đồng, hỗ trợ geospatial, Delta Lake, Iceberg, Kafka |
Kiến trúc mở rộng của DuckDB cho phép nạp thêm chức năng lúc chạy. Extension lõi do đội ngũ lõi duy trì gồm httpfs cho phép truy cập file từ xa qua HTTP, HTTPS và kho đối tượng tương thích S3; spatial cung cấp hệ hàm không gian ST_*, trong đó kiểu GEOMETRY đã trở thành kiểu dữ liệu lõi; iceberg hỗ trợ đọc ghi bảng Apache Iceberg; delta kết nối với Delta Lake thông qua Delta Kernel; và ducklake định dạng lakehouse lưu toàn bộ siêu dữ liệu trong CSDL SQL với ngữ nghĩa ACID, hỗ trợ time travel và phát triển schema. Ngoài ra còn có hơn 30 extension do cộng đồng đảm bảo, trải rộng từ truy vấn đồ thị SQL/PGQ đến tích hợp Kafka và suy luận học máy.
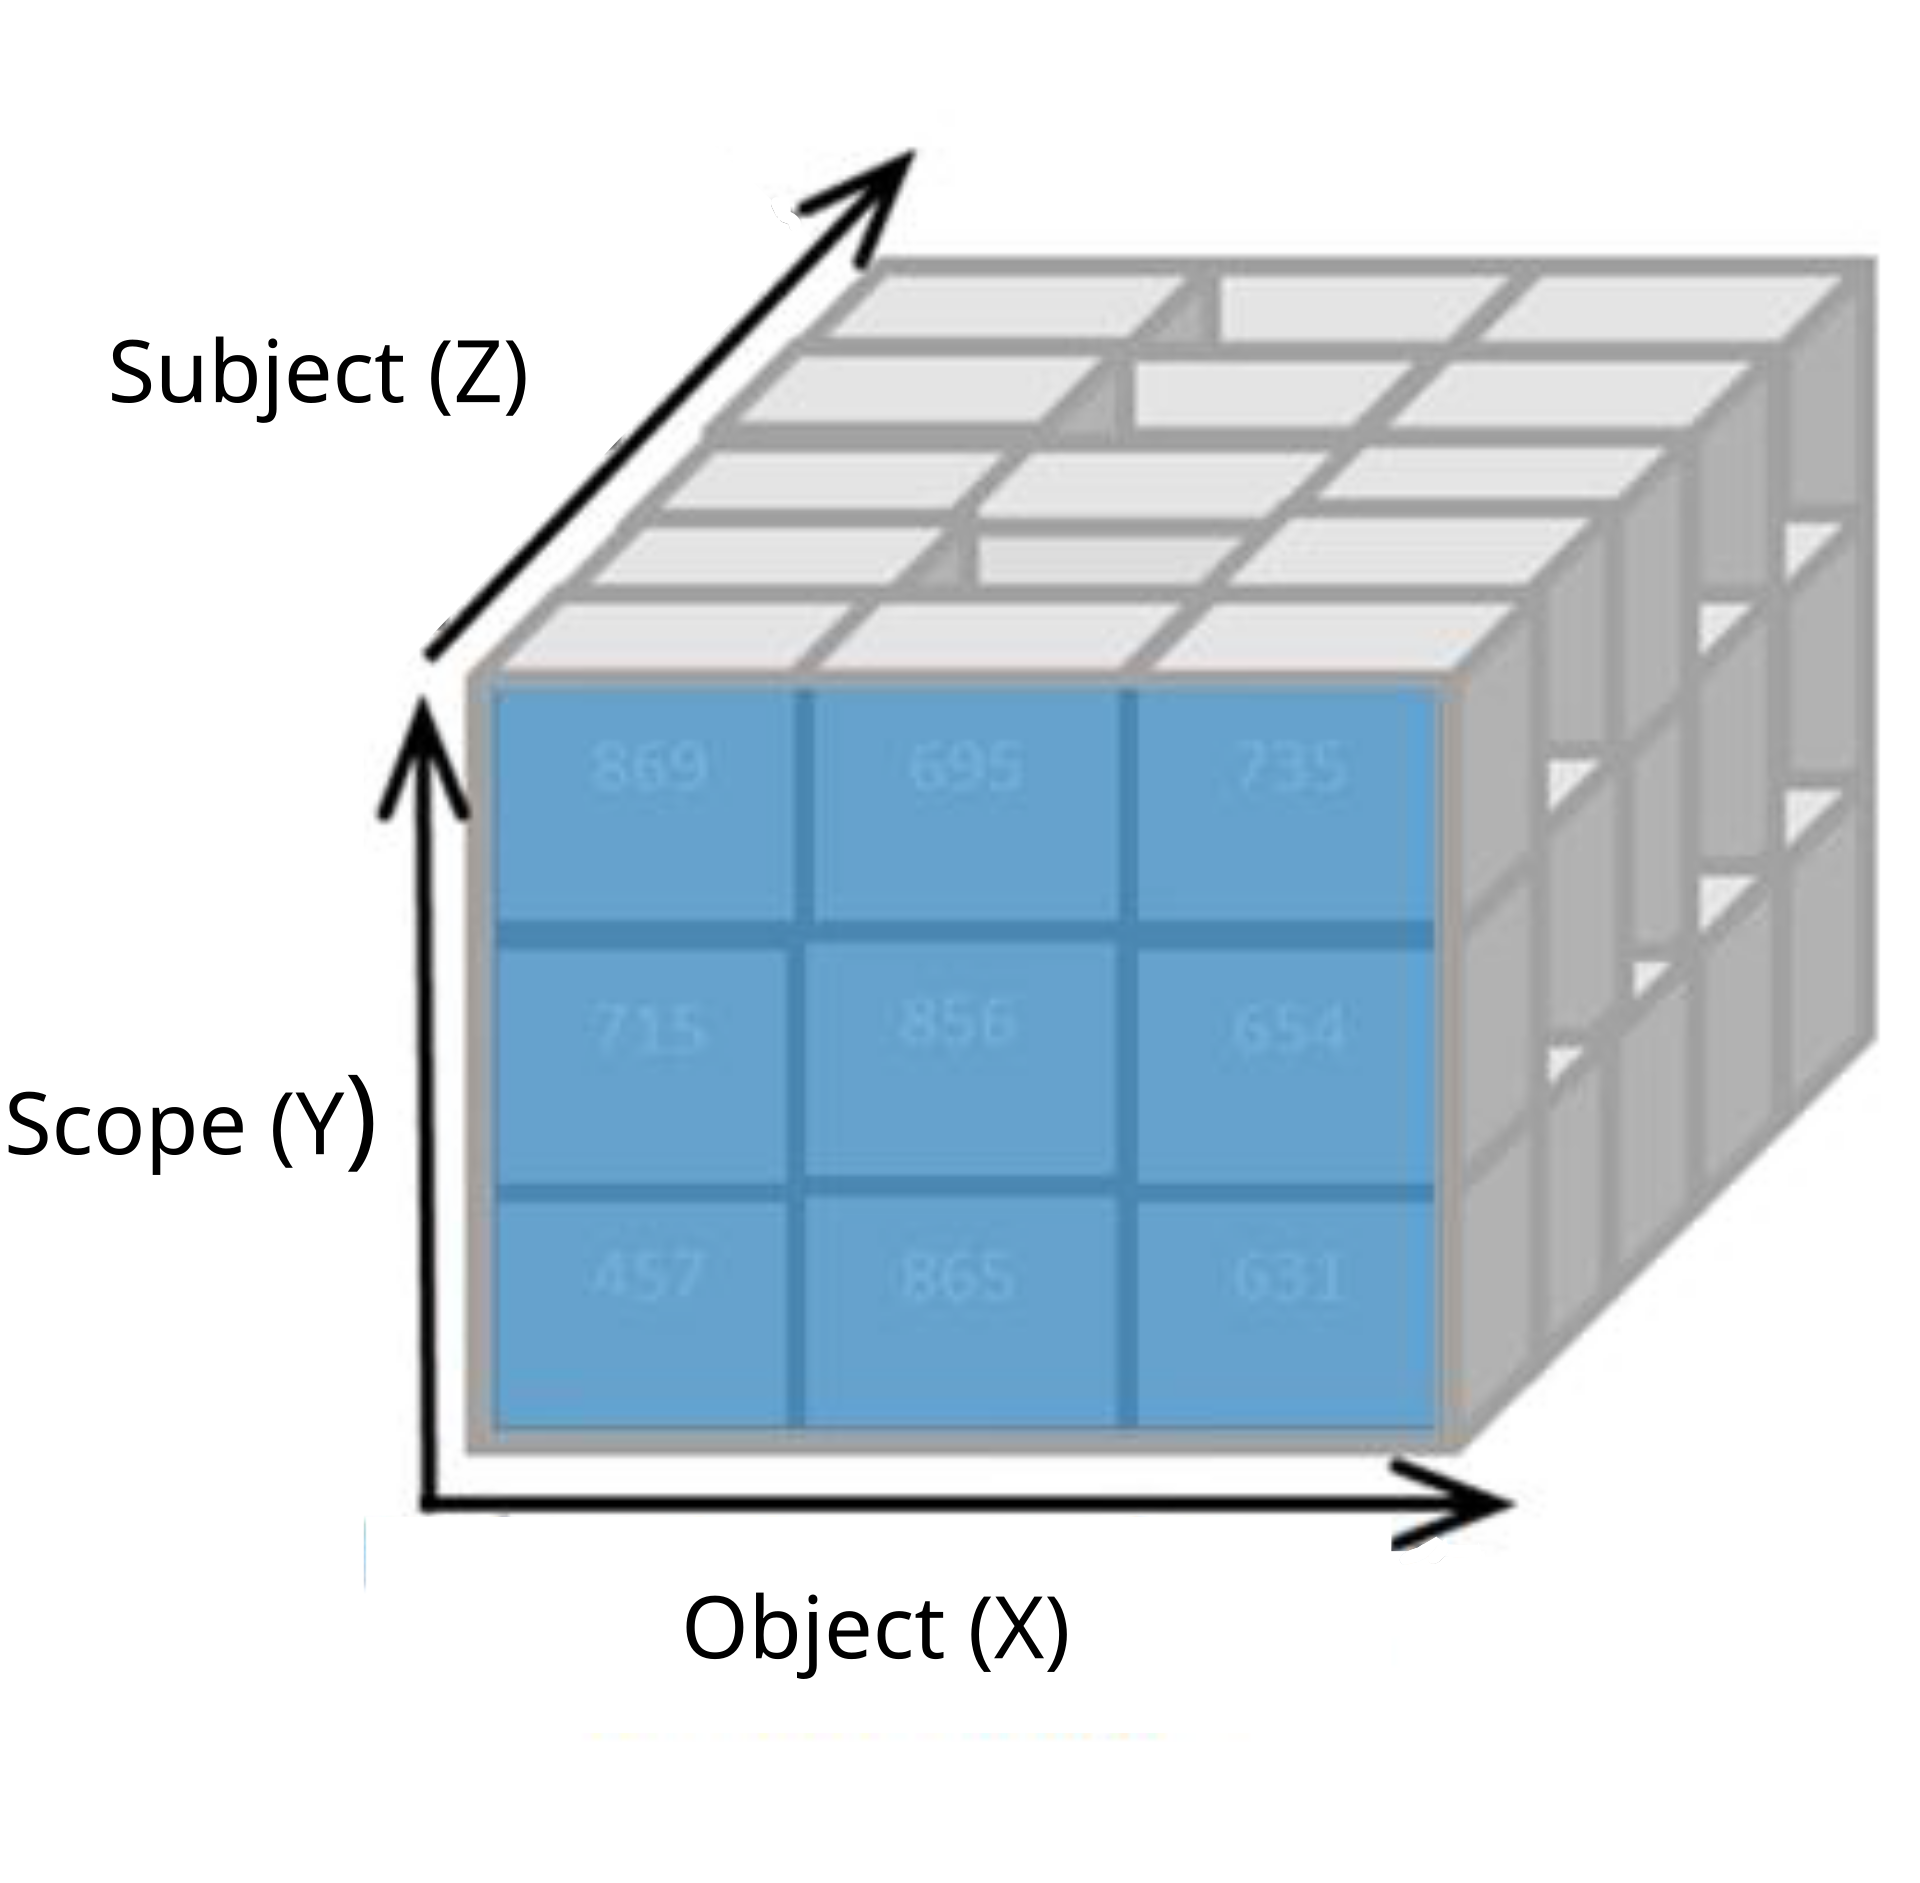
OLAP cube và mô hình lưu trữ định hướng cột
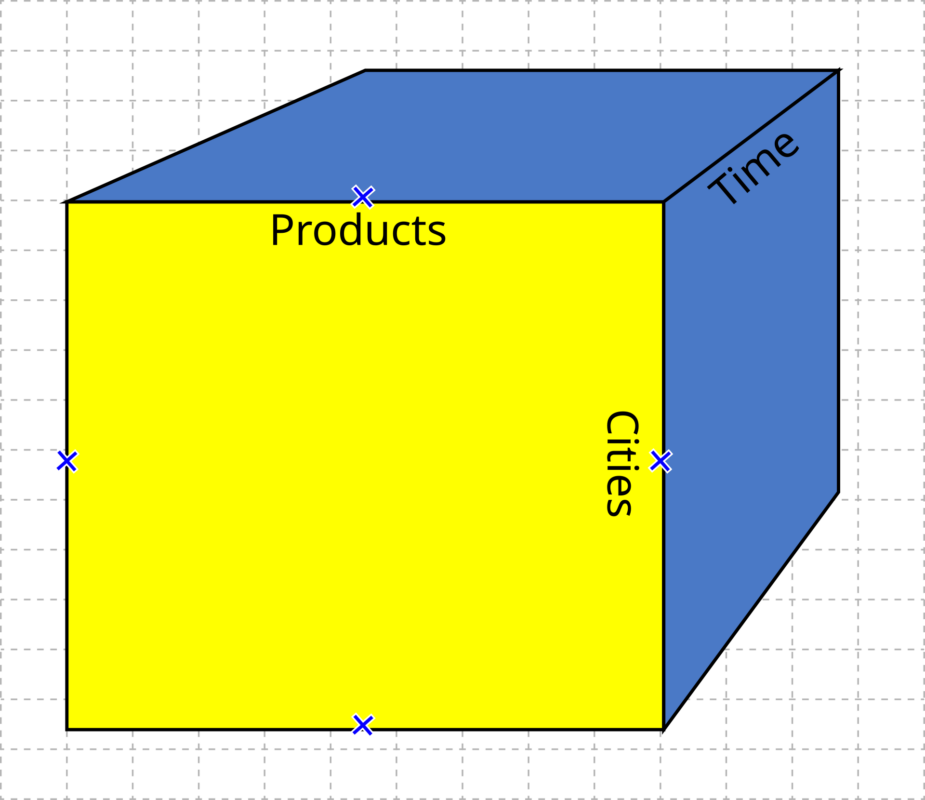
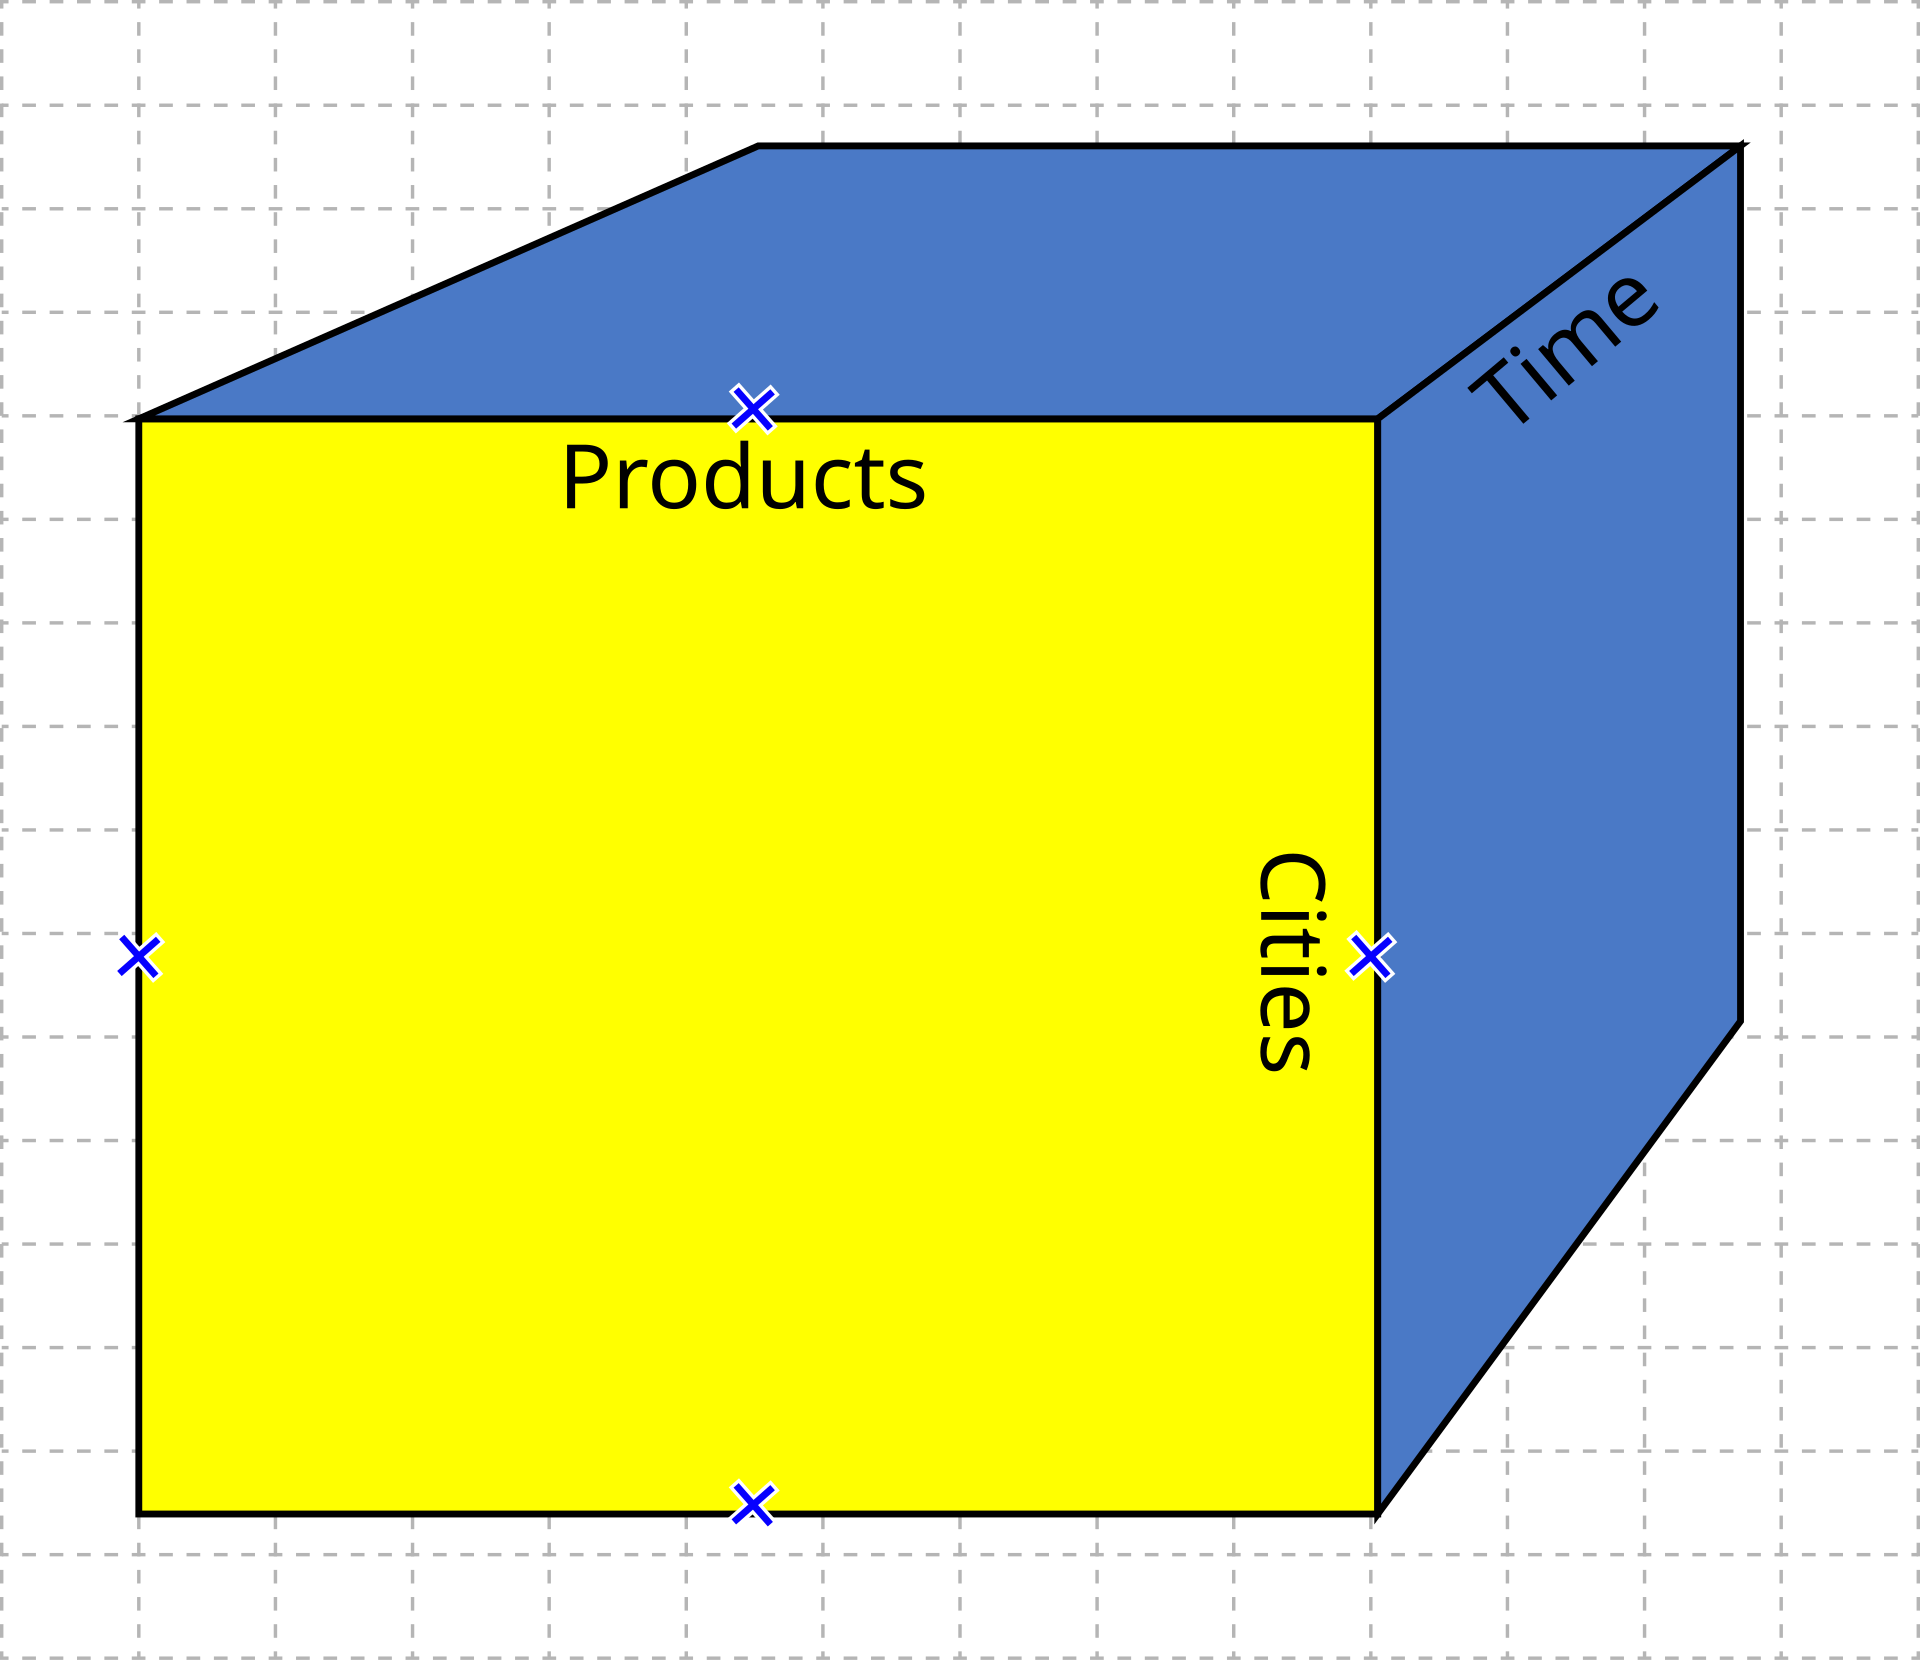
OLAP là kiểu xử lý phân tích trực tuyến, tổ chức dữ liệu thành khối đa chiều (OLAP cube) để trả lời nhanh các câu hỏi tổng hợp theo nhiều chiều: doanh thu theo tháng, theo khu vực, theo nhóm sản phẩm. Mô hình cube giúp hệ thống chỉ cần tính toán trên tập dữ liệu đã tổng hợp sẵn thay vì quét toàn bộ dữ liệu gốc, nhờ đó thời gian phản hồi giảm từ hàng giờ xuống còn vài giây.
Bên dưới, DuckDB hiện thực hiệu điều đó bằng cách lưu trữ theo cột: mỗi cột được ghi thành một chuỗi giá trị liên tục tách biệt. Khi truy vấn chỉ cần cột doanh thu và cột ngày, hệ thống đọc đúng hai chuỗi đó, bỏ qua các cột mô tả sản phẩm hay địa chỉ khách hàng. Cùng một tập tin, lưu trữ cột tiết kiệm băng thông đĩa hơn hẳn so với lưu trữ theo hàng, và cũng là nền tảng để DuckDB nén dữ liệu cực hiệu quả bằng mã hóa chênh lệch (delta encoding) và từ điển.
Đây cũng là lý do DuckDB được ví như “SQLite của thế giới phân tích dữ liệu”: SQLite lưu theo hàng nên hợp với ứng dụng desktop và điện thoại, còn DuckDB lưu theo cột nên hợp với phân tích dữ liệu quy mô lớn — mà vẫn giữ được cùng đặc tính nhúng, chạy trong một file, không cần cài đặt máy chủ.
Cách bắt đầu sử dụng
Cài đặt DuckDB cực kỳ đơn giản qua pip cho Python, hoặc tải bản binary dạng lệnh cho Linux, macOS và Windows. Sau khi cài, bạn có thể mở giao diện dòng lệnh duckdb và bắt đầu truy vấn file CSV ngay, hoặc dùng thư viện Python để nhúng trong pipeline dữ liệu của mình.
Về mặt hiệu năng, các benchmark công khai thường cho thấy DuckDB hoàn thành nhiều truy vấn tổng hợp trên tập dữ liệu hàng trăm triệu dòng nhanh hơn đáng kể so với SQLite, và cạnh tranh được với các hệ thống phân tán khi quy mô dữ liệu vừa phải. Đổi lại, DuckDB không phải lựa chọn khi cần ghi đồng thời từ nhiều tiến trình hay cần tuân thủ ACID chặt chẽ ở cấp transaction, vì đó là thế mạnh của các hệ thống client-server như PostgreSQL.
Tóm lại, nếu bạn cần công cụ phân tích dữ liệu nhẹ, chạy được offline, không muốn dựng cả một cụm máy chủ phân tán chỉ để tính tổng doanh thu theo quý, DuckDB là lựa chọn hợp lý và đang được ngày càng nhiều đội ngũ dữ liệu chọn dùng. Thông tin chi tiết về dự án bạn có thể tham khảo tại trang chủ chính thức duckdb.org, tài liệu chi tiết về kiến trúc tại trang kiến trúc DuckDB, và bối cảnh lịch sử tại bài viết DuckDB trên Wikipedia.