LoRA & QLoRA: Fine-tune LLM hiệu quả trên GPU consumer mà không cần server đắt tiền
Trong thời đại AI sinh tạo ngày nay, việc fine-tune mô hình ngôn ngữ lớn (LLM) đã trở thành nhu cầu thiết yếu cho nhiều ứng dụng cụ thể. Tuy nhiên, việc fine-tune đầy đủ mô hình có kích thước tỷ lệ tham số như LLaMA-2 70B hoặc GPT-3 175B đòi hỏi hàng chục đến hàng trăm GB VRAM, khiến chỉ có thể thực hiện trên các supercomputer hoặc instance cloud đắt tiền. LoRA (Low-Rank Adaptation) và phiên bản cải tiến QLoRA đã thay đổi hoàn toàn trò chơi này bằng cách cho phép fine-tune LLM trên GPU consumer như RTX 3090/4090 với chỉ 24GB VRAM.
LoRA hoạt động như thế nào?
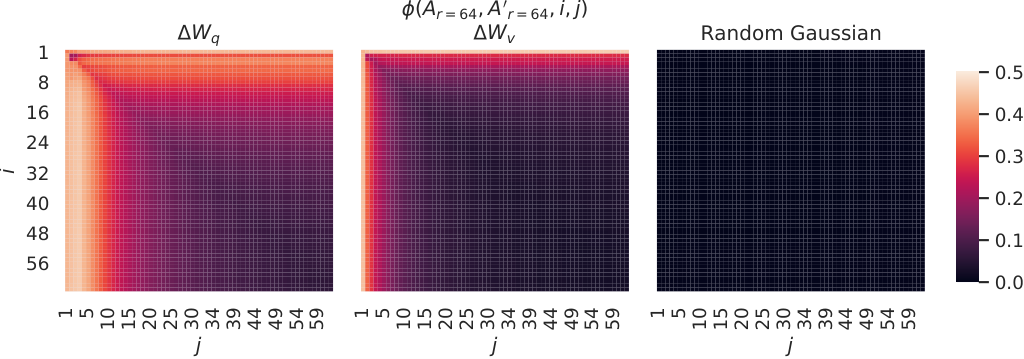
Thay vì cập nhật toàn bộ ma trận trọng số W trong mô hình Transformer, LoRA Hypothesis cho rằng sự thay đổi trong trọng số podczas fine-tune có rank thấp. Do đó thay vì học ma trận ΔW đầy đủ, chúng ta học ma trận phân tích rank thấp ΔW = BA, trong đó B ∈ Rd×r, A ∈ Rr×k, và r ≪ min(d,k). Trong thực tế, r thường chỉ bằng 8, 16, 32 hoặc 64.
Trong quá trình forward pass, output trở thành:
h = Wx + BAxTrong đó W là trọng số được freeze (không được cập nhật), BA là sự điều chỉnh low-rank. Khi r rất nhỏ, số tham số cần học giảm dramatically – từ hàng tỷ xuống chỉ hàng triệu.
So sánh bộ nhớ và hiệu suất
Với LLaMA-2 7B:
- Full fine-tune: Cần ~14GB VRAM (FP16) hoặc ~7GB (int8) cho adapter weights, nhưng optimizer states vẫn lớn
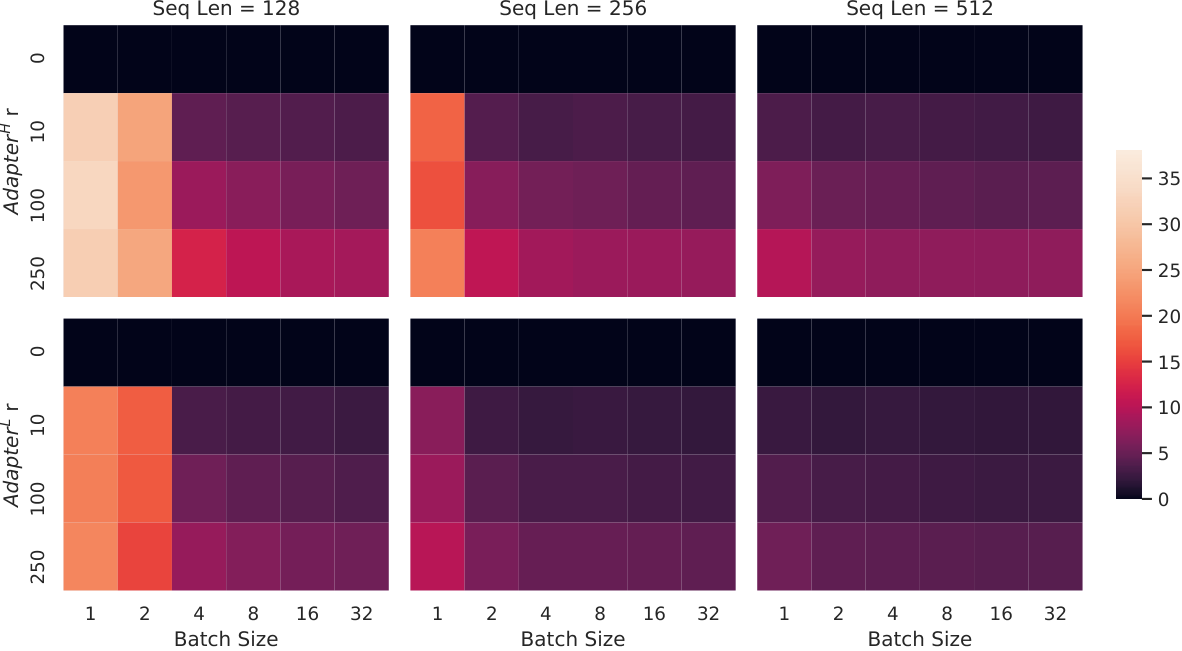
- LoRA (r=8): Chỉ cần ~3.5GB VRAM cho LoRA weights + optimizer states
- QLoRA (4-bit): Cần chỉ ~2.3GB VRAM nhờ quantization 4-bit + paged optimizers
Điều này có nghĩa là bạn có thể fine-tune LLaMA-2 7B trên một chiếc RTX 3060 12GB!
QLoRA: Tối ưu bộ nhớ đến mức cực đại
QLoRA kết hợp LoRA với 4-bit quantization thông qua NF4 (NormalFloat 4) và double quantization. Kỹ thuật chính bao gồm:
- Quantization mô hình sebelumnya: Chuyển toàn bộ trọng số W thành 4-bit, giảm bộ nhớ xuống 1/4 so với FP16
- LoRA adapter: Thêm các ma trận low-rank trainable trong FP16/BF16
- Paged optimizers: Làm việc giống virtual memory trong OS – chỉ giữ phần đang dùng trong GPU RAM, phần còn lại lưu trên CPU RAM
Kết quả: Fine-tune LLaMA-2 13B chỉ cần 4.8GB VRAM, LLaMA-2 70B cần khoảng 23GB VRAM – đủ để chạy trên một chiếc RTX 4090 24GB!
Hiệu quả thực tế
Các nghiên cứu chỉ ra LoRA/QLoRA:
- Giảm bộ nhớ đào tạo từ 3-10 lần so với full fine-tune
- Tăng tốc độ huấn luyện từ 2-5 lần nhờ giảm kích thước gradient
- Đạt được chất lượng model tương đương hoặc tốt hơn full fine-tune trên các benchmark như GSM8K, MMLU, HumanEval
- Hỗ trợ song song hóa tốt trên multi-GPU
Một ví dụ cụ thể: Fine-tune Mistral-7B trên tập dữ liệu Alpaca với QLoRA (r=64, α=16) mất khoảng 3 giờ trên một RTX 4090 và đạt điểm số 85% trên MT-Bench.
Các công cụ hỗ trợ
Các thư viện phổ biến hiện đã tích hợp sẵn LoRA/QLoRA:
- PEFT (Parameter-Efficient Fine-Tuning) của Hugging Face:
pip install peft - unsloth: Tối ưu thêm cho LoRA, cho tốc độ nhanh 2x
- Axolotl: Cấu hình YAML đơn giản để fine-tune bất kỳ LLM nào
- LLaMA-Factory: Giao diện web cho QLoRA experiments
Ví dụ mã code đơn giản với PEFT (LoRA paper):
from peft import LoraConfig, get_peft_model
from transformers import AutoModelForCausalLM, AutoTokenizer

model = AutoModelForCausalLM.from_pretrained("meta-llama/Llama-2-7b-hf")
tokenizer = AutoTokenizer.from_pretrained("meta-llama/Llama-2-7b-hf")

lora_config = LoraConfig(
    r=16,                    # rank
    lora_alpha=32,           # scaling factor
    target_modules=["q_proj", "v_proj"],  # which layers to apply LoRA
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM"
)

model = get_peft_model(model, lora_config)
model.print_trainable_parameters()  # Output: trainable params: 1,048,576 || all params: 7,239,143,424 || trainable%: 0.01
Khi nào nên dùng LoRA/QLoRA?
LoRA/QLoRA là lựa chọn tối ưu khi:
- Bạn cần điều chỉnh LLM cho một domain cụ thể (y pháp, tài chính, pháp luật)
- Hạn chế về tài nguyên compute (máy cá nhân, server nhỏ)
- Muốn thử nghiệm nhiều biến đổi nhanh chóng (hyperparameter tuning)
- Cần triển khai nhiều biến thể của cùng một base model (multi-tenancy serving)
Ngược lại, nếu bạn có thể truy cập vào H100 cluster và cần tối ưu tuyệt đối cho một task cụ thể, full fine-tune vẫn có thể đáng cân nhắc vì có thể đạt được kết quả немного tốt hơn trong một số trường hợp.
Tương lai của Parameter-Efficient Fine-Tuning
LoRA chỉ là bước khởi đầu. Các phương pháp mới như:
- AdaLoRA: Tự động điều chỉnh rank trong quá trình huấn luyện
- LoKR: Sử dụng Kronecker product để biểu diễn ma trận cần học
- VeRA: Vector-based adaptation với memory footprint thấp hơn nữa
- IA3: Chỉ scale activation mà không thêm trọng số mới
đang được nghiên cứu và phát triển. Tuy nhiên, LoRA/QLoRA vẫn đứng đầu về sự kết hợp giữa hiệu quả, đơn giản và hiệu suất, khiến chúng trở thành công cụ không thể thiếu trong bộ công cụ của mọi AI engineer hiện nay.