Sparse Autoencoder (SAE) là kỹ thuật interpretability AI giúp con người hiểu được bên trong mạng neural hoạt động ra sao, từ đó phát hiện và kiểm soát các đặc trưng (features) mà mô hình học được.
Sparse Autoencoder Là Gì?
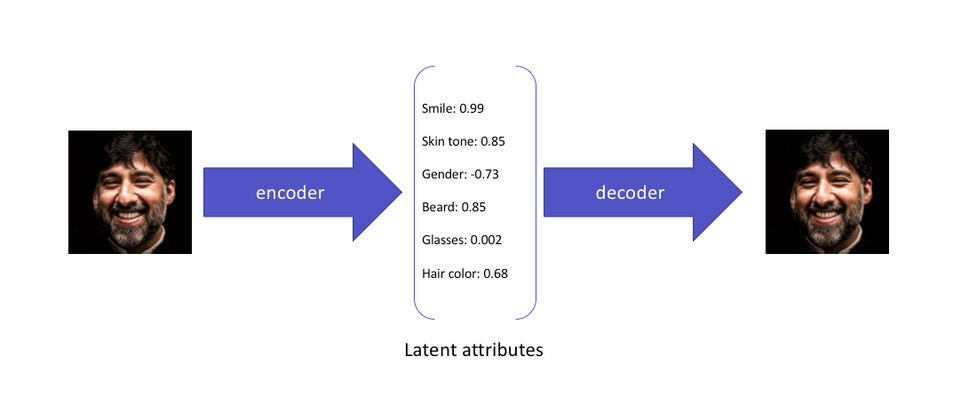
Sparse Autoencoder là một dạng autoencoder với ràng buộc thưa (sparsity). Trong khi autoencoder thông thường nén dữ liệu thành biểu diễn ẩn rồi tái tạo lại, SAE ép biểu diễn ẩn chỉ có một vài nơ-ron hoạt động tại mỗi thời điểm. Điều này khiến mỗi nơ-ron hoạt động đại diện cho một đặc trưng riêng biệt và dễ diễn giải, thay vì hàng ngàn đặc trưng đan xen phức tạp như trong bản gốc.
Về cơ bản, SAE gồm ba phần chính: encoder biến đổi activation của transformer thành vector sparse, layer ẩn với độ thưa cao (chỉ 1-5% nơ-ron bật), và decoder tái tạo lại activation ban đầu từ vector thưa. Mất mát huấn luyện kết hợp reconstruction loss với sparsity loss, ép mô hình học cách diễn giải tốt nhất với càng ít nơ-ron bật càng tốt.
Tại Sao Cần Interpretability?
Mạng neural hiện đại có hàng tỷ tham số, hoạt động như một “hộp đen”. Nếu không hiểu bên trong, ta không thể:
- Phát hiện lỗi: Mô hình có thể dựa trên các đặc trưng sai (spurious features) mà ta không biết. Ví dụ: một mô hình phân loại ảnh chó sói vs chó nuôi có thể học đặc trưng “nền tuyết” thay vì đặc trưng liên quan đến con vật thật.
- Đảm bảo an toàn (alignment): AI alignment yêu cầu hiểu mô hình đang làm gì và tại sao. Nếu chúng ta không thể nhìn vào bên trong, việc kiểm tra tính an toàn trở thành vấn đề “tin mù” (blind trust).
- Kiểm soát đầu ra: Khi đã hiểu từng feature, ta có thể can thiệp vào feature cụ thể để điều chỉnh hành vi mô hình mà không cần huấn luyện lại toàn bộ.
Cách Hoạt Động
SAE phân rã representation của model (thường là layer intermediate của LLM) thành các feature riêng lẻ:
- Lấy activation từ một layer của transformer (ví dụ: layer 30 của GPT-4).
- Đưa qua encoder linear để tạo biểu diễn sparse — chỉ một vài nơ-ron bật (khoảng 1-5%).
- Mỗi nơ-ron bật tương ứng với một feature có ý nghĩa (ví dụ: “mã hóa tên riêng”, “phát hiện code Python”, “recognize Arabic numerals”).
- Decoder tái tạo activation ban đầu từ biểu diễn sparse.
- Huấn luyện SAE trên hàng triệu ví dụ activation để các feature khớp với reality.
- Sau khi huấn luyện, mỗi feature thường có interpretable meaning — ta có thể đọc nó bằng cách xem ví dụ input nào kích hoạt nó mạnh nhất.
Kết Quả Nghiên Cứu Tiêu Biểu
OpenAI đã sử dụng SAE để phân tích GPT-4 và phát hiện hơn 16 triệu feature, từ đó can thiệp vào model để giảm hallucination bằng cách áp dụng top-k pruning trên các feature liên quan đến việc bịa thông tin. Anthropic áp dụng SAE lên Claude để nghiên cứu cơ chế reasoning và tìm cách kiểm soát hành vi.
Một trong những kết quả ấn tượng nhất: khi các nhà nghiên cứu tại Anthropic tắt một feature liên quan đến “gian lận toán học” trong Claude, model ngừng đưa ra câu trả lời gian lận và thay vào đó thừa nhận không biết câu trả lời. Điều này chứng minh SAE có thể thực sự thay đổi hành vi mô hình ở mức độ chi tiết, thay vì chỉ là công cụ quan sát.
Các tổ chức như EleutherAI cũng phát triển Open Source Sparse Autoencoder toolkit để cộng đồng nghiên cứu, với các feature từ GPT-2 small được public trên internet. Phân tích open-source này đã phát hiện hơn 70 triệu feature tương ứng với các hiện tượng thực tế: từ “Python syntax” đến “code written in Vietnamese” hay “mathematical reasoning chain”.
Hạn Thách Và Tương Lai
SAE không hoàn hảo. Một số vấn đề hiện tại:
- Feature splitting: Một feature thực tế có thể được chia thành nhiều feature nhỏ hơn, gây khó khăn trong việc tổ chức và hiểu tổng thể.
- Feature absorption: Feature phổ biến có thể “nuốt” các feature liên quan, làm mất một số pattern quan trọng.
- Chi phí tính toán: Huấn luyện SAE trên model lớn như GPT-4 yêu cầu hàng nghìn GPU-hours, tạo barrier cho các nhóm nhỏ.
Tuy nhiên, SAE hiện là công cụ interpretability mạnh nhất và thực tế nhất. Các hướng phát triển tiếp theo bao gồm: SAE trên hidden states giữa layer (not just final), SAE trực tiếp trên vector attention, và kết hợp với mechanistic circuit analysis để hiểu cách các feature tương tác với nhau. Với tốc độ phát triển hiện tại, SAE có thể trở thành công cụ standard trong kỹ thuật AI an toàn trong vài năm tới.
Nguồn tham khảo: OpenAI SAE Research, Anthropic Research