Consistent hashing là gì? Đây là kỹ thuật băm đặc biệt giúp hệ thống phân tán chỉ phải di chuyển một phần rất nhỏ dữ liệu mỗi khi số lượng server thay đổi, thay vì băm lại toàn bộ bảng băm như cách làm truyền thống. Bài viết này giải thích nguyên lý vòng tròn, so sánh với băm theo modulo, và chỉ ra vì sao kỹ thuật này nền tảng cho CDN và bảng băm phân tán.
Vấn đề của cách băm truyền thống
Giả sử bạn có n khóa dữ liệu và muốn trải đều chúng lên m server. Cách đơn giản nhất là lấy giá trị băm của khóa rồi chia lấy phần dư cho số server: zeta = beta % n. Cách này chạy rất nhanh và rất phổ biến, nhưng nó có một điểm yếu chí tử: số lượng server là tham số của phép chia.
Khi bạn thêm hoặc bớt một server, mẫu số thay đổi và gần như mọi khóa sẽ rơi vào một vị trí khác. Với hàng triệu khóa, toàn bộ dữ liệu phải được tính lại vị trí lưu trữ và di chuyển. Trong hệ thống CDN đang phục vụ hàng triệu người dùng, mỗi lần thêm node mới sẽ tạo ra một đợt bão lưu lượng không cần thiết và các khoảng trống phục vụ ngẫu nhiên.
Nguyên nhân sâu hơn nằm ở tính chất của phép chia lấy phần dư: hai khóa chỉ cần lệch nhau một đơn vị trước khi chia là có thể rơi vào hai server hoàn toàn khác nhau. Không có quan hệ nào giữa vị trí cũ và vị trí mới, nên không thể dự đoán phần nào cần di chuyển.
Ý tưởng cốt lõi: đưa mọi thứ lên một vòng tròn
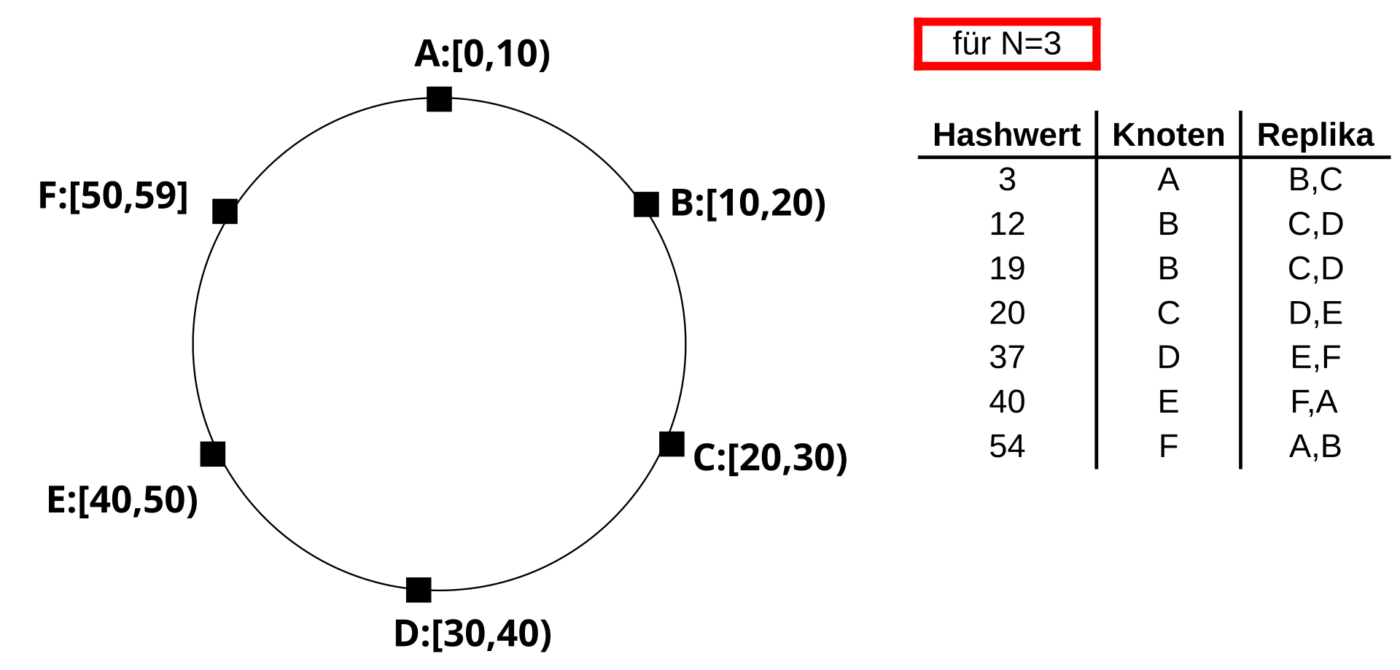
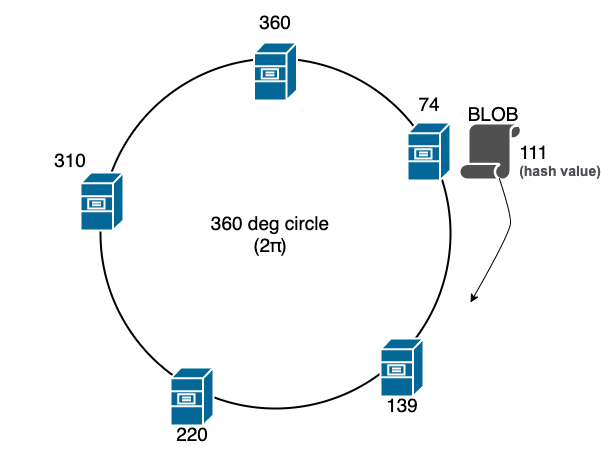
Consistent hashing bỏ hẳn phép chia lấy phần dư. Thay vào đó, một hàm băm ánh xạ cả khóa dữ liệu lẫn định danh server vào cùng một không gian giả tưởng, thường là một vòng tròn có chu vi 2 pi radian. Mỗi server được biểu diễn bằng một điểm trên vòng tròn theo vị trí của hàm băm trên địa chỉ IP hoặc UUID của nó.
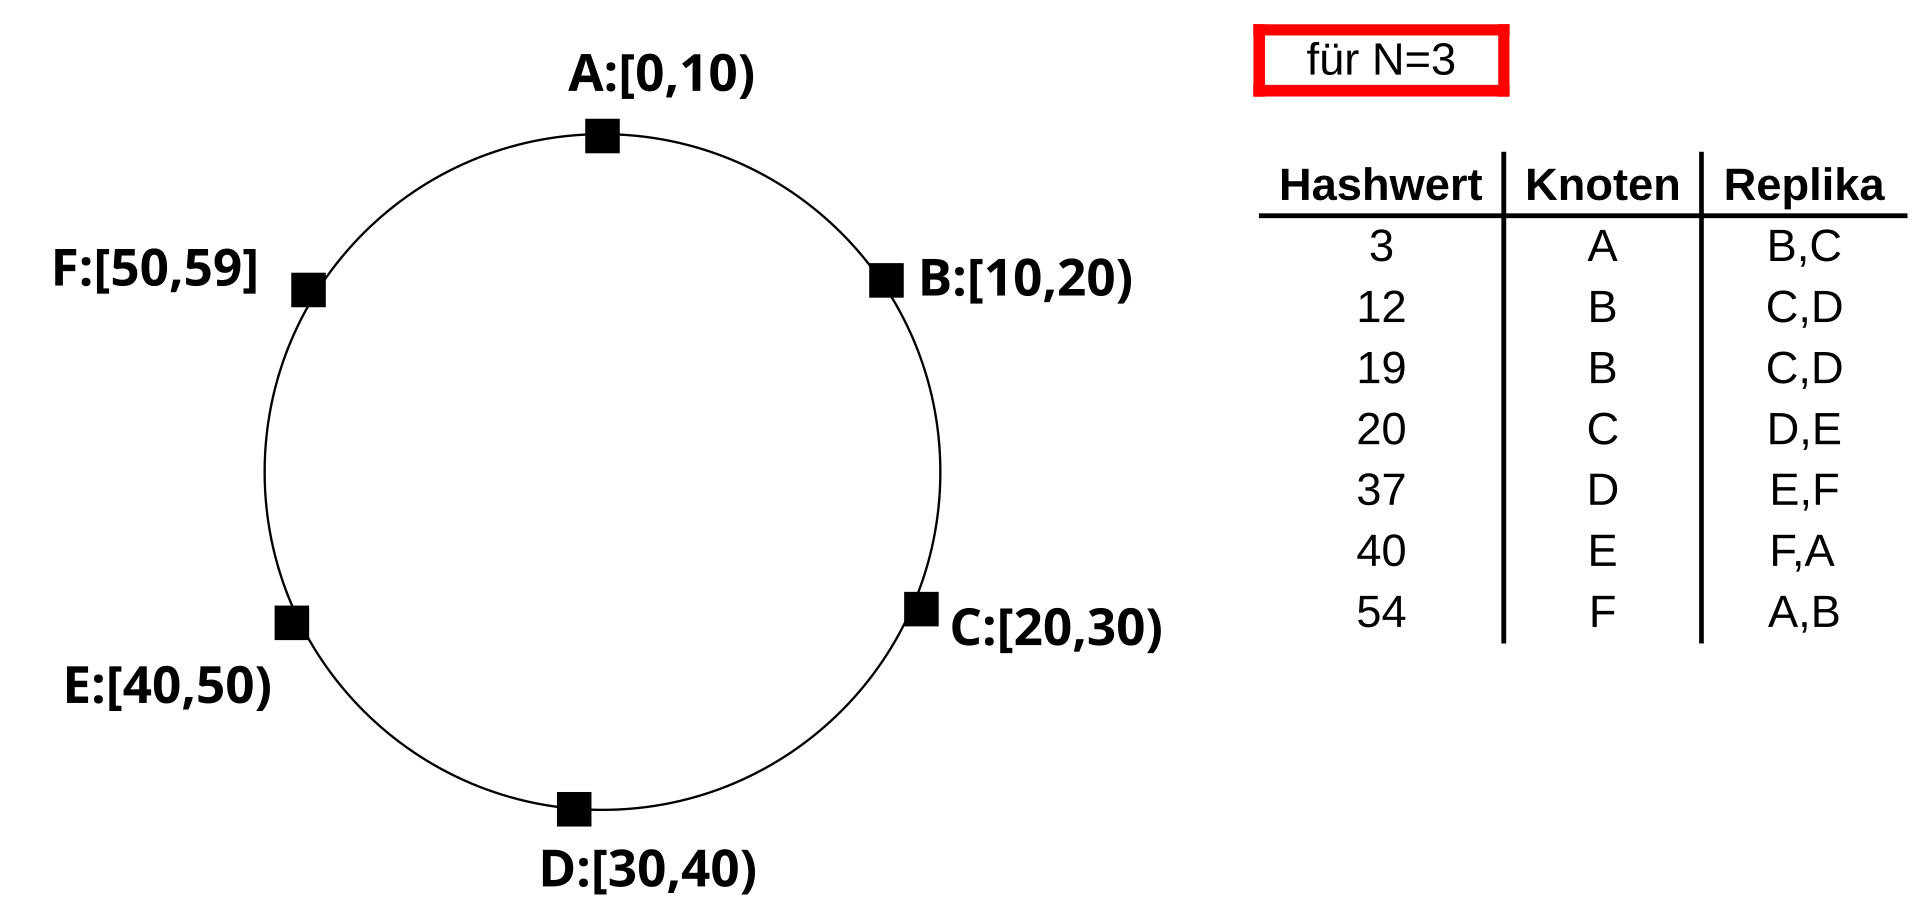
Quy tắc gán rất đơn giản: mỗi khóa được băm ra một điểm trên cùng vòng tròn, rồi gán cho server kế tiếp xuất hiện theo chiều kim đồng hồ tính từ điểm đó. Không cần chia lấy phần dư ở bất kỳ đâu.
Điểm cốt lõi nằm ở tính chất bất biến của quy tắc này. Nếu bạn thêm một server mới, nó chỉ chiếm một đoạn nhỏ trên vòng tròn. Chỉ những khóa nằm trong đoạn đó mới phải chuyển sang server mới, còn toàn bộ khóa còn lại vẫn trỏ tới đúng server cũ. Khi một server chết, chỉ các khóa thuộc vùng của nó mới được dồn sang server kế tiếp.
Trên lý thuyết, số lượng khóa phải di chuyển trung bình bằng tỉ lệ giữa số khóa và số slot, tức là n/m, và con số này gần như không đổi khi số server tăng lên. Đây chính là điểm khác biệt căn bản so với băm theo modulo.
Vì sao CDN dùng kỹ thuật này
Consistent hashing được giới thiệu bởi nhóm của David Karger và cộng sự tại Viện Công nghệ Massachusetts vào năm 1997, trong bài báo hội nghị về lý thuyết tính toán, với mục tiêu phân phối yêu cầu cho một tập server thay đổi liên tục. Ý tưởng này sinh ra từ một sự cố rất cụ thể của thập niên 1990: sự tập trung lưu lượng đột ngột vào một số ít máy chủ phổ biến khiến toàn bộ web chậm lại, hiện tượng mà giới công nghệ gọi là slashdotting.
Hôm nay, các mạng phân phối nội dung đã trở thành nơi sử dụng phổ biến nhất của kỹ thuật này. Ví dụ nổi tiếng là Akamai, nền tảng CDN được hai tác giả bài báo năm 1997 là Daniel Lewin và F. Thomson Leighton thành lập năm 1998. Trong hạ tầng của họ, consistent hashing dùng để cân bằng tải bên trong một cụm server, còn việc cân bằng giữa nhiều cụm thì dùng một thuật toán khác là stable marriage.
Ngay cả cơ sở dữ liệu phân tán cũng dùng nguyên lý tương tự. Teradata đã áp dụng ý tưởng này vào cơ sở dữ liệu phân tán của họ từ năm 1986, dù họ không dùng cái tên consistent hashing. Ngày nay, consistent hashing là nền móng của bảng băm phân tán, hay DHT, nơi giá trị băm được dùng để chia không gian khóa của toàn hệ thống cho nhiều nút rồi dựng một mạng lớp phủ giúp tìm nút theo khóa hiệu quả.
Rendezvous hashing: biến thể đơn giản hơn
Có một cách tiếp cận cùng mục tiêu nhưng đơn giản và tổng quát hơn, được thiết kế khoảng năm 1996: rendezvous hashing. Thay vì dựng vòng tròn và tìm vị trí kế tiếp, thuật toán này coi mỗi server là một điểm hẹn, mỗi khóa sẽ chọn server có trọng số ngẫu nhiên cao nhất trong số các server đang sống.
Rendezvous hashing đạt cùng kết quả phân bổ với consistent hashing, nhưng không cần cấu trúc vòng tròn, không cần xử lý nhiều điểm ảo cho một server, và việc thêm hoặc gỡ một server chỉ liên quan tới đúng những khóa thuộc server đó. Đổi lại, mỗi lần tra cứu phải tính trọng số cho toàn bộ server trong danh sách.
Điểm cần lưu ý khi triển khai
Consistent hashing không tự động cân bằng tải hoàn hảo. Nếu vị trí của các server trên vòng tròn rơi vào nhau hoặc dồn cục, một server sẽ nhận nhiều khóa hơn vẫn. Các triển khai thực tế dùng nhiều điểm ảo cho mỗi server để làm loãng bố trí, hoặc kết hợp với một cơ chế cân bằng tải riêng.
Chi phí tra cứu cũng cần cân nhắc. Tìm tuyến tính trên vòng tròn có độ phức tạp tuyến tính theo số server, trong khi tìm kiếm nhị phân đưa chi phí xuống mức log của số server, đổi lại vòng tròn phải được duy trì có thứ tự.
Tóm lại, consistent hashing là câu trả lời kinh điển cho bài toán phân phối dữ liệu trên quy mô lớn khi tập server thay đổi liên tục. Nếu bạn đang xây cache phân tán, CDN hay bảng băm phân tán, đây là thuật toán nên đưa vào danh sách cân nhắc đầu tiên.
Tham khảo thêm: bài viết Consistent hashing trên Wikipedia và bài báo gốc năm 1997 của Karger và cộng sự trên Symposium on Theory of Computing.