Synthetic Data: Dữ Liệu Nhân Tạo Cho Đào Tạo Mô Hình AI
Trong thế giới AI hiện đại, synthetic data (dữ liệu nhân tạo) đang trở thành nguồn tài nguyên không thể thiếu để đào tạo các mô hình học máy. Khi dữ liệu thực khan hiếm, đắt đỏ hoặc chứa thông tin nhạy cảm, synthetic data cung cấp giải pháp thay thế hiệu quả — tạo ra dữ liệu hoàn toàn mới bằng thuật toán nhưng vẫn giữ nguyên các đặc trưng thống kê của dữ liệu gốc.
Synthetic Data Là Gì?
Synthetic data là dữ liệu được tạo ra nhân tạo, không phải từ các sự kiện thực tế. Nó được sinh ra thông qua các thuật toán, mô phỏng máy tính hoặc mô hình tạo sinh (generative models). Dữ liệu này có thể mô phỏng các đặc tính của dữ liệu thực tế nhưng hoàn toàn không chứa thông tin cá nhân thật.
Ý tưởng này đã xuất hiện từ 1993, khi Donald Rubin đề xuất khái niệm fully synthetic data để bảo vệ quyền riêng tư trong thống kê dân cư. Đến nay, synthetic data đã phát triển vượt bậc nhờ sự bùng nổ của deep learning và generative AI. Các mô hình hiện đại như GAN (Generative Adversarial Networks) và diffusion models có khả năng tạo ra dữ liệu tổng hợp có chất lượng cực kỳ cao.
Tại Cầu Synthetic Data?
Dữ liệu thực tế luôn đối mặt với những thách thức lớn khiến việc đào tạo AI trở nên khó khăn:
- Khan hiếm dữ liệu có nhãn: Trong y tế, tài chính hay xe tự hành, dữ liệu được gắn nhãn bởi chuyên gia rất đắt đỏ và tốn thời gian. Mỗi báo cáo y khoa cần bác sĩ chuyên môn đọc và phân loại.
- Vấn đề quyền riêng tư: Dữ liệu khách hàng, y tế hay tài chính không thể công khai do quy định pháp luật như GDPR ở châu Âu hay HIPAA tại Mỹ. Synthetic data giải quyết triệt để vấn đề này.
- Mất cân bằng dữ liệu: Một số lớp dữ liệu quá hiếm (ví dụ: tai nạn hiếm gặp, bệnh dịch tễ), khiến mô hình bị thiên lệch và dự đoán kém chính xác.
- Chi phí thu thập: Dữ liệu từ cảm biến, thiết bị IoT hoặc thí nghiệm khoa học tốn kém để sản xuất và duy trì chất lượng.
Ứng Dụng Chính Của Synthetic Data
1. Đào Tạo Mô Hình Học Máy
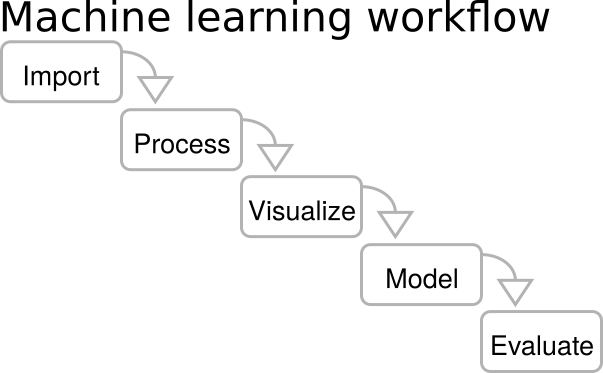
Synthetic data giúp lấp đầy khoảng trống dữ liệu huấn luyện, đặc biệt trong các lĩnh vực mà dữ liệu thực rất khan hiếm. Các mô hình tạo sinh như GAN, VAE hay diffusion models có thể tạo ra hình ảnh, văn bản hoặc dữ liệu bảng có chất lượng cao để bổ sung cho tập dữ liệu hiện có. Ví dụ, trong nhận dạng hình ảnh y khoa, synthetic data tạo ra các bản X-quang giả giúp mô hình học cách phát hiện bệnh hiếm gặp mà không cần hàng nghìn hình ảnh thật.
2. Bảo Vệ Quyền Riêng Tư
Các tổ chức tài chính và y tế sử dụng synthetic data để chia sẻ tập dữ liệu nghiên cứu mà không tiết lộ thông tin cá nhân. Dữ liệu nhân tạo giữ nguyên cấu trúc thống kê nhưng không chứa bản ghi thật nào, cho phép các nhà nghiên cứu hợp tác mà vẫn tuân thủ quy định bảo mật.
3. Kiểm Thử Và Xác Thực Hệ Thống
Trong an ninh mạng, synthetic data được dùng để tạo các hồ sơ hành vi của người dùng và kẻ tấn công, giúp huấn luyện hệ thống phát hiện gian lận hiệu quả hơn. Các kịch bản tấn công mạng phức tạp có thể được mô phỏng mà không cần thực hiện tấn công thực tế.
4. Quốc Phòng Và Nghiên Cứu Khoa Học
Trong bối cảnh dữ liệu thực tế khan hiếm, synthetic data được đánh giá là công cụ có giá trị để phát triển các hệ thống AI phức tạp cho quốc phòng và nghiên cứu khoa học. Trong quân sự, dữ liệu mô phỏng giúp huấn luyện hệ thống nhận dạng mục tiêu mà không cần lộ thông tin nhạy cảm.
5. Xe Tự Hành
Ngành công nghiệp xe tự hành sử dụng synthetic data để mô phỏng hàng triệu tình huống giao thông khác nhau, từ mưa gió đến tai nạn, giúp xe học cách xử lý mà không cần lái thử trong mọi điều kiện thực tế.
Thách Thức Và Hạn Chế
Tuy nhiên, synthetic data không hoàn hảo. Nếu thuật toán tạo dữ liệu có sai lệch (bias), mô hình AI được đào tạo bằng dữ liệu đó sẽ kế thừa và khuếch đại sai lệch đó. Các thách thức chính bao gồm:
- Sai lệch mô hình tạo sinh: GAN hoặc VAE có thể không phản ánh đúng phân phối dữ liệu thực tế.
- Đánh giá chất lượng: Không có tiêu chuẩn thống nhất để đánh giá synthetic data có đủ tốt cho một tác vụ cụ thể hay không.
- Phụ thuộc vào mô hình: Chất lượng output phụ thuộc hoàn toàn vào chất lượng của mô hình tạo sinh.
Tương Lai
Thị trường synthetic data đang tăng trưởng nhanh chóng, dự kiến sẽ vượt 2 tỷ USD vào năm 2030. Các xu hướng đáng chú ý bao gồm:
- Synthetic data cho LLM: Tạo dữ liệu huấn luyện chất lượng cao cho các mô hình ngôn ngữ lớn, giảm phụ thuộc vào dữ liệu thu thập từ web.
- Tự động xác thực: Công cụ tự động đánh giá khi nào synthetic data đủ tốt để sử dụng.
- Công bằng AI: Sử dụng synthetic data để cân bằng lại dữ liệu huấn luyện, giảm thiên lệch giới tính, chủng tộc.
Với sự phát triển của AI tạo sinh, synthetic data sẽ ngày càng đóng vai trò trung tâm trong việc xây dựng các mô hình AI mạnh mẽ, công bằng và bảo mật.
Nguồn tham khảo: Wikipedia – Synthetic data