Apache Kafka Là Gì?
Apache Kafka là nền tảng sự kiện phân tán (distributed event streaming platform), ban đầu được phát triển tại LinkedIn và sau đó trở thành dự án mã nguồn mở của Apache. Kafka chuyên về thu thập, lưu trữ, và xử lý dữ liệu dạng sự kiện theo thời gian thực với thông lượng cực cao.
Khác với message queue truyền thống (RabbitMQ, ActiveMQ), Kafka lưu giữ dữ liệu lâu dài trên disk, cho phép nhiều nhóm consumer đọc lại cùng dữ liệu — phù hợp cho kiến trúc microservices hiện đại.
Tại Cần Kafka?
- Thông lượng cao: Xử lý hàng triệu message mỗi giây trên phần cứng thông thường.
- Lưu trữ bền vững: Data không bị mất ngay cả khi consumer offline.
- Replay: Consumer đọc lại dữ liệu cũ, phục vụ migration hoặc debug.
- Decouple: Producer và consumer độc lập, phát triển riêng biệt.
- Exactly-once semantics: Đảm bảo message không bị trùng hoặc mất.
Cách Kafka Hoạt Động
Kafka gồm 4 thành phần cốt lõi:
- Producer: Ứng dụng gửi sự kiện (message) đến Kafka.
- Broker: Máy chủ Kafka lưu trữ và phục vụ dữ liệu. Một cụm Kafka gồm nhiều broker.
- Topic: Danh mục logic để tổ chức sự kiện. Mỗi topic chia thành nhiều partition để song song hóa.
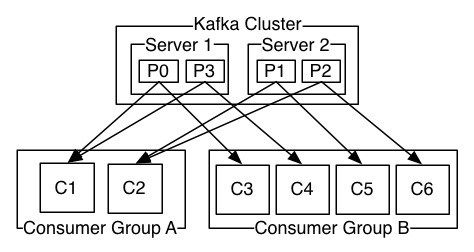
- Consumer: Ứng dụng đọc và xử lý sự kiện từ Kafka. Các consumer trong cùng một group sẽ chia partition giữa nhau.
Các Khái Niệm Quan Trọng
- Event: Bản ghi sự kiện gồm key, value, timestamp và metadata. Ví dụ: “Alice thanh toán 200$ cho Bob” tại thời điểm T.
- Partition: Đơn vị phân mảnh dữ liệu. Sự kiện cùng key luôn vào cùng partition, đảm bảo thứ tự đọc.
- Offset: Vị trí đọc của consumer trong partition. Consumer tự quản lý offset, không bị mất dữ liệu khi restart.
- Consumer Group: Nhóm consumer cùng đọc một topic, mỗi partition chỉ thuộc về 1 consumer trong group.
- Replication: Mỗi partition có bản sao trên nhiều broker (thường replication factor = 3) để chịu lỗi.
Kafka Architecture
Cụm Kafka gồm nhiều broker, mỗi broker lưu một phần dữ liệu. ZooKeeper (hoặc KRaft trong phiên bản mới) quản lý metadata và leader election. Producer gửi data đến leader partition, data được replicate sang follower trước khi confirm.
Kafka hỗ trợ multi-datacenter replication qua MirrorMaker 2, cho phép đồng bộ dữ liệu giữa các cụm Kafka ở các vùng địa lý khác nhau.
Kafka APIs
| API | Mô tả |
|---|---|
| Producer API | Gửi sự kiện đến topic |
| Consumer API | Đọc và xử lý sự kiện từ topic |
| Streams API | Xử lý và biến đổi luồng dữ liệu real-time |
| Connect API | Tích hợp với hệ thống bên ngoài (DB, S3, Elasticsearch) |
| Admin API | Quản lý topic, broker, cấu hình cụm |
Kafka Streams — Xử Lý Thời Gian Thực
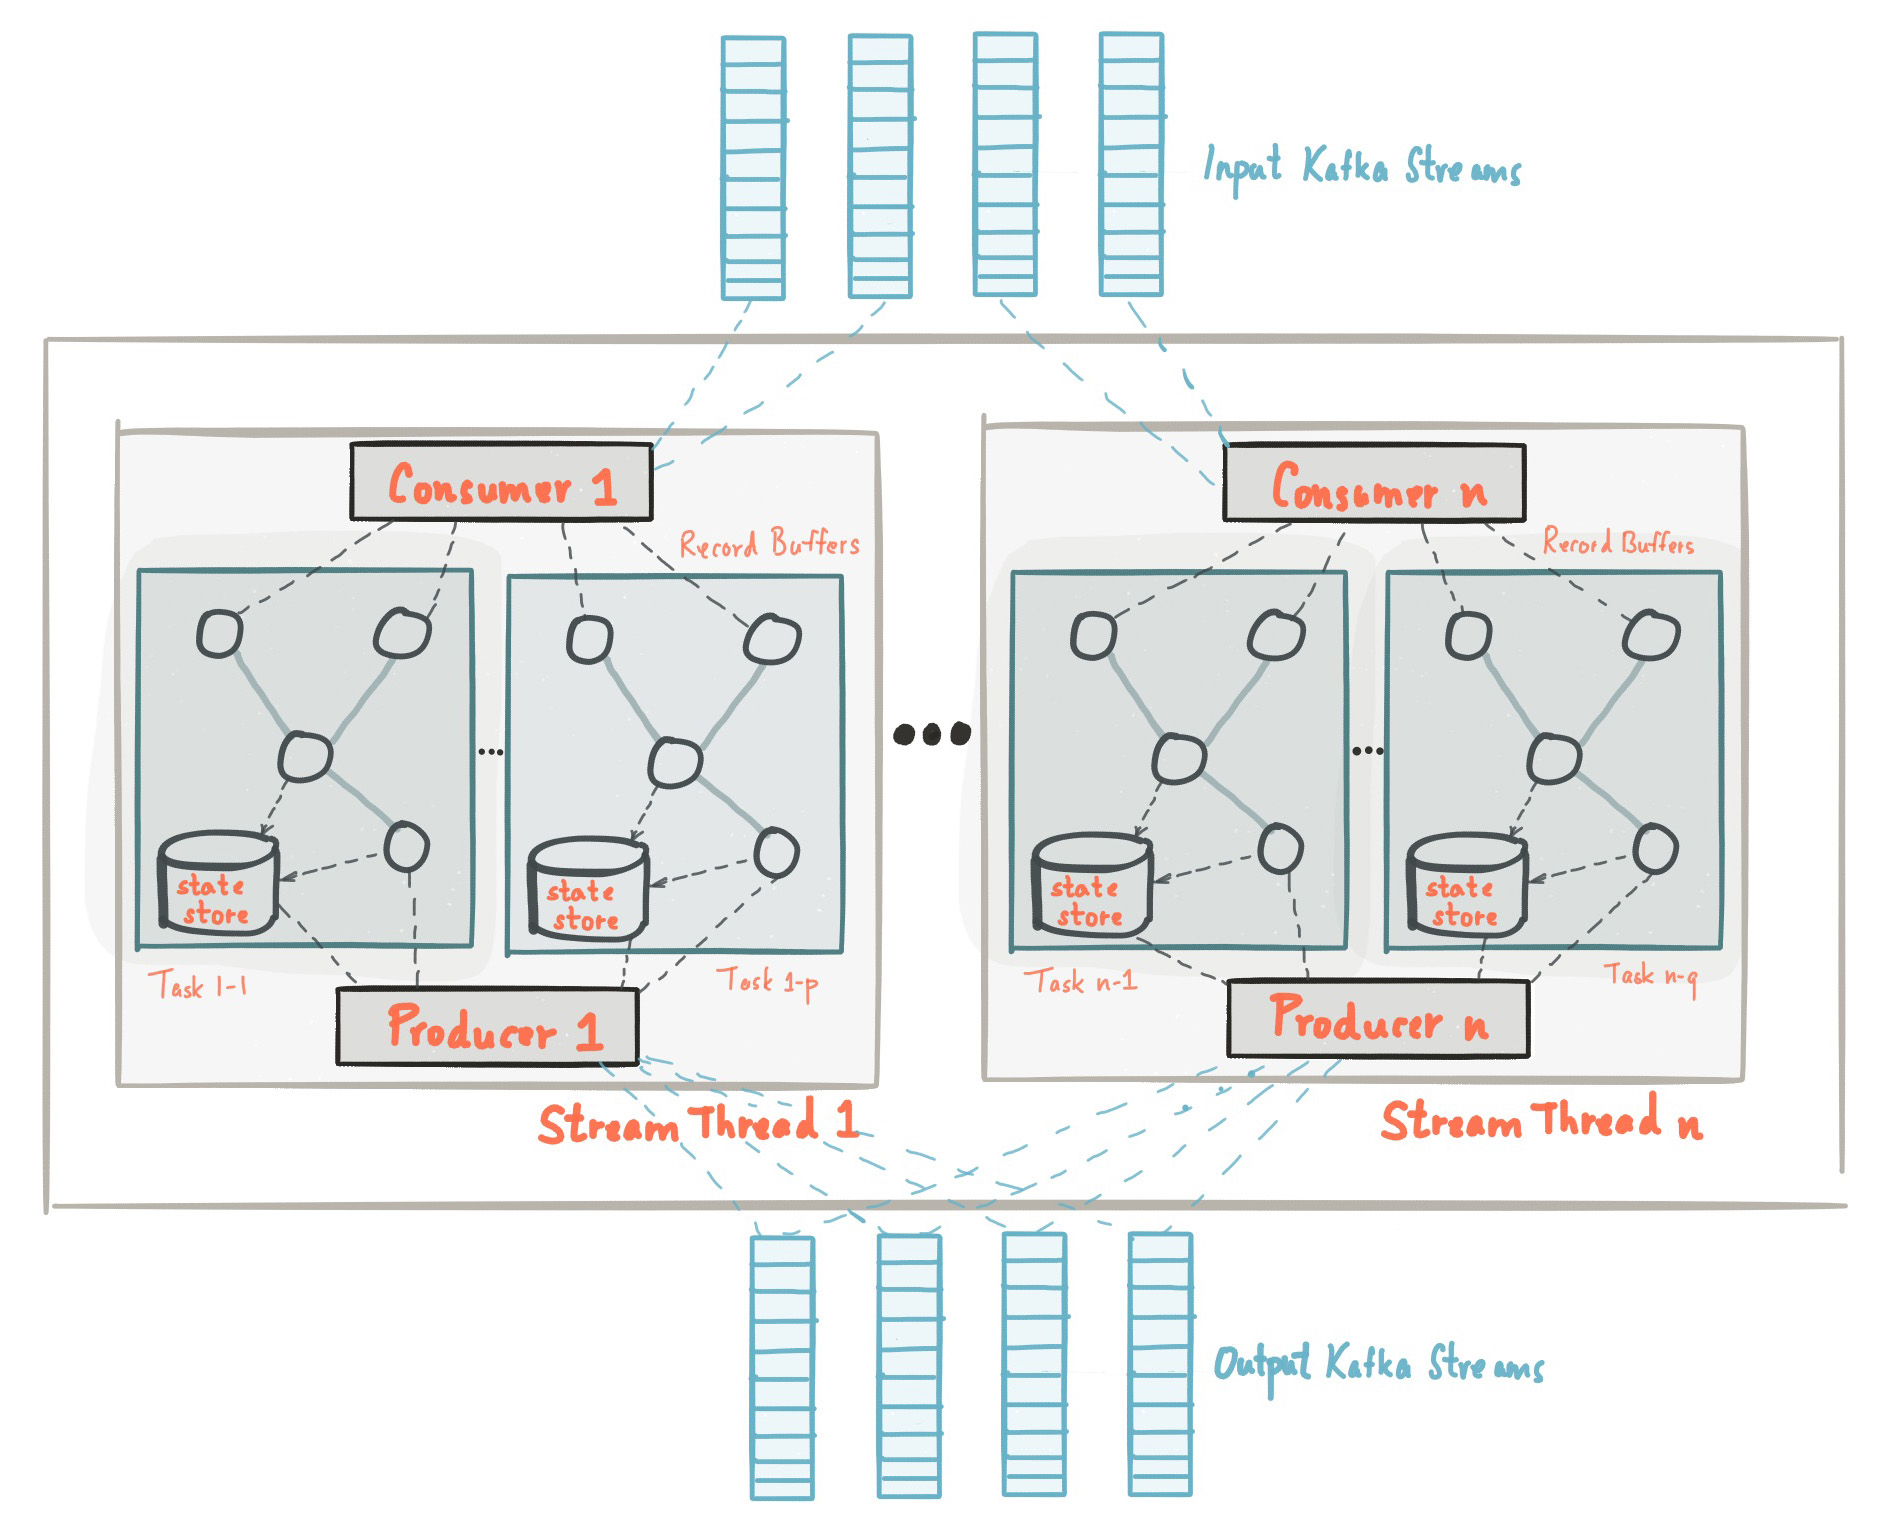
Kafka Streams là thư viện Java/Scala để xây dựng ứng dụng xử lý stream trực tiếp. Không cần cần cụm riêng biệt — chỉ cần ứng dụng Java với Kafka client.
Kafka Streams hỗ trợ: filter, map, flatMap, join, aggregate, windowing, và sessionization. Dữ liệu state được lưu trong changelog topics Kafka, đảm bảo fault-tolerance.
Ứng dụng phổ biến: real-time analytics, fraud detection, IoT data processing.
Ứng Dụng Thực Tế
- Log Aggregation: Thu thập log từ hàng nghìn server vào một kho tập trung (thay thế ELK ở quy mô lớn).
- Event Sourcing: Lưu trữ mọi thay đổi trạng thái dưới dạng sự kiện, phục vụ tái tạo trạng thái bất cứ lúc nào.
- Stream Processing: Xử lý và phân tích dữ liệu real-time với Kafka Streams hoặc Apache Flink.
- Message Queuing: Decouple producer và consumer, đảm bảo không mất dữ liệu khi hệ thống downstream gặp sự cố.
- Change Data Capture (CDC): Bắt buộc thay đổi từ database và phát đến các hệ thống khác qua Kafka Connect (với Debezium).
- IoT: Thu thập telemetry từ hàng triệu thiết bị IoT theo thời gian thực.
So Sánh Kafka Với Message Queue Truyền Thống
| Tiêu chí | Kafka | RabbitMQ |
|---|---|---|
| Mô hình | Event streaming, lưu trữ dài hạn | Message queue, xóa sau đọc |
| Thông lượng | Triệu message/giây | Hàng chục nghìn/giây |
| Thứ tự | Đảm bảo trong partition | Tùy cấu hình |
| Replay | ✓ Consumer đọc lại được | ✗ |
| Re consumer | ✓ Nhiều group đọc cùng data | ✓ (competing consumers) |
| Persistence | Disk-based, durable | Memory/disk, queue-based |
Bắt Đầu Với Kafka
# Chạy Kafka với Docker
docker-compose up -d zookeeper kafka

# Tạo topic
kafka-topics.sh --create --topic my-topic --bootstrap-server localhost:9092

# Gửi sự kiện
kafka-console-producer.sh --topic my-topic --bootstrap-server localhost:9092

# Đọc sự kiện
kafka-console-consumer.sh --topic my-topic --from-beginning --bootstrap-server localhost:9092
Tài Nguyên Tham Khảo
Tìm hiểu thêm tại https://kafka.apache.org/documentation/.