RAG trong LLM: Kết nối kiến thức bên ngoài để AI thông minh hơn
Large Language Model (LLM) như GPT, Llama, Claude đã cách mạng hoá cách chúng ta tương tác với thông tin. Tuy nhiên, những mô hình này mang trong mình một hạn chế cơ bản: kiến thức của chúng bị “đóng băng” tại thời điểm huấn luyện. Điều này đồng nghĩa với việc chúng không nắm bắt được thông tin mới sau ngày dóng băng, hoặc những dữ liệu nội bộ do doanh nghiệp sở hữu. RAG (Retrieval-Augmented Generation) xuất hiện như một giải pháp đổi mới, cho phép LLM kết nối đến nguồn kiến thức bên ngoài ngay tại thời điểm phản hồi.
Kỹ thuật RAG kết hợp hai bước: tìm kiếm thông tin liên quan từ cơ sở dữ liệu hoặc tài liệu do người dùng cung cấp, sau đó đưa những thông tin này vào prompt để LLM sinh ra câu trả lời chính xác và cập nhật. Với RAG, chatbot có thể truy cập tài liệu nội bộ công ty, dữ liệu khách hàng, hoặc các bài báo mới nhất mà không cần phải huấn luyện lại toàn bộ mô hình.
Kiến trúc cơ bản của hệ thống RAG
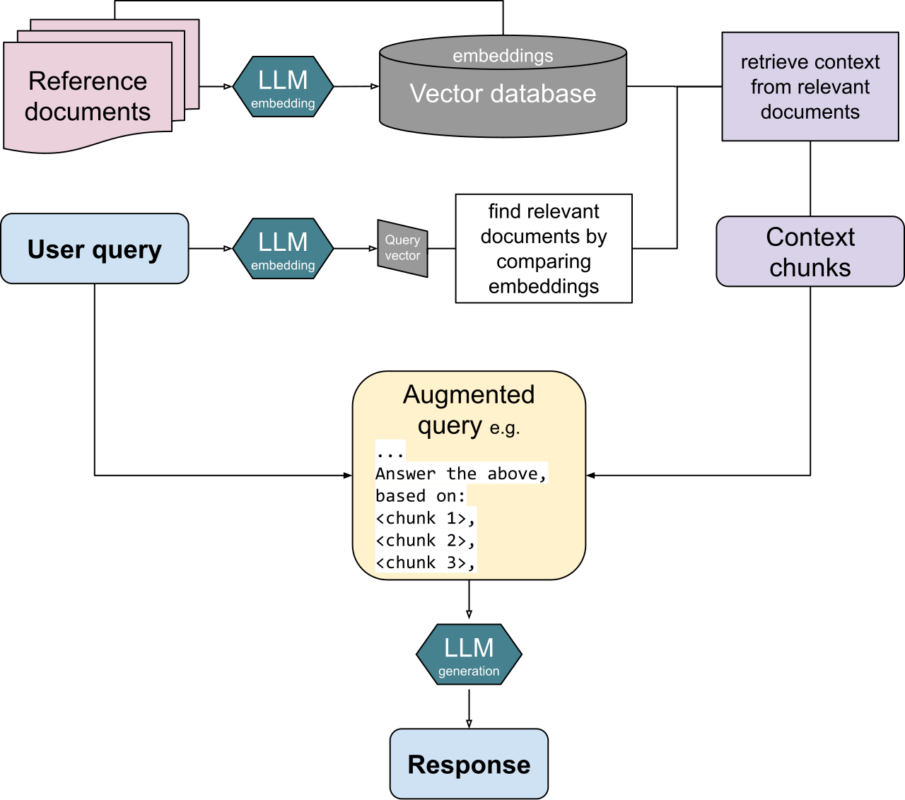
Một hệ thống RAG điển hình bao gồm ba thành phần chính: truy vấn (query), bộ truy xuất (retriever), và bộ sinh (generator). Khi người dùng đưa ra một câu hỏi, bộ truy xuất sẽ tìm kiếm những đoạn văn bản liên quan nhất từ cơ sở tri thức bên ngoài. Những đoạn đã được truy xuất này sau đó được chèn vào prompt gốc, tạo thành một prompt phong phú hơn trước khi được đưa vào LLM để sinh câu trả lời.
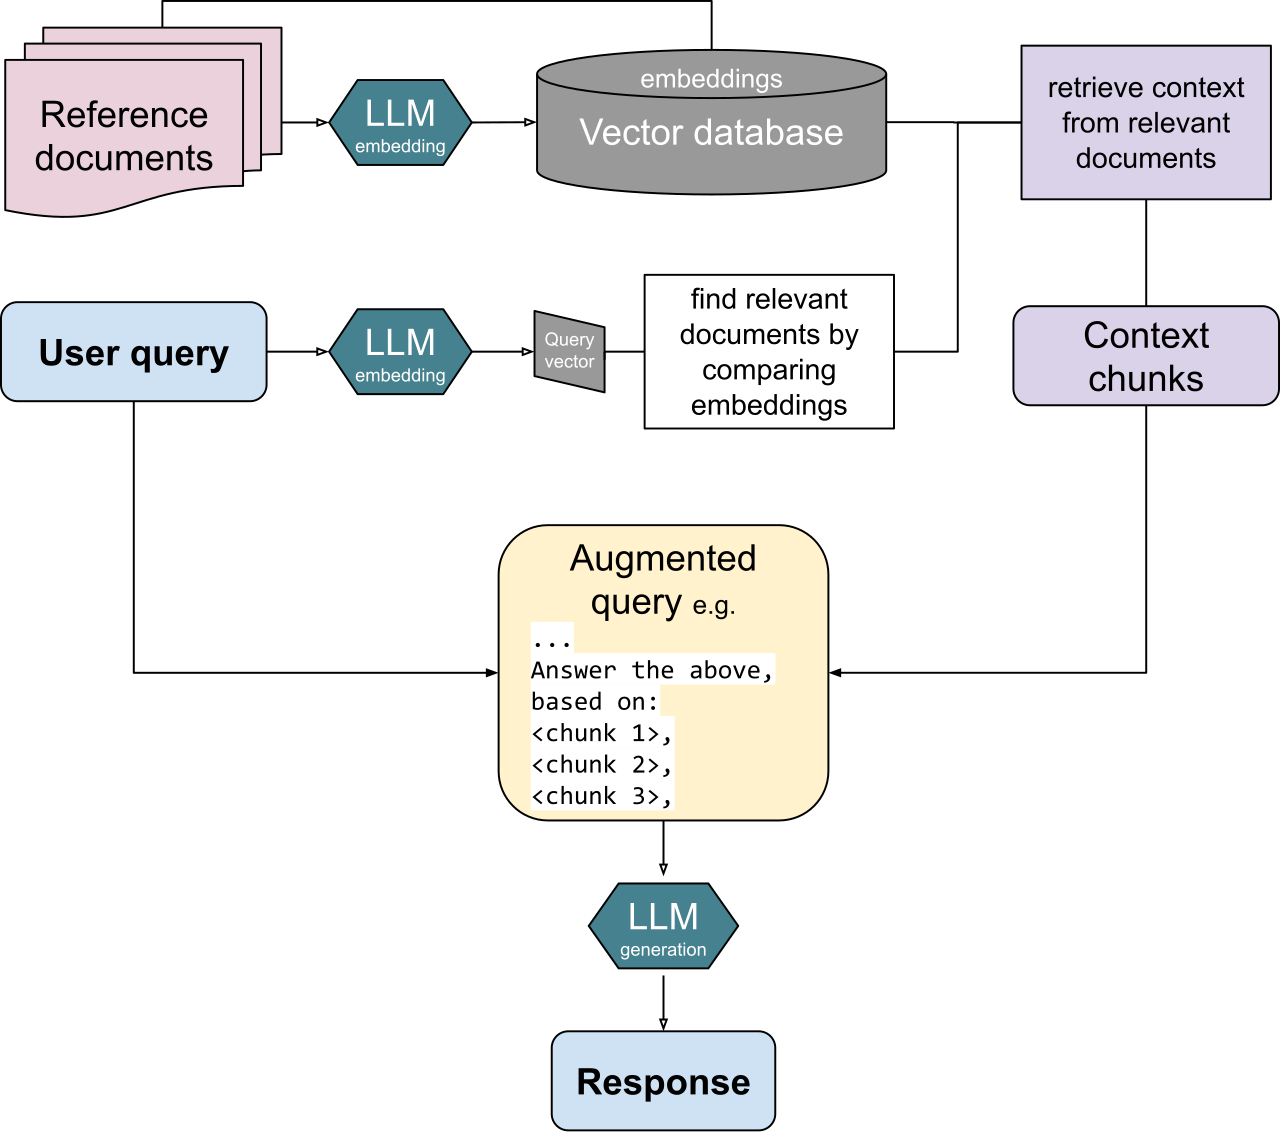
Quá trình này bắt đầu với việc chuyển đổi tài liệu thành dạng vector thông qua các mô hình embeddings như OpenAI embeddings, Cohere, hay Sentence-BERT. Các vector này được lưu trữ trong một vector database như Pinecone, Weaviate, FAISS, hoặc Qdrant. Khi một câu truy vấn mới đến, nó cũng được mã hóa thành vector và so sánh độ tương đồng với các vector đã lưu trữ để tìm ra những đoạn nội dung liên quan nhất.
Các cải tiến trong RAG hiện đại
Những phiên bản RAG cơ bản đã nhanh chóng gặp hạn chế khi câu truy vấn phức tạp hoặc yêu cầu hiểu biết sâu rộng. Các nhà nghiên cứu đã đưa ra nhiều cải tiến để khắc phục:
Hybrid Retrieval
Phương pháp này kết hợp hai dạng tìm kiếm: tìm kiếm dựa trên embeddings (dense retrieval) và tìm kiếm dựa trên từ khóa (sparse retrieval như BM25). Dense retrieval tìm kiếm dựa trên ngĩ nghĩa văn bản, trong khi sparse retrieval tìm kiếm dựa trên sự trùng khớp từ khóa. Kết hợp cả hai, hệ thống có thể bắt được cả các truy vấn tìm kiếm theo ngĩ nghĩa lẫn các truy vấn cần từ khóa chính xác.
Query Expansion
Thay vì sử dụng truy vấn gốc để tìm kiếm, RAG hiện đại thường mở rộng câu truy vấn thành nhiều dạng biến thể khác nhau. Ví dụ, câu hỏi “Làm sao tạo Docker image?” có thể được mở rộng thành “Cách tạo image Docker từ Dockerfile”, “Build Docker image command”, “Docker image creation tutorial”. Điều này giúp hệ thống tìm kiếm được nhiều tài liệu liên quan hơn.
Thách thức và hạn chế
Mặc dù RAG mang lại nhiều lợi ích, nhưng nó cũng không phải là giải pháp hoàn hảo. Một số thách thức chính bao gồm:
- Độ trễ (Latency): Bước truy xuất thông tin thêm vào làm tăng thời gian phản hồi so với LLM thuần.
- Chất lượng tài liệu: Nếu cơ sở tri thức chứa thông tin sai lệch hoặc lỗi thời, RAG sẽ “kéo theo” những sai lệch ấy.
- Context window: Khi tài liệu truy xuất quá dài, chúng có thể vượ quá giới hạn token của LLM.
- Retrieval failure: Nếu hệ thống không tìm thấy tài liệu liên quan, LLM sẽ vẫn sinh ra câu trả lời dựa trên kiến thức huấn luyện, tiềm ẩn gây “ảo giác”.
Ứng dụng thực tế
RAG đang được áp dụng rộng rãi trong nhiều lĩnh vực. Trong doanh nghiệp, các chatbot hỗ trợ khách hàng nội bộ sử dụng RAG để truy cập cơ sở tri thức nội bộ. Trong y tế, hệ thống chẩn đoán hỗ trợ bác sĩ bằng cách truy xuất các báo cáo y học và công trình nghiên cứu. Trong giáo dục, trợ lý ảo RAG giúp sinh viên tìm kiếm tài liệu học thuật chính xác và cập nhật.
Đối với các nền tảng như LlamaIndex và LangChain, RAG đã trở thành khung phát triển tiêu chuẩn, cung cấp các công cụ tích hợp sẵn cho embedding, quản lý vector database, và orchestration.
Tương lai của RAG
Tương lai của RAG hướng đến việc tích hợp sâu hơn với các kiến trúc multi-agent, nơi nhiều bộ truy xuất chuyên biệt hợp tác cùng nhau. Nghiên cứu đang tiến triển trong lĩnh vực prompt-stuffing — kỹ thuật thêm ngữ cảnh liên quan vào prompt để hướng dẫn LLM ưu tiên thông tin từ nguồn bên ngoài. Paraphrasing và self-reranking cũng là những xu hướng được quan tâm để nâng cao độ chính xác của việc truy xuất.
Kết luận
RAG biểu diễn một bước chuyển đổi quan trọng trong lĩnh trường AI, cho phép LLM tiếp cận thông tin đời thực mà không cần huấn luyện lại từ đầu. Với sự phát triển của embedding models và vector databases, RAG đang trở thành nền tảng cho những ứng dụng AI thông minh, linh hoạt và đáng tin cậy hơn. Tuy còn những thách thức cần khắc phục, nhưng tiềm năng của RAG trong việc kết nối trí tuệ nhân tạo với kiến thức thế giới thực là không thể phủ nhận.
Đối với nhà phát triển, việc nắm vững RAG trở thành bắt buộc khi số lượng công ty chuyển đổi sang kiến trúc retrieval-augmented ngày càng đông. Các framework như LangChain, LlamaIndex, và Haystack cung cấp những công cụ mạnh mẽ để xây dựng hệ thống RAG từ con số 0, từ đó giảm thiểu chi phí nghiên cứu và phát triển sản phẩm.