Qwen 3 là thế hệ lớp mới nhất của dòng mô hình ngôn ngữ lớn (Large Language Model – LLM) do Alibaba phát triển. Đây là bản nâng cấp đáng chú ý với sự hỗ trợ cho cả các mô hình dense và mixture-of-experts (MoE), mang lại khả năng lý luận mạnh mẽ, khả năng theo dõi hướng dẫn tốt và hỗ trợ đa dạng hơn 100 ngôn ngữ. Qwen 3 không chỉ nổi bật với hiệu suất cao mà còn được thiết kế để hỗ trợ cả chế độ suy nghĩ (thinking) và chế độ không suy nghĩ (non-thinking), giúp người dùng linh hoạt chuyển đổi tùi theo nhu cầu sử dụng.
Dòng mô hình Qwen 3 được phát hành bởi nhóm nghiên cứu Qwen từ Alibaba, với mục tiêu đẩy mạnh ứng dụng trí tuệ nhân tạo mở nguồn. Với các tính năng vượ trội như khả năng lý luận, theo dõi hướng dẫn cầm quyền, và hỗ trợ công cụ bên ngoài (agentic capabilities), Qwen 3 đang trở thành một lựa chọn hàng đầu cho các dự án AI mã nguồn mở. Bài viết dưới đây sẽ phân tích chi tiết các tính năng, kiến trúc và cách sử dụng Qwen 3.
Tính năng chuyển đổi giữa chế độ thinking và non-thinking
Một trong những đột phá nổi bật nhất của Qwen 3 là khả năng chuyển đổi suôn sẻ giữa chế độ thinking và non-thinking trong một mô hình duy nhất. Trong khi các mô hình truyền thống thường cần hai mô hình riêng biệt cho lý luận phức tạp và đối thoại thông thường, Qwen 3 cho phép người dùng bật hoặc tắt chế độ suy nghĩ tùy theo nhu cầu, mà không cần tải lại mô hình.
- Chế độ thinking: Dành cho các bài toán logic phức tạp, toán học, và lập trình — mô hình sẽ “nghĩ” trước khi trả lời, đư ra kết quả chính xác hơn.
- Chế độ non-thinking: Phù hợp cho đối thoại thông thường, sáng tạo, và các yêu cầu cần phản hồi nhanh — tiết kiệm thời gian và tài nguyên tính toán.
Kiến trúc mô hình: Dense và Mixture of Experts
Qwen 3 cung cấp một bộ sưu tập toàn diện gồm cả mô hình dense (dày đặc) và mô hình MoE (Mixture of Experts). Các mô hình này được huấn luyện trên quy mô lớn với hơn 100 ngôn ngữ, bao gồm tiếng Việt, giúp hỗ trợ tốt cho nội dung đa ngôn ngữ.
Mẫu mẫu tiêu biểu Qwen3-8B có các thông số kỹ thuật như sau:
- Loại: Mô hình ngôn ngữ causal (Causal Language Models)
- Số tham số: 8,2 tỷ (8.2B params, không tính embedding)
- Số tầng (layers): 36
- Số đầu chú ý (GQA): 32 cho truy vấn, 8 cho khóa-giá trị
- Độ dài ngữ cảnh: 32,768 token (hỗ trợ lên 131,072 token với YaRN)
Thinking Budget: Cân bằng giữa độ chính xác và chi phí
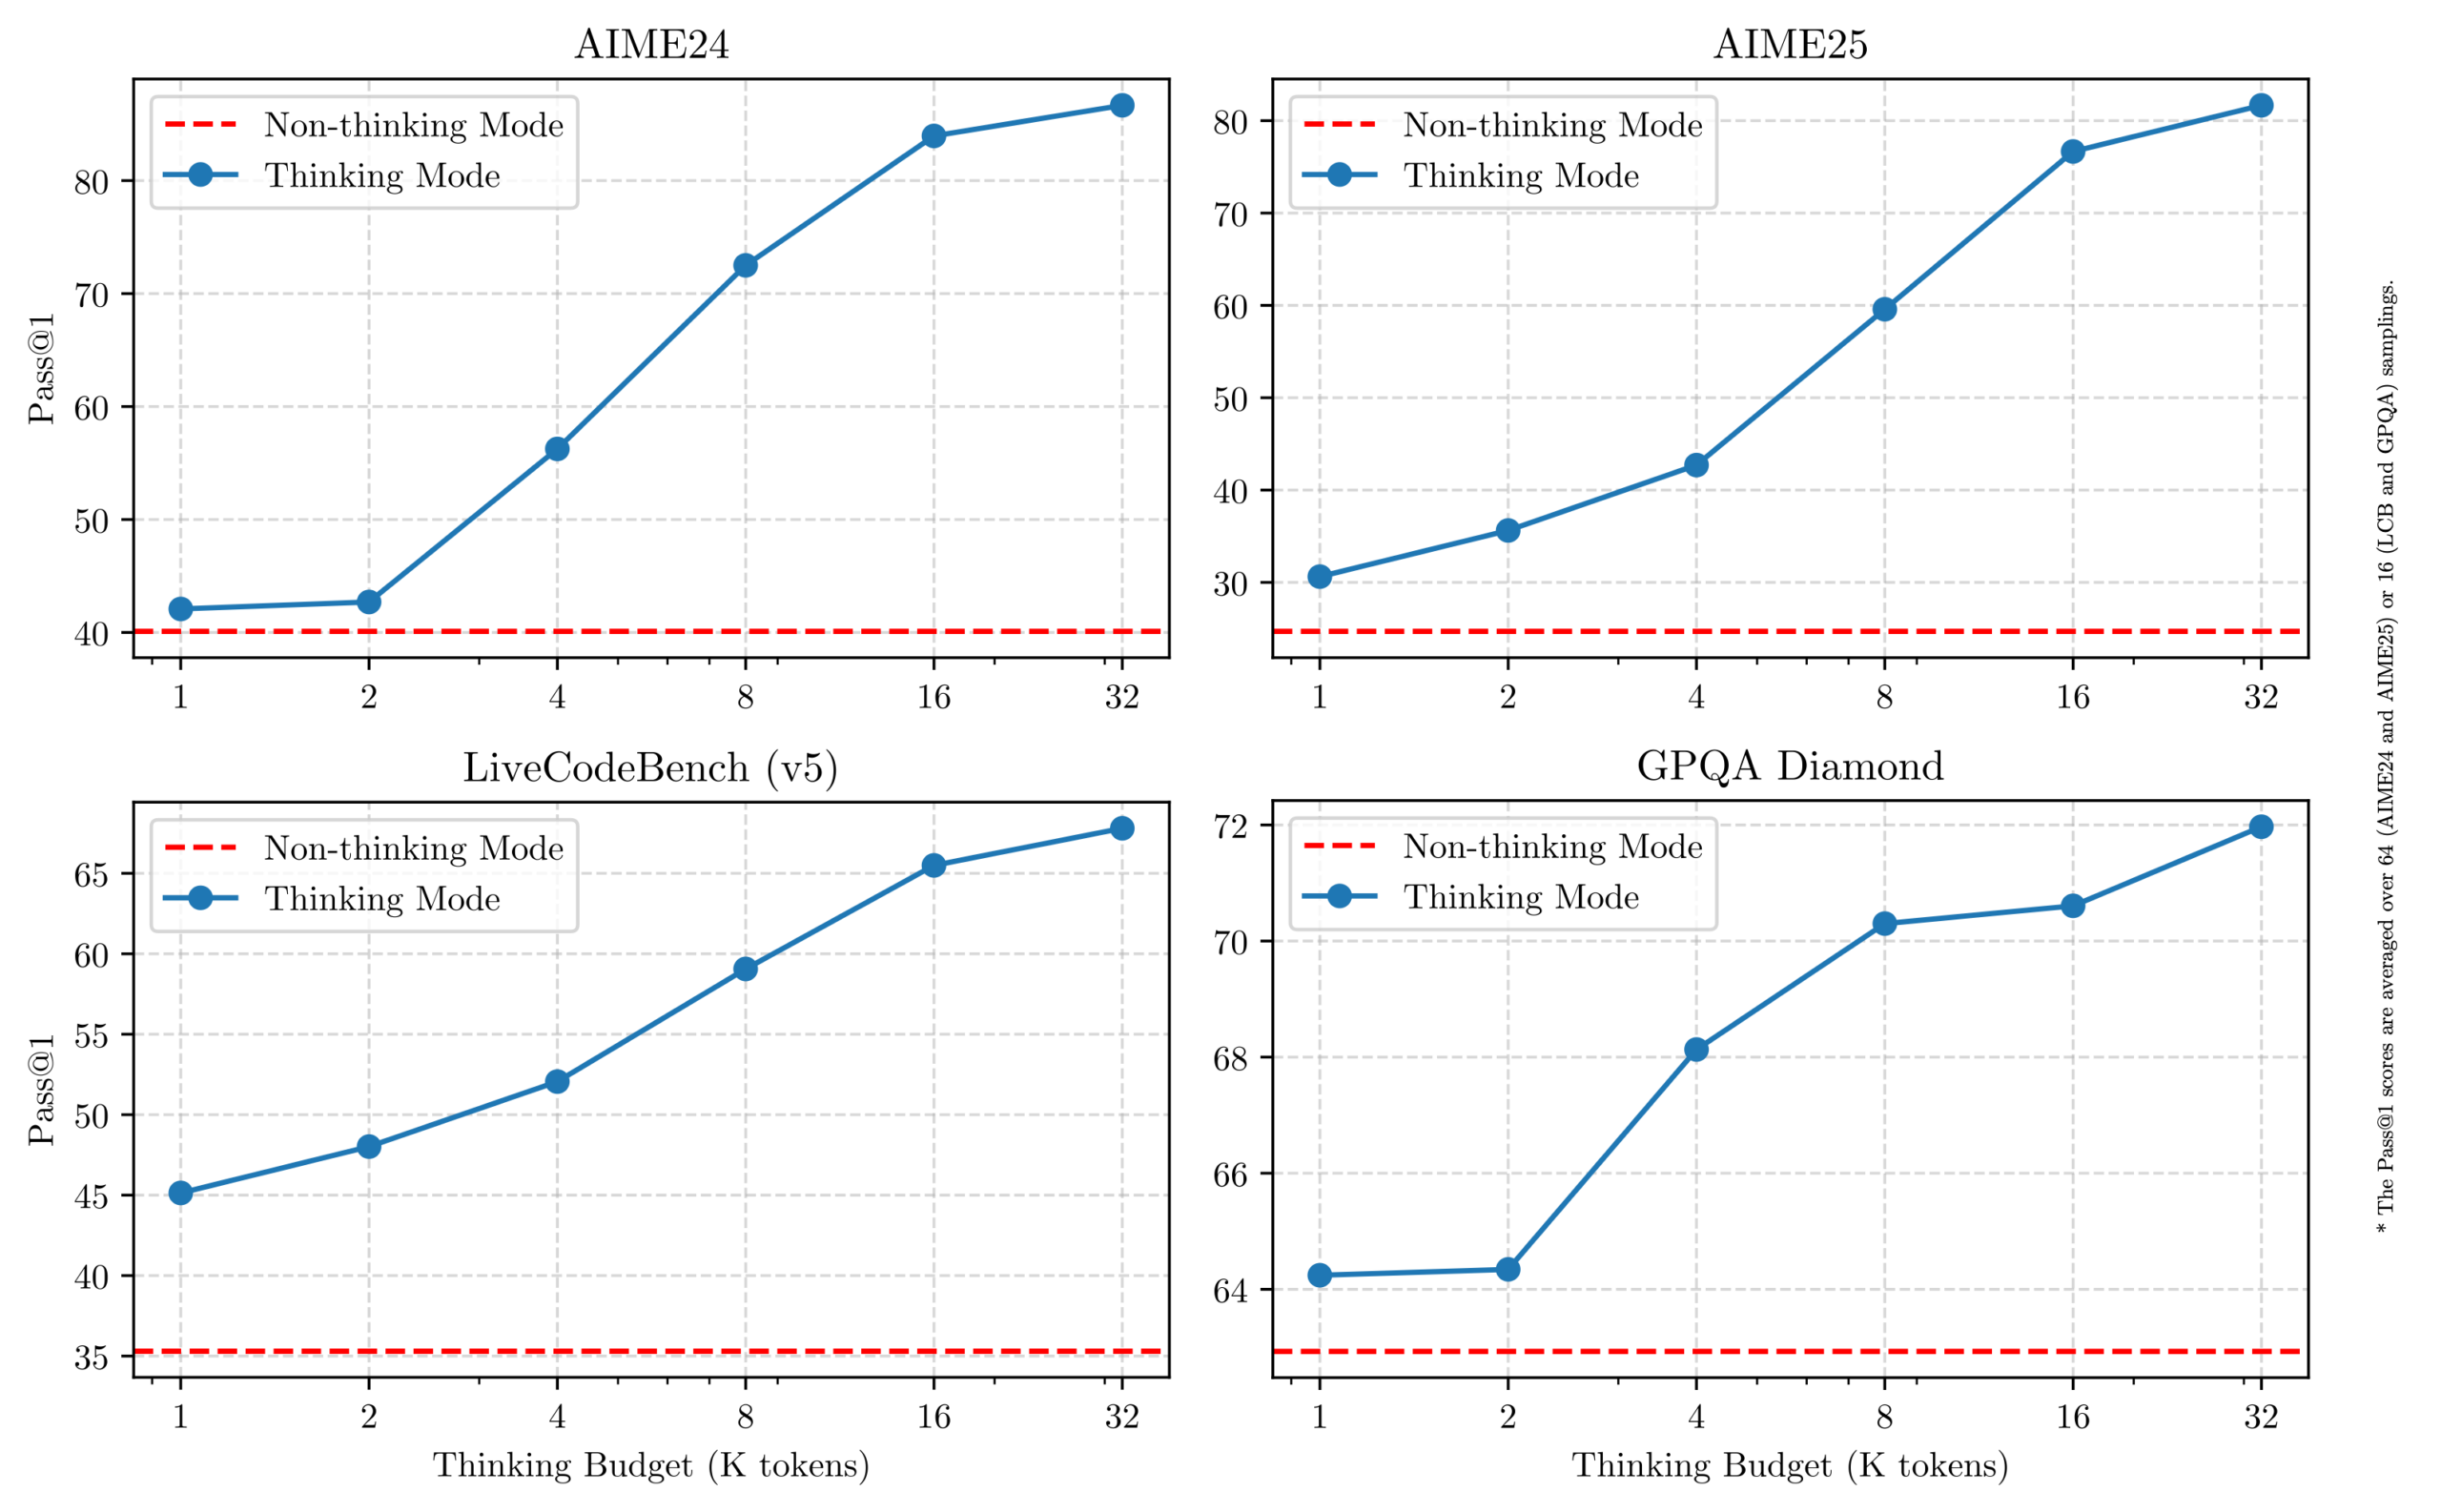
Một cấu hình quan trọng trong Qwen 3 là thinking budget — ngân sách dành cho quá trình suy nghĩ. Người dùng có thể điều chỉnh số token tối đa mà mô hình dùng để “nghĩ” trước khi đưa ra câu trả lời, tùy chỉnh theo từng nhiệm vụ:
- Budget cao: Dành cho câu hỏi phức tạp, cần lý luận sâu (toán học, lập trình, giải thích khoa học).
- Budget thấp hoặc 0: Dành cho đối thoại nhanh, tóm tắt, và các tác vụ yêu cầu phản hồi ngay lập tức.
Hỗ trợ agent và công cụ bên ngoài
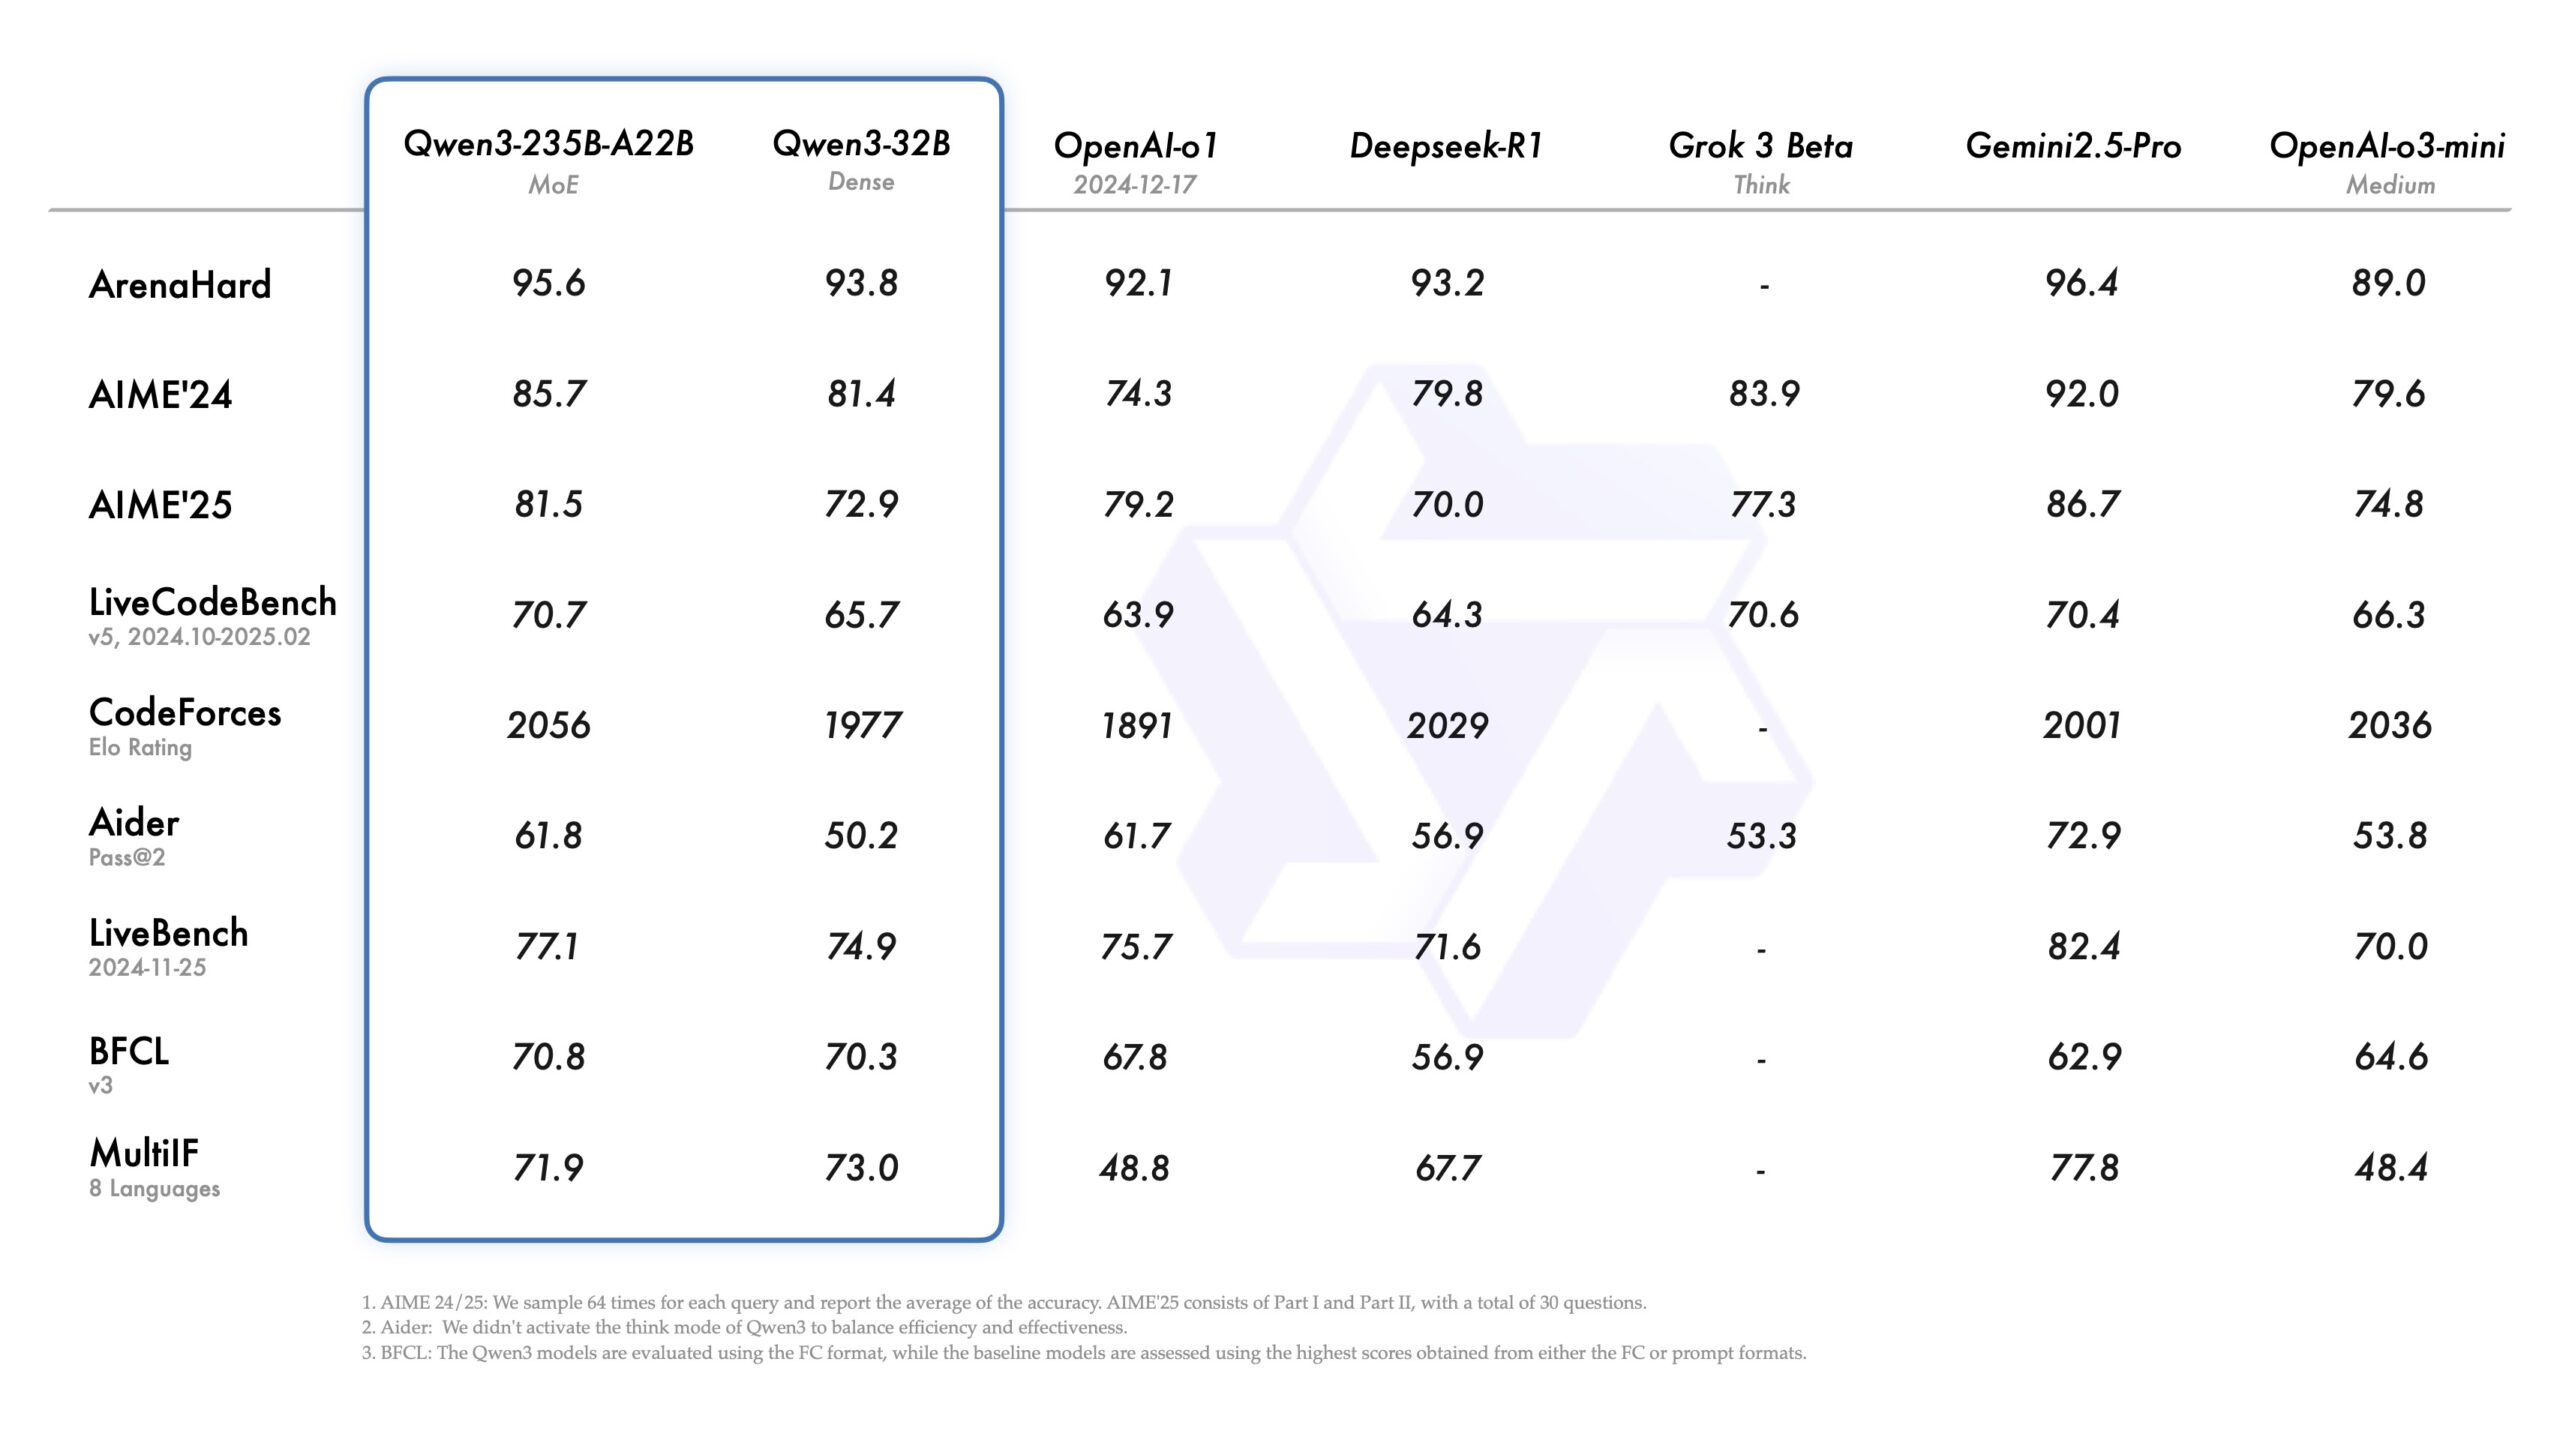
Qwen 3 được tích hợp khả năng agentic capabilities mạnh mẽ, cho phép kết nối với các công cụ bên ngoài như API, cơ sở dữ liệu, hoặc môi trường thực thi. Trong cả hai chế độ thinking và non-thinking, Qwen 3 đều đạt hiệu suất hàng đầu trong các bài kiểm tra agent phức tạp.
Nhờ vào Hugging Face, người dùng có thể dễ dàng tải về và chạy Qwen 3 trên máy cục bộ hoặc môi trường đám mây. Các mô hình được hỗ trợ bởi transformers phiên bản 4.51.0 trở lên, đảm bảo tính tương thích và dễ dàng tích hợp vào dự án hiện có.
Cách sử dụng nhanh Qwen 3 trên Hugging Face
from transformers import AutoModelForCausalLM, AutoTokenizer

model_name = "Qwen/Qwen3-8B"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name, torch_dtype="auto", device_map="auto"
)

prompt = "Giải thích khái niệm Layer 2 blockchain là gì?"
messages = [{"role": "user", "content": prompt}]
text = tokenizer.apply_chat_template(
    messages, tokenize=False,
    add_generation_prompt=True,
    enable_thinking=True  # Bật chế độ suy nghĩ
)
Kết luận
Qwen 3 đại diện cho một bước nhảy vọt trong việc phát triển mô hình ngôn ngữ lớn mã nguồn mở. Với khả năng chuyển đổi thinking/non-thinking, hỗ trợ 100+ ngôn ngữ, và kiến trúc MoE linh hoạt, Qwen 3 phù hợp cho cả nghiên cứu và ứng dụng thương mại. Nhờ sự hỗ trợ từ cộng đồng Hugging Face và tài liệu chi tiết trên qwen.ai, việc tích hợp Qwen 3 vào dự án AI trở nên nhanh chóng và tiết kiệm chi phí.