Apache Kafka là nền tảng xử lý sự kiện thời gian thực được thiết kế cho độ tin cậy cao, mở rộng ngang và lưu trữ lâu dài. Ban đầu phát triển tại LinkedIn, hiện là dự án Apache hàng đầu với hơn 8000 đóng góp, Kafka trở thành cốt lõi của rất nhiều hệ thống microservice, streaming ETL và data lake hiện đại. Bạn có thể tham khảo tài liệu chính thức của Apache Kafka và bài giới thiệu kiến trúc để đào sâu thêm.
Kafka là gì, dùng làm gì
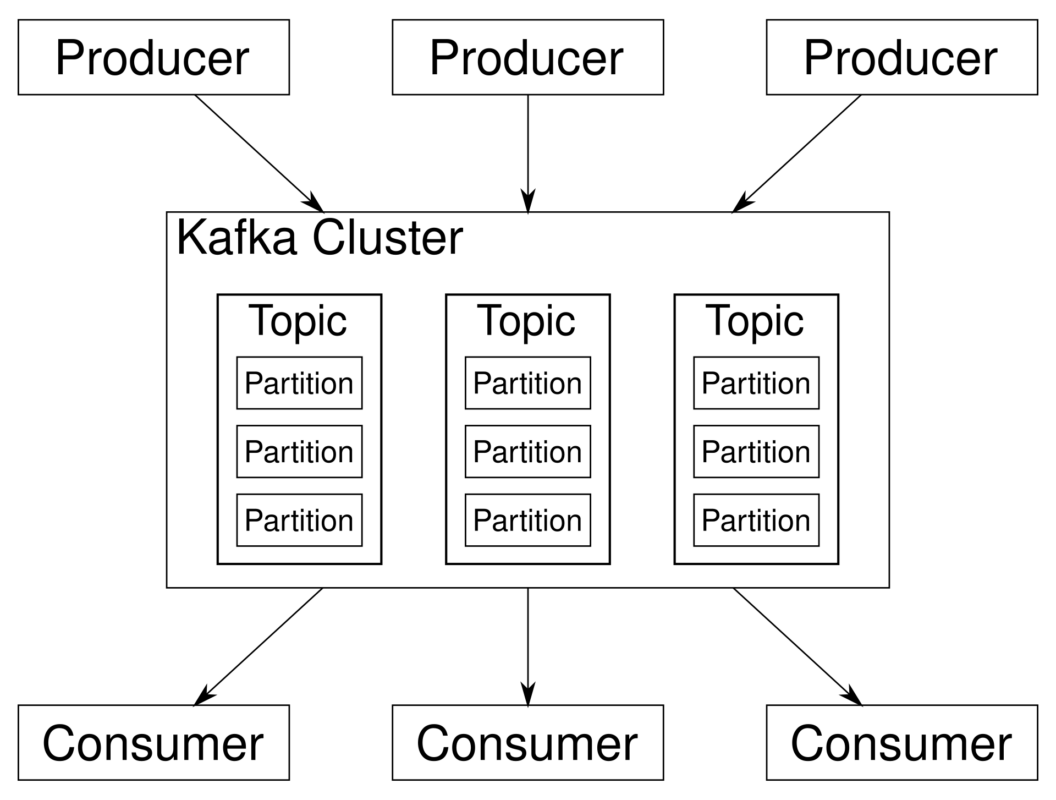
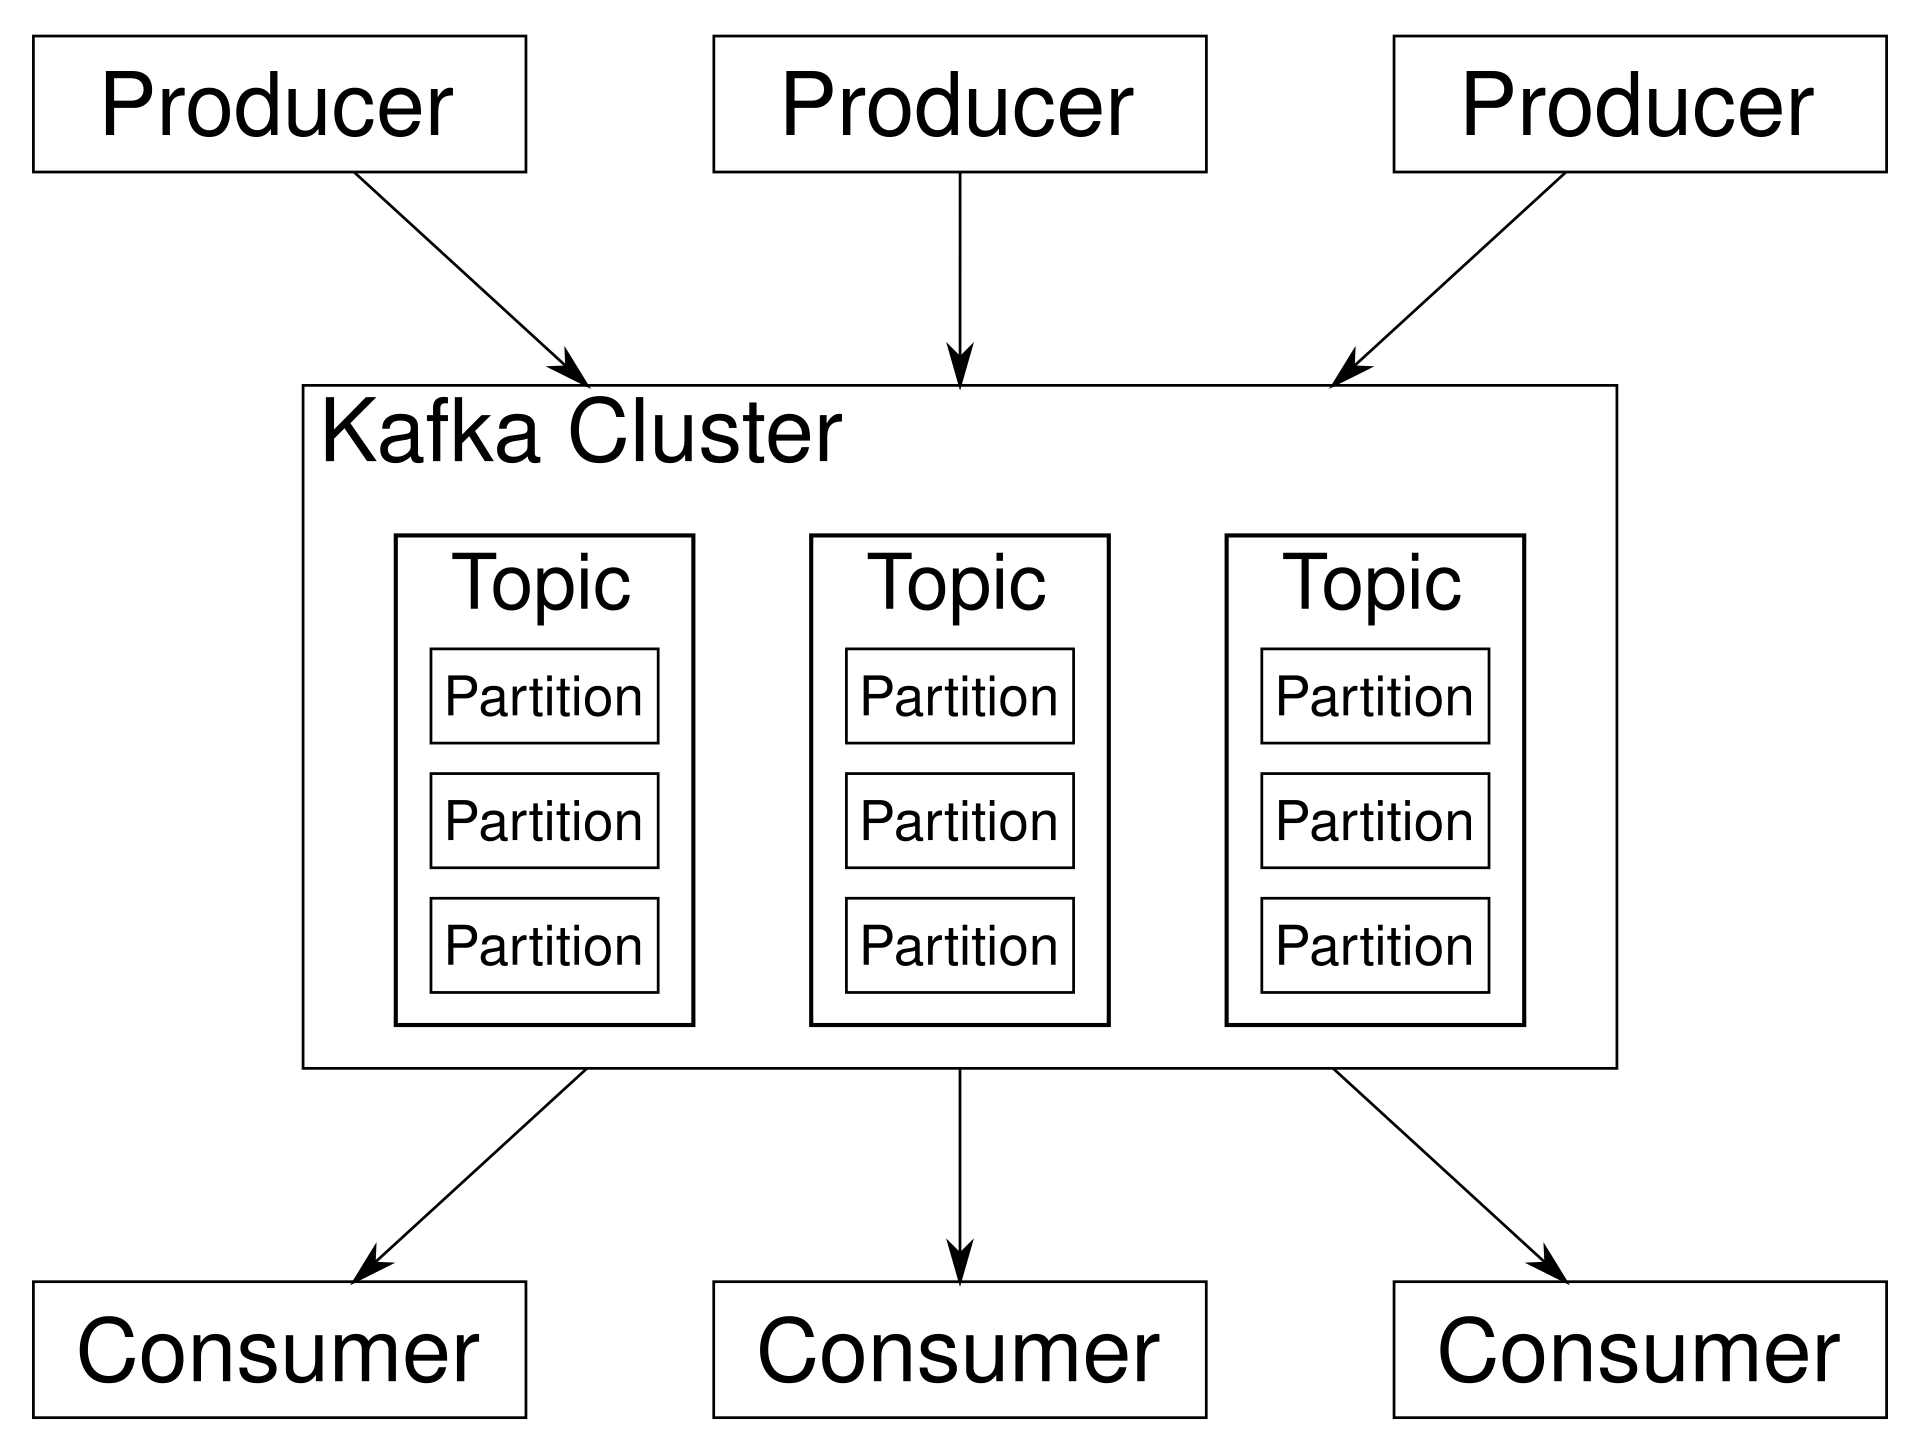
Kafka mô hình hóa mỗi luồng dữ liệu như một topic, mỗi topic được chia thành một số partition để cho phép xử lý song song. Mỗi partition là một log ghi tiếp (append-only) được sao chép (replicated) để chịu lỗi. Ứng dụng tạo ra dữ liệu là producer, ứng dụng đọc là consumer, cả hai kết nối tới Kafka cluster qua TCP.
Kafka giải quyết ba vấn đề chính của các hệ thống chia sẻ dữ liệu truyền thống:
- Giảm phụ thuộc trực tiếp: ứng dụng không còn cần gọi trực tiếp vào nhau, mà viết đọc vào topic; consumer tự lấy từ log.
- Đảm bảo thứ tự trong mỗi partition: tất cả ghi vào một partition được lưu trữ theo đúng thời gian, consumer đọc sẽ thấy thứ tự không đổi.
- Lưu trữ dài hạn và khả năng phát lại: dữ liệu có thể được lưu trong ngày, tuần hoặc cả năm, cho phép consumer mới tham gia và đọc lại toàn bộ lịch sử.
Các khái niệm cốt lõi
Topic và Partition
Một topic có thể có từ một đến hàng nghìn partition. Số partition quyết định mức độ song song tối đa: mỗi consumer trong một consumer group chỉ được gán một số partition nhất định, và tổng số consumer hoạt động không vượt quá số partition.
Việc chọn số partition cần cân bằng: quá ít sẽ hạn chế throughput, quá nhiều sẽ tăngภาระ metadata và thời gian cân bằng lại khi broker thay đổi.
Broker và sao chép (replication)
Mỗi broker là một máy chủ trong cluster, lưu trữ một tập hợp partition. Để chịu lỗi, mỗi partition được sao chép ra N-1 broker khác (phiên bản replication factor). Một trong số những bản sao được đánh dấu là leader chịu trách nhiệm xử lý mọi yêu cầu ghi và đọc; các bản sao còn lại (follower) chỉ đồng bộ dữ liệu từ leader.
Khi leader thất bại, ZooKeeper (hoặc KRaft trong Kafka 3.3+) sẽ nhanh chóng bầu leader mới từ tập hợp các follower còn alive. Quá trình này thường mất dưới 5 giây và không làm mất dữ liệu vì dữ liệu đã được flushed vào disk trên ít nhất một broker.
Producer và cấu hình đáng chú ý
Producer có thể gửi tin nhắn theo ba chế độ xác nhận:
- acks=0: không chờ bất kỳ phản hồi nào, tốc độ nhanh nhất nhưng có thể mất tin nhất nếu broker chết ngay lập tức.
- acks=1: chờ leader ghi thành công vào log local, vừa đủ cho hầu hết trường hợp.
- acks=all (-1): chờ tất cả các bản sao đồng bộ in-sync ghi thành công, mức độ tin cậy cao nhất.
Ngoài ra, producer còn có thể nhóm (batch) tin nhắn và nén (gzip, snappy, lz4, zstd) để giảm băng thông mạng.
Consumer và mô hình poll-based
Không như các hệ thống hàng đợi truyền thống, consumer trong Kafka chủ động kéo (pull) dữ liệu từ broker. Mỗi consumer lưu trữ offset (vị trí log) của mỗi partition mà nó đang đọc. Offset được lưu trong một topic nội bộ __consumer_offsets (hoặc trong ZooKeeper cho phiên bản cũ). Nhờ cơ chế này, consumer có thể dừng, khởi động lại và tiếp tục đọc từ điểm cũ mà không mất tin nhắn.
Một consumer group có thể chứa nhiều consumerinstance; mỗi partition chỉ được gán cho một consumer duy nhất trong cùng group, đạt được xử lý song song mà không trùng lặp.
Luồng dữ liệu điển hình trong Kafka
Giả sử một ứng dụng frontend ghi log click vào topic user-clicks:
- Frontend producer tạo bản ghi JSON và gửi tới broker leader của partition 0.
- Broker leader ghi bản ghi vào log local, sau đó phản hồi lại producer.
- Hai broker follower đang lắng nghe thấy bản ghi mới, sao chép từ leader và lưu vào log của chúng.
- Một ứng dụng backend (consumer) trong group
analyticsgọi poll(), nhận được bản ghi, lưu vào cơ sở dữ liệu và cam kết offset. - Nếu consumer dies, một consumer instance khác trong cùng group sẽ tự động được gán partition 0 và tiếp tục đọc từ offset cuối cùng đã cam kết.
Ưu điểm và giới hạn thực tế
| Tiêu chí | Kafka | Hệ thống pub/sub truyền thống |
|---|---|---|
| Throughput | Hàng triệu tin/giây trên cluster vừa | Hạn chế bởi nút choke trung tâm |
| Trễ tin nhắn | Đơn vị mili-giây | Tùy nền tảng, thường cao hơn |
| Lưu trữ dữ liệu | Có thể vô hạn, tuỳ cấu hình log.retention | Thường lưu ngắn hạn hoặc không lưu |
| Khả năng chịu lỗi | Sao chép đa bản, tự động failover | Phụ thuộc vào nút trung tâm duy nhất |
| Mô hình streaming | Xử lý sự kiện thực time và batch trong cùng nền tảng | Chỉ một loại |
Nhược điểm chính của Kafka là độ phức latein vận hành: bạn cần quan sát lag consumer, skew partition, và thường xuyên cân bằng lại cluster sau khi thêm/bớt broker. Tuy nhiên, với hiện nay có các công cụ như Confluent Control Plane, LinkedIn Cruise Control và Strimzi operator trên Kubernetes, việc điều hành Kafka đã trở nên đơn giản hơn nhiều.
Kafka Streams và ksqlDB: lớp xử lý trên Kafka
Nếu bạn chỉ cần đơn giản như “đọc topic A, lọc, ghi ra topic B”, Kafka cung cấp hai lựa chọn:
- Kafka Streams: Thư viện Java cho phép bạn viết ứng dụng xử lý luồng như mã thông thường, với trạng thái local được lưu trữ qua changelog topic tự động.
- ksqlDB: Mô hình truy vấn như SQL cho streaming, cho phép bạn định nghĩa stream và table bằng cú pháp quen thuộc và thực thi liên tục trên Kafka.
Cả hai đều chạy như ứng dụng độc lập và có thể mở rộng ngang bằng cách tăng số instance.
Kafka trong hệ thống data lakehouse
Kafka thường vị trí trung tâm trong kiến trúc dữ liệu hiện đại:
- Nguồn dữ liệu (cảm biến, ứng dụng web, log server) ghi vào Kafka.
- Các công cụ như Kafka Connect lấy dữ liệu từ Kafka và đẩy vào data lake (S3, ADLS, GCS) hoặc warehouse (Snowflake, BigQuery, Redshift).
- Các công cụstream processing (Flink, Spark Structured Streaming) đọc trực tiếp từ Kafka để thực hiện biến đổi phức tạp.
- Data scientist và analyst truy vấn dữ liệu đã được cấp phát từ lakehouse bằng các công cụ như Trino, Presto hoặc Spark SQL.
Với mô hình này, Kafka đóng vai trò như “đơn vị tin cậy” giữa các hệ thống nhập và xuất, cho phép mỗi bên phát triển độc lập mà vẫn đảm bảo dữ liệu không mất và được xử lý theo đúng thứ tự.
Lời khuyên khi bắt đầu với Kafka
- Bắt đầu với ba broker (tối thiểu để thử replication factor = 3).
- Đặt num.partitions dựa trên mức throughput tối đa bạn mong đợi và số consumer song song.
- Điều chỉnh cấu hình log với
log.retention.hours=168(7 ngày) cho hầu hết các trường hợp. - Nếu chạy trên Kubernetes, cân nhắc dùng Strimzi hoặc AMQ Streams operator để tự động hóa triển khai và nâng cấp cluster.
- Bật nén ở phía producer, zstd thường là lựa chọn cân bằng giữa tốc độ và tỉ lệ nén.
Kafka đã chứng minh khả năng chịu đựng tải trọng của hàng tỷ sự kiện mỗi ngày trong các hệ thống thanh toán, logistics và IoT. Nhờ thiết kế log-centric và khả năng mở rộng ngang, nó sẽ còn là nền tảng không thể thay thế cho xử lý sự kiện thời gian thực trong nhiều năm tới.