Mixture of Experts là gì? Kiến trúc mô hình AI tiết kiệm tính toán
Mixture of Experts (MoE) là kiến trúc học máy cho phép mô hình mở rộng đến hàng chục tỷ tham số mà vẫn giữ được chi phí tính toán như một mô hình nhỏ hơn nhiều. Cốt lõi của kỹ thuật là thay một khối mạng nơ-ron chung bằng nhiều mạng con chuyên biệt, rồi chỉ kích hoạt một vài mạng con cho mỗi đầu vào.
Nguyên lý hoạt động
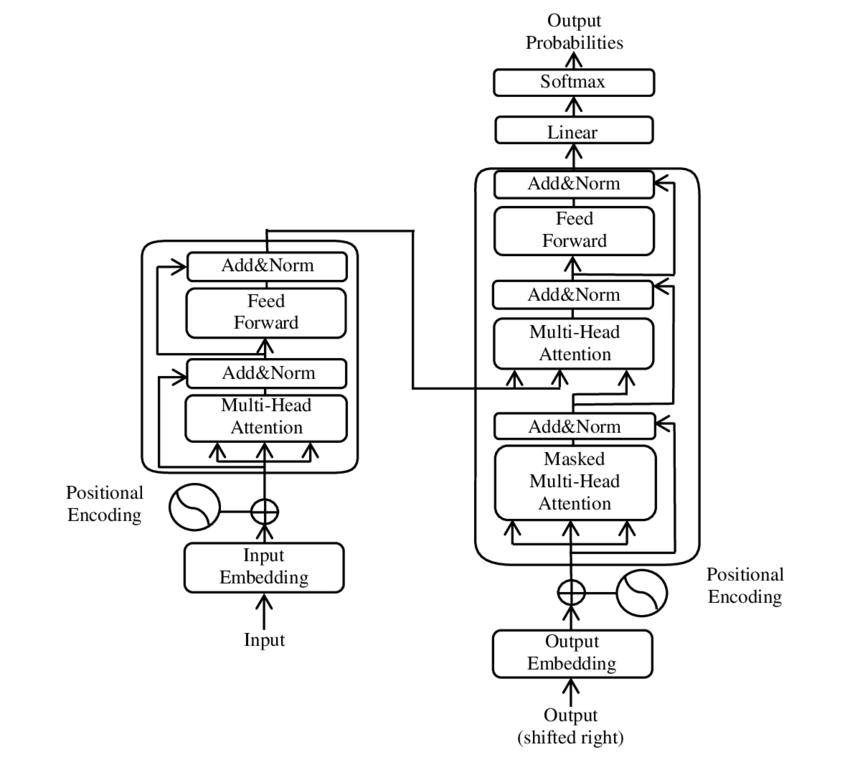
Một lớp MoE gồm hai phần chính. Phần thứ nhất là gating network, một mô hình nhỏ nhận biểu diễn của token và tính ra trọng số điều phối. Phần thứ hai là tập các expert, thường là các mạng feed-forward có cùng kích thước như khối FFN gốc trong Transformer.
Mỗi lần chạy, gating network chấm điểm toàn bộ các expert rồi chỉ chọn ra k expert cao điểm nhất, thường là k = 2. Token được xử lý song song qua những expert đã chọn, đầu ra được nhân với trọng số tương ứng rồi cộng lại. Những expert không được chọn không hề tham gia phép tính, nên tổng FLOPs tăng rất ít so với việc thêm chúng vào mô hình.
Vì sao MoE hiệu quả hơn mô hình dense
Một mô hình dense buộc phải dùng toàn bộ trọng số cho mọi token. Mô hình MoE tách bài toán thành các vùng chuyên biệt, giống cách một nhóm chuyên gia chia nhau phần việc. Nghiên cứu của Shazeer và cộng sự năm 2017 cho thấy MoE có thể mở rộng số tham số lên quy mô rất lớn chỉ với chi phí tính toán tuyến tính.
| Tiêu chí | Mô hình dense | Mô hình MoE |
|---|---|---|
| Tổng số tham số | Tăng đều cùng độ sâu | Tăng rất nhanh, không giới hạn như dense |
| Tham số kích hoạt mỗi token | Toàn bộ | Chỉ k expert trong tổng số |
| Chi phí suy luận | Tỉ lệ tuyến tính với tổng tham số | Gần như không đổi khi thêm expert |
| Bộ nhớ khi chạy | Thấp hơn | Cao hơn do phải lưu toàn bộ expert |
| Chuyên biệt hoá | Không tách biệt | Mỗi expert học một vùng ngôn ngữ |
Những thách thức thực tế
MoE không miễn phí. Ba vấn đề lớn nhất là:
- Cân bằng tải: gating network có xu hướng dồn token về vài expert, khiến phần còn lại kém học. Các nghiên cứu bổ sung một auxiliary loss để phạt sự lệch phân phối này.
- Băng thông liên node: mỗi token phải được gửi tới đúng node chứa expert tương ứng trong cụm máy, làm tăng chi phí mạng nội bộ.
- Bộ nhớ: toàn bộ expert phải nằm trong RAM hoặc được offload sang ổ đĩa, gây độ trễ khi chuyển đổi. Vì vậy MoE thường chỉ hợp lý với cụm máy lớn.
Bài Switch Transformers giải quyết phần đầu bằng routing một expert duy nhất cho mỗi token, giúp đào tạo nhanh hơn vài lần so với MoE cổ điển mà vẫn giữ chất lượng.
Ứng dụng thực tế
MoE đã được dùng trong nhiều mô hình lớn. Mixtral của Mistral là ví dụ nổi tiếng, với 8 expert và 2 expert được kích hoạt cho mỗi token. Nhờ đó, số tham số hoạt động chỉ bằng khoảng một phần ba tổng số tham số nhưng vẫn đạt chất lượng ngang các mô hình cùng hạng. DeepSeek-V3 cũng dùng kiến trúc MoE kèm cơ chế định tuyến tinh vi và nhiều chuyên gia dùng chung.
Trong lĩnh vực thị giác máy tính, nghiên cứu Sparsely-Gated Mixture-of-Experts Layers cho thấy MoE giúp giảm đáng kể sai số phân loại trên ImageNet với cùng ngân sách tính toán. Nguyên lý này cũng được áp dụng cho mô hình thị giác–ngôn ngữ đa phương thức.
Tóm tắt
Mixture of Experts biến mô hình AI từ một mạng liên tục thành một tập các chuyên gia được gọi đúng lúc. Đây là hướng đi để huấn luyện các mô hình ngôn ngữ lớn ngày càng mạnh mà không kéo theo chi phí tính toán tuyến tính.
MoE khác gì so với ensemble learning
Ý tưởng ghép nhiều mô hình nhỏ không hẳn là mới, ensemble learning từ lâu đã cho thấy việc kết hợp các mô hình đa dạng cho kết quả tốt hơn một mô hình đơn lẻ. Điểm khác biệt của MoE nằm ở chỗ các “chuyên gia” được chọn động ở tầng token thay vì gộp cố định ở tầng đầu ra, đồng thời chỉ một phần nhỏ tham số được kích hoạt cho mỗi đầu vào.
Nhờ cơ chế gating, các chuyên gia tự nhiên hình thành các vùng chuyên biệt. Nhiều nghiên cứu phân tích biểu diễn nội bộ của các expert và phát hiện chúng phân hóa theo ngôn ngữ, theo cấu trúc câu hoặc theo chủ đề, gần giống với cách bộ não người phân công các vùng chức năng khác nhau.