RLHF (Reinforcement Learning from Human Feedback) là kỹ thuật huấn luyện mô hình AI theo phản hồi của con người, giúp mô hình bám sát hơn với mong muốn thật của người dùng thay vì chỉ dựa vào dữ liệu thô. Bài viết này giải thích RLHF là gì, ba giai đoạn huấn luyện và vì sao kỹ thuật này thay đổi hoàn toàn cách các mô hình ngôn ngữ lớn được huấn luyện.
RLHF là gì?
Trong học tăng cường (reinforcement learning), một tác nhân học cách hành xử bằng cách tối ưu hàm phần thưởng. Vấn đề là khi áp dụng cho mô hình ngôn ngữ, việc viết ra một hàm phần thưởng bằng tay gần như bất khả thi: thế nào là câu trả lời “tốt”? Thế nào là “hữu ích”, “trung thực”, “an toàn”? Không tồn tại công thức toán học nào diễn tả chính xác những khái niệm này.
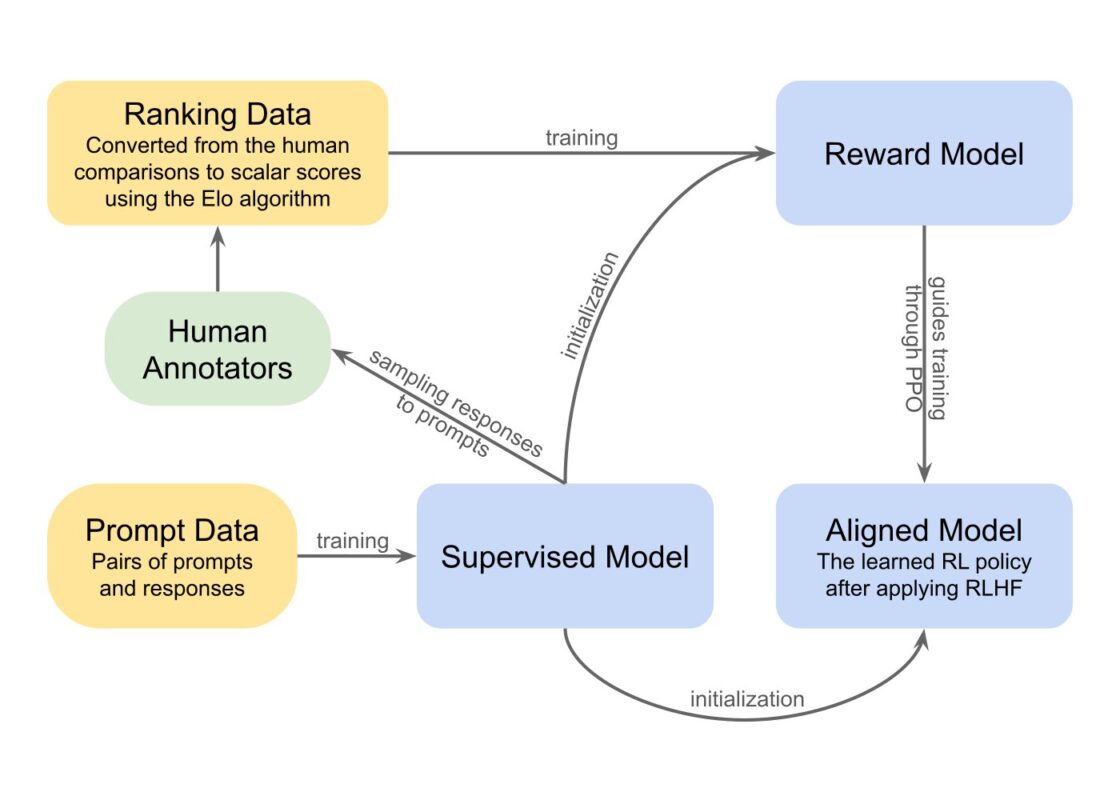
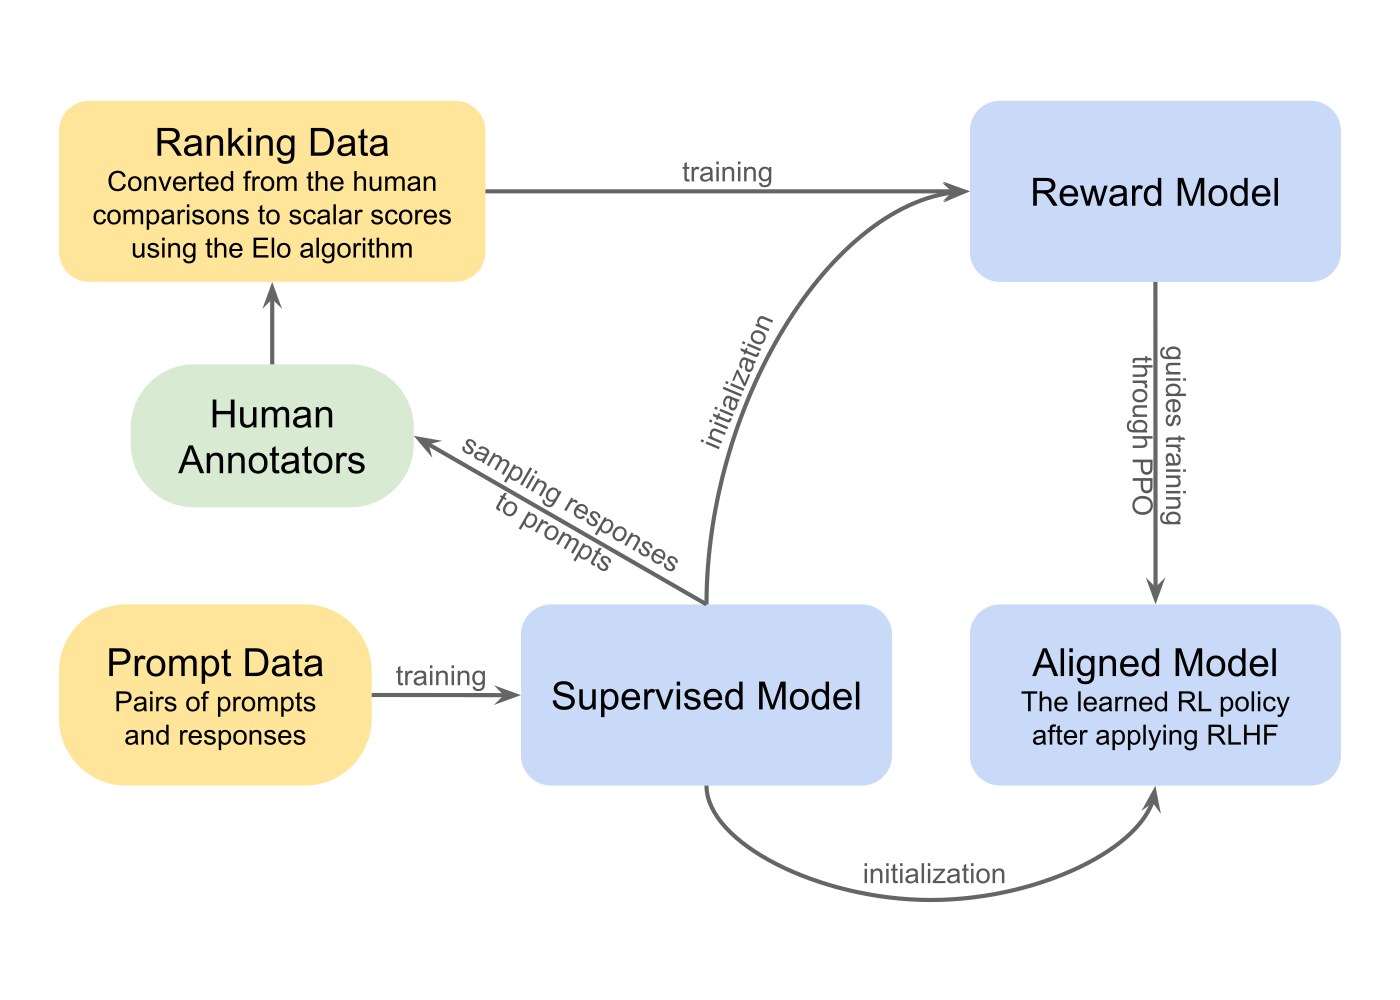
RLHF giải quyết chính xác vấn đề đó bằng cách để con người làm nguồn tín hiệu. Thay vì lập trình phần thưởng, kỹ thuật này huấn luyện một mô hình riêng gọi là reward model để đại diện cho sở thích của con người, rồi dùng mô hình đó làm tín hiệu phần thưởng để tối ưu mô hình ngôn ngữ. Toàn bộ quy trình được mô tả chi tiết trong bài báo Training language models to follow instructions with human feedback của OpenAI, nền tảng của ChatGPT.
Ba giai đoạn của RLHF
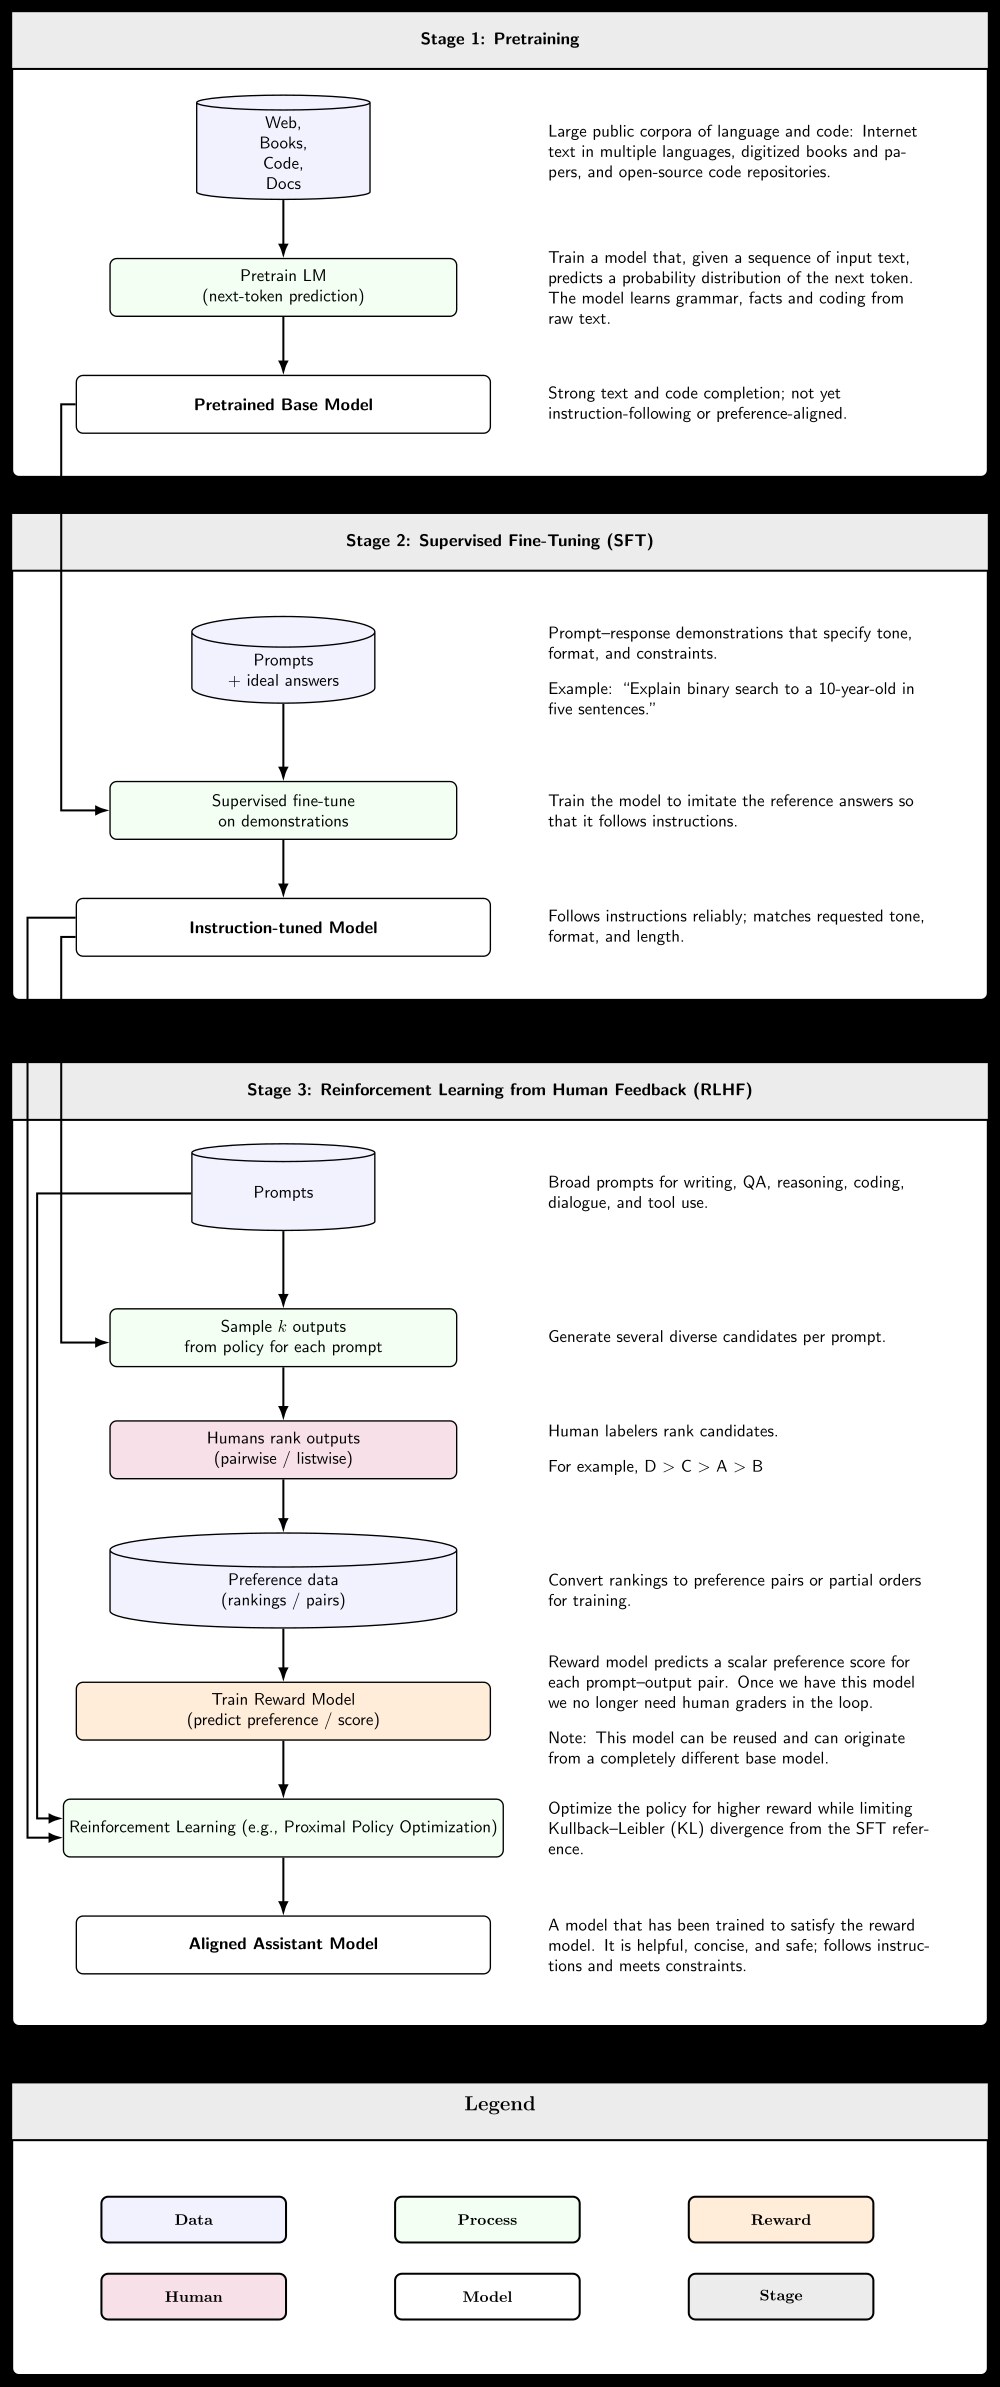
RLHF không phải một bước đơn lẻ mà là chuỗi ba giai đoạn nối tiếp nhau, mỗi giai đoạn lấy kết quả của giai đoạn trước làm đầu vào:
1. Tiền huấn luyện (Pre-training)
Mô hình được huấn luyện trên hàng nghìn tỷ token văn bản thô với mục tiêu dự đoán token tiếp theo. Mô hình ở giai đoạn này chỉ “biết tiếp tục văn bản”, chưa biết trả lời câu hỏi hay tuân theo chỉ dẫn. Dữ liệu thô trên Internet cũng chứa đầy nội dung độc hại, định kiến và thông tin sai lệch.
2. Tinh chỉnh có giám sát (Supervised Fine-tuning, SFT)
Con người viết tay hàng nghìn câu trả lời mẫu cho các câu hỏi cụ thể, và mô hình được huấn luyện bằng học có giám sát trên tập dữ liệu này. Bước này biến mô hình từ “trình tự động nối văn bản” thành “trợ lý đối thoại”. Chất lượng của bước SFT quyết định phần lớn kết quả cuối cùng.
3. Tinh chỉnh bằng RLHF
Đây mới là bước quyết định khác biệt. Mô hình so sánh được nhiều câu trả lời khác nhau cho cùng một câu hỏi, người đánh giá xếp hạng chúng theo thứ tự tốt đến kém, và mô hình học từ chính thứ tự ưu tiên này.
Vì sao lại dùng xếp hạng thay vì chấm điểm trực tiếp?
Đây là chi tiết kỹ thuật tinh vi nhưng cực kỳ quan trọng. Chấm điểm trực tiếp (cho điểm từ 1 đến 10 chẳng hạn) buộc người đánh giá phải cân nhắc đến thang đo tuyệt đối, và con người rất thiên lệch khi so sánh theo kiểu đó. Xếp hạng tương đối buộc người đánh giá chỉ cần so sánh các phương án cạnh nhau — một việc con người làm rất tự nhiên và chính xác hơn nhiều.
Chính vì vậy reward model được huấn luyện trên dữ liệu xếp hạng: đầu vào là các cặp câu trả lời, đầu ra là một giá trị phần thưởng (reward) tương đối. Nhiều mô hình còn dùng kỹ thuật Bradley-Terry hoặc Elo để chuẩn hóa thứ hạng thành điểm số.
| Giai đoạn | Nguồn tín hiệu | Chi phí |
|---|---|---|
| Pre-training | Văn bản Internet | Rất cao, hàng triệu USD |
| SFT | Câu trả lời viết tay | Thấp, hàng nghìn ví dụ |
| Reward model | Xếp hạng của con người | Trung bình, hàng chục nghìn cặp |
| PPO | Reward model | Cao, chạy song song nhiều phiên bản |
Tối ưu chính sách PPO và vấn đề lệch khỏi mô hình gốc
Sau khi có reward model, bước cuối cùng dùng thuật toán tối ưu chính sách gần tiếp cận — thường là PPO (Proximal Policy Optimization) — để tối ưu mô hình ngôn ngữ theo phần thưởng. PPO được chọn vì nó giới hạn bước cập nhật chính sách, tránh việc mô hình “lao” ra khỏi phân bố dữ liệu gốc và hỏng hoàn toàn.
Vấn đề lớn nhất của RLHF là reward hacking: mô hình tìm cách tối đa hóa điểm phần thưởng mà không thực sự trở nên hữu ích hơn. Nó có thể học cách viết dài dòng, tự khen mình, hoặc trả lời theo một mẫu cụ thể nào đó mà người đánh giá ưa chuộng mà không liên quan đến sự thật.
Một số hướng cải thiện đáng chú ý:
- Thêm hạn chế KL giữa mô hình mới và mô hình gốc để kéo mô hình không đi quá xa.
- Reward model ensemble — dùng nhiều reward model để giảm thiên lệch của một mô hình đơn lẻ.
- PPO với clipping giới hạn bước cập nhật, tránh mô hình thoát khỏi vùng an toàn.
- DPO (Direct Preference Optimization) — bỏ hoàn toàn bước huấn luyện reward model, tối ưu trực tiếp trên dữ liệu xếp hạng. Cách này đơn giản và ổn định hơn, được trình bày trong bài Direct Preference Optimization: Your Language Model is Secretly a Reward Model.
RLHF vượt xa lĩnh vực văn bản
RLHF không chỉ dành cho chatbot. Kỹ thuật này được ứng dụng rộng rãi ở nhiều nơi:
- Computer vision — DALL-E và Stable Diffusion đều dùng phản hồi con người để tinh chỉnh chất lượng hình ảnh.
- Robot — bot trong game và robot vật lý học cách thực hiện nhiệm vụ qua phần thưởng do người đánh giá.
- Tóm tắt văn bản — một trong những ứng dụng sớm nhất, từ bài báo năm 2020 của Google về tóm tắt tài liệu.
- Lập trình — nhiều mô hình viết code được huấn luyện bằng cách so sánh đầu ra với test case kết hợp phản hồi của lập trình viên.
Giới hạn và tranh luận xung quanh RLHF
Không có kỹ thuật nào miễn phí. RLHF đặt ra một số vấn đề nghiêm trọng cần cân nhắc:
- Chi phí con người — thu thập xếp hạng chất lượng cao tốn nhiều công sức, và thường bị lệch về thiểu số có quan điểm giống nhau.
- Bắc cục giá trị — mô hình học “giá trị của người đánh giá”, không phải “giá trị đúng” của con người nói chung.
- Goodhart’s Law — khi một chỉ số trở thành mục tiêu, nó ngừng còn là chỉ số tốt. Đây chính là bản chất của reward hacking.
- Bias trong dữ liệu — mọi thiên lệch của người đánh giá đều được mô hình hấp thụ và khuếch đại.
- Chi phí thuật toán — PPO cần chạy bốn mô hình song song (policy, reference, reward, critic) khiến triển khai tốn kém.
Kết luận
RLHF đánh dấu bước chuyển quan trọng: trí tuệ nhân tạo chuyển từ “học thuộc dữ liệu” sang “học cách cư xử theo mong muốn con người”. Chính bước SFT kết hợp với RLHF đã đưa ChatGPT lên thành công nghiệp và tạo nên làn sóng mô hình ngôn ngữ thế hệ sau.
Điểm mấu chốt để nhớ: RLHF không tự tạo ra tri thức hay suy luận mới cho mô hình. Nó định hình hành vi của mô hình theo sở thích con người. Chính vì vậy, chất lượng dữ liệu phản hồi quyết định chất lượng đầu ra — vấn đề của RLHF thực chất là vấn đề của dữ liệu.
Bạn muốn tìm hiểu sâu hơn về nào: DPO hay nén mô hình sau khi đã huấn luyện? Cả hai đều là những bước tối ưu quan trọng trong pipeline xây dựng mô hình ngôn ngữ.