NPU là gì và vì sao con số TOPS trên hộp điện thoại ngày càng phóng đại. Neural Processing Unit là bộ xử lý chuyên dụng cho mô hình AI, tách khỏi CPU và GPU, được tối ưu riêng cho phép nhân ma trận số nguyên ở độ chính xác thấp. Nhờ đó máy chạy được tính năng AI ngay trên thiết bị mà không cần gửi dữ liệu lên máy chủ. Bài viết này so sánh NPU với GPU và CPU, giải thích vì sao số TOPS không so sánh được giữa các hãng, và điểm danh các NPU thật đang chạy trong thiết bị bạn dùng hằng ngày.
NPU khác gì GPU và CPU
Ba loại vi xử lý này cùng chạy được mô hình AI, nhưng được thiết kế với ưu tiên khác nhau.
| Tiêu chí | CPU | GPU | NPU |
|---|---|---|---|
| Thiết kế cho | Luồng điều khiển phức tạp, nhánh rẽ linh hoạt | Song song rộng, throughput cao | Ma trận INT8/FP16 liên tục |
| Hiệu suất trên mô hình AI | Thấp, dễ tắc nghẽn | Khá cao khi huấn luyện | Cao nhất mỗi watt cho inference |
| Mức tiêu thụ điện | Thấp khi rảnh rác | Cao khi chạy liên tục | Thấp nhất trong ba loại |
| Độ linh hoạt với mô hình | Chạy mọi thứ | Chạy gần như mọi thứ | Hạn chế, phải biên dịch và lượng tử |
| Phù hợp nhất | Hệ điều hành, logic | Huấn luyện, xử lý hàng loạt | Suy luận tại chỗ, liên tục |
Nói ngắn gọn: CPU giỏi quyết định, GPU giỏi làm nhiều phép toán cùng lúc với độ chính xác cao, NPU giỏi làm phép toán ma trận số nguyên liên tục với mức tiêu thụ điện thấp.
Điểm đánh đổi của NPU là sự linh hoạt. Mô hình phải được biên dịch cho phần cứng đó và thường phải lượng tử về định dạng số thấp, nên tập hợp toán tử được hỗ trợ hẹp hơn nhiều so với GPU. Bù lại, bạn có được hiệu suất trên mỗi watt mà không đổi lấy bằng pin chai.
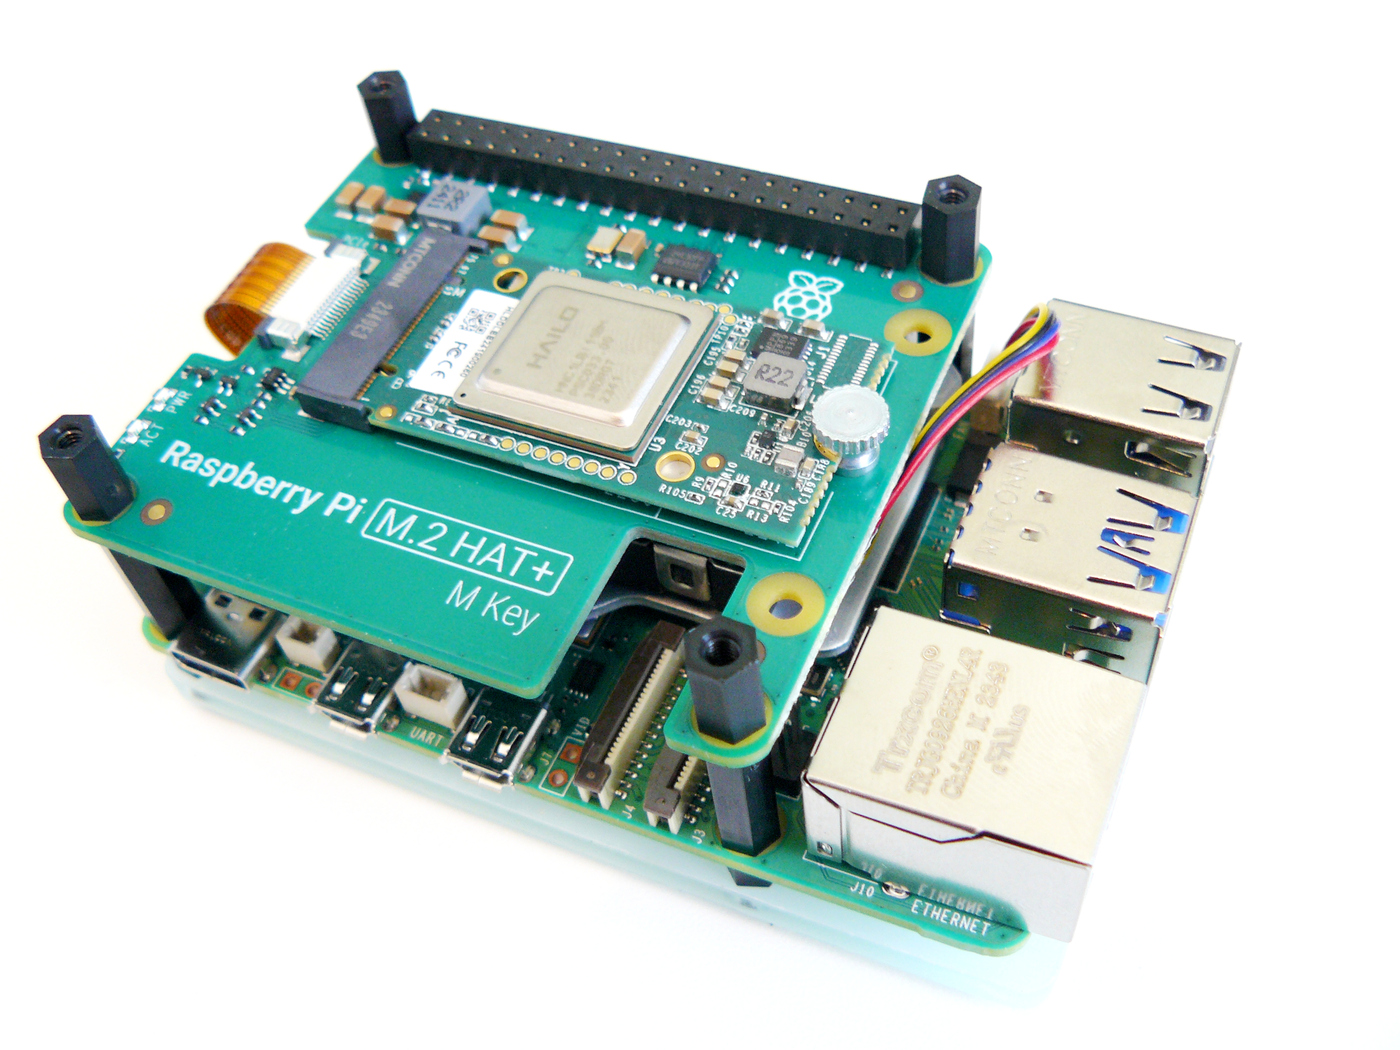
TOPS là gì và vì sao không so sánh được
TOPS là Tera Operations Per Second, tức 1012 phép toán mỗi giây. Nghe giống một thước đo khách quan, nhưng thực tế nó gần như vô nghĩa khi so sánh giữa các hãng.
Vấn đề nằm ở ba chỗ:
- Định dạng số khác nhau. Hãng A công bố TOPS tính trên INT8, hãng B tính trên FP16. Một phép nhân FP16 tốn gấp đôi bộ nhớ và gấp đôi băng thông so với INT8.
- Quy ước đếm khác nhau. Có hãng tính mỗi phép MAC là 2 phép toán (nhân và cộng), hãng khác tính là 1. Chênh lệch ngay hệ số 2.
- Bối cảnh đo khác nhau. TOPS lý thuyết ở tần số boost không phản ánh hiệu năng thật khi bộ nhớ không kịp cấp dữ liệu.
Vì vậy, đừng so sánh TOPS giữa hai hãng khác nhau, và cũng đừng so sánh TOPS của một chiếc điện thoại với TOPS trên một card đồ hoạ rời. Hãng sản xuất cần ghi rõ định dạng số và quy ước đếm. Hướng dẫn chi tiết về vấn đề này có tại bài viết của Qualcomm về TOPS và NPU.
Vì sao suy luận tại chỗ lại quan trọng
Chạy AI trên máy thay vì gọi lên cloud mang bốn lợi ích cụ thể:
- Riêng tư. Dữ liệu không rời khỏi thiết bị, không nằm trên máy chủ của bên thứ ba.
- Độ trễ. Không có vòng đi qua mạng, phản hồi tính bằng mili giây.
- Chạy offline. Không cần mạng vẫn dùng được, rất quan trọng ở nơi sóng yếu.
- Tiết kiệm chi phí. Không tốn hạ tầng GPU cho hàng triệu request suy luận mỗi ngày.
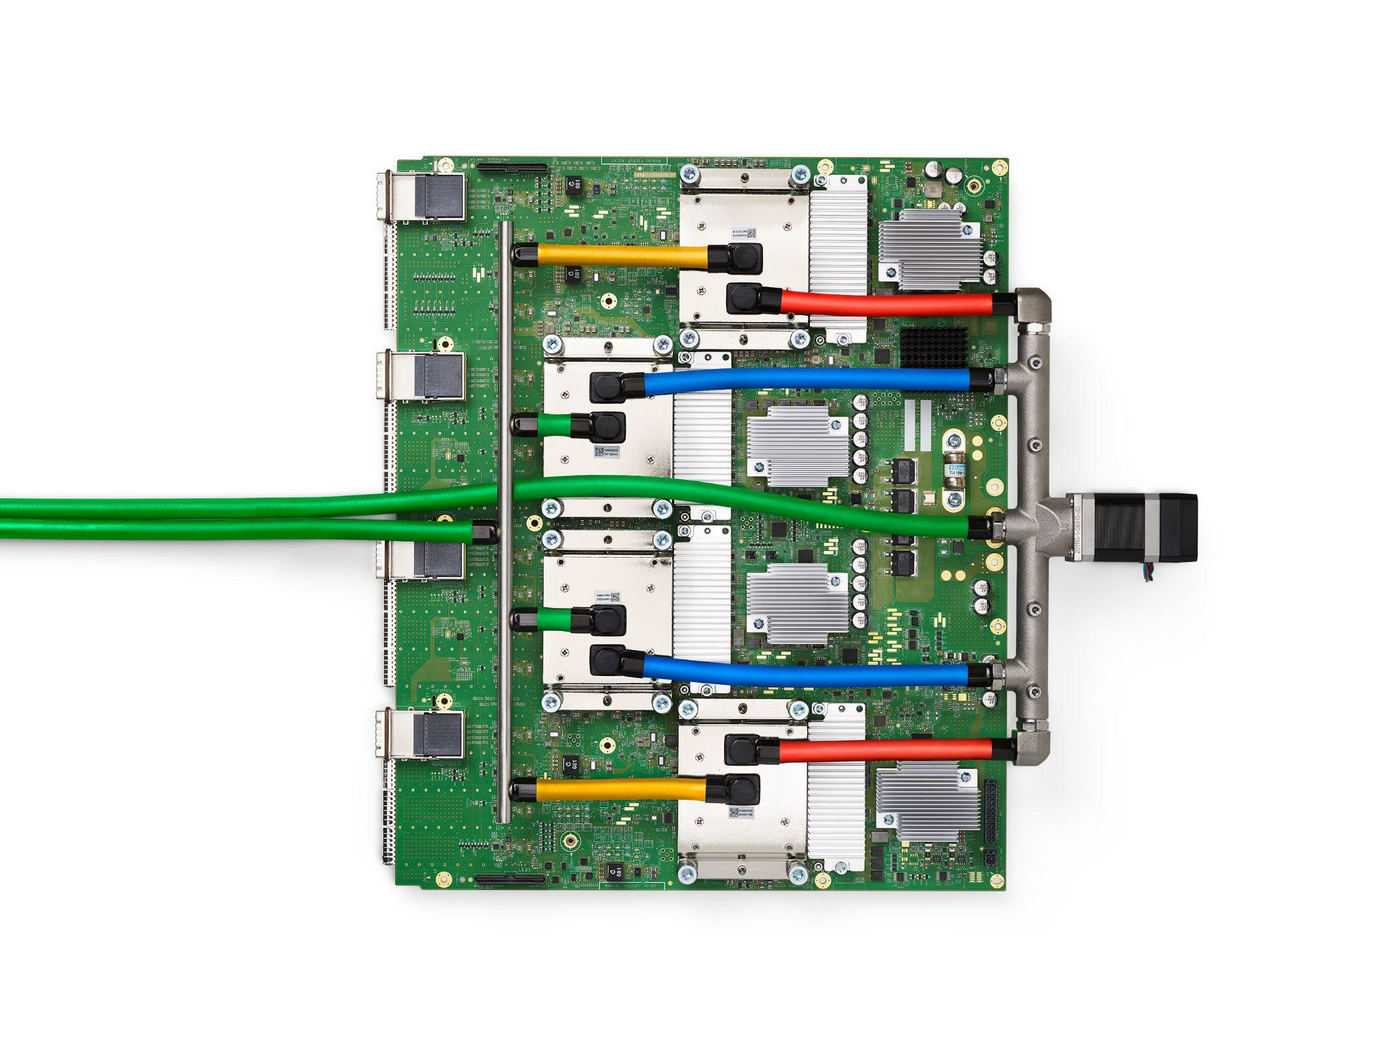
Bổ sung vào đó là hiệu quả năng lượng. Một ví dụ rất cụ thể từ tài liệu Coral Edge TPU: một Edge TPU đạt 4 TOPS với mức tiêu thụ 2 TOPS mỗi watt. Với mô hình MobileNet v2 kích thước 224×224, thời gian suy luận giảm từ 51 mili giây trên CPU desktop xuống 2,6 mili giây khi chạy trên USB Accelerator cùng TPU, tức nhanh khoảng 20 lần. Với ResNet-50 kích thước 299×299, thời gian giảm từ 484 mili giây xuống 49 mili giây. Bảng số đo chi tiết nằm tại trang benchmark của Coral.
NPU thật trong thiết bị bạn dùng
Apple Neural Engine
Apple đưa Neural Engine vào chip A11 Bionic năm 2017 với iPhone X. Dòng chip M tiếp tục tăng mạnh: Neural Engine trên M3 đạt 18 TOPS, còn trên M4 đạt 38 TOPS với 16 lõi, cao hơn A11 hơn 60 lần và khoảng 3 lần so với M1. Việc triển khai trên iOS và macOS thông qua framework Core ML. Chi tiết tại trang Neural Engine và trang Apple M4.
Google TPU và Coral Edge TPU
TPU của Google bắt nguồn từ bài báo lâm lý học nổi tiếng năm 2017 và dùng kiến trúc systolic, tức dữ liệu chảy qua một mảng bộ cộng cùng nhịp với bộ nhớ. Ngoài trung tâm dữ liệu, Google còn có dòng Coral Edge TPU thiết kế cho thiết bị biên. Bối cảnh lịch sử tại trang Tensor Processing Unit.
Intel Meteor Lake và Qualcomm Hexagon
Trên Intel Meteor Lake, khối NPU (tên Intel AI Boost, trước đó là VPU) xử lý một phép FP16 hoặc hai phép INT8 mỗi chu kỳ. NPU đóng góp khoảng 11 TOPS, còn tổng năng lực của cả nền tảng là 34 TOPS, phân bổ 5 TOPS cho CPU và 18 TOPS cho iGPU. Kiến trúc bên trong NPU dùng hai vi mạch LEON 32 bit: một bộ xử lý lệnh host và một bộ lập lịch. Chi tiết tại trang Meteor Lake.
Ở phía Android, dòng Qualcomm Hexagon đóng vai trò DSP/NPU, dùng kiến trúc VLIW bốn chiều, xuất hiện trong Snapdragon trên điện thoại, xe và thiết bị đeo. SDK để chạy mô hình trên đây là Qualcomm AI Engine Direct, viết tắt QNN. Tham khảo tại trang Qualcomm Hexagon.
TOPS như một yêu cầu phần cứng
Microsoft đã biến ngưỡng TOPS thành tiêu chí phần cứng bắt buộc cho dòng Copilot+ PC: máy phải có NPU đạt tối thiểu 40 TOPS, kèm ít nhất 16 GB RAM và 256 GB dung lượng lưu trữ. Đợt máy đầu tiên dùng Snapdragon X Elite, sau đó mở rộng sang AMD Ryzen AI và Intel Core Ultra.
Điều này cho thấy TOPS ngày càng trở thành thông số marketing quen thuộc, dù công bằng mà nói, nó là con số dễ so sánh nhất hiện nay. Hãy đọc nó cùng định dạng số và điều kiện đo.
Bộ nhớ thống nhất: lý do NPU trên máy tính nhanh hơn
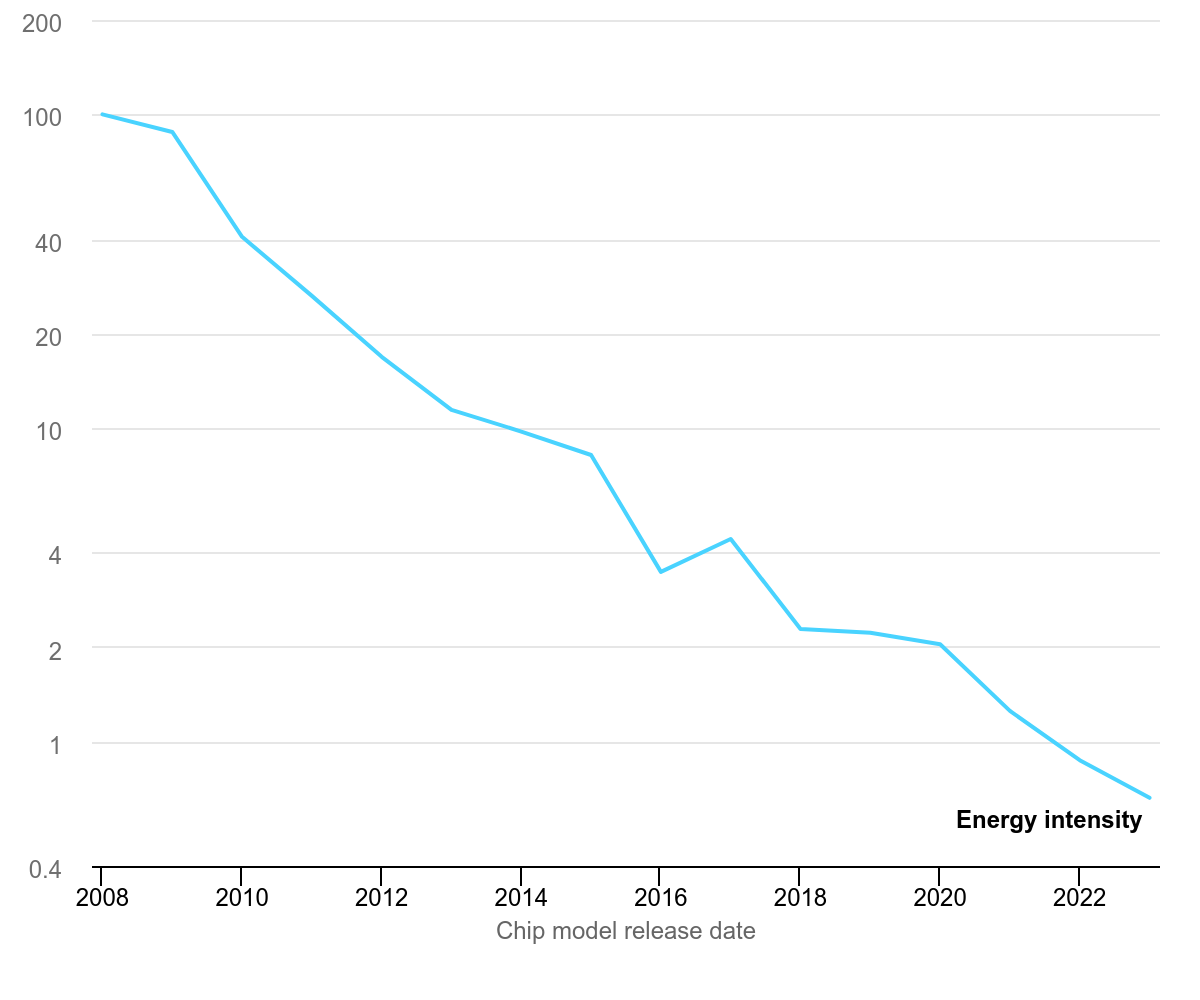
Trên Apple silicon, CPU, GPU và Neural Engine dùng chung một vùng bộ nhớ thống nhất. Tác nhân lớn làm chậm suy luận AI thường không phải phép toán, mà là thời gian sao chép tensor qua lại giữa CPU và bộ tăng tốc. Khi cả hai cùng đọc một vùng RAM, phép sao chép đó biến mất.
Khái niệm này được trình bày tại trang unified memory. Đây cũng là lý do hầu hết ví dụ về tăng tốc suy luận cục bộ đạt được trên máy tính dùng chip hợp nhất, chứ không phải máy có card rời rẻ tiền.
NPU không phải lúc nào cũng thắng
Có những trường hợp GPU vẫn đúng lựa chọn:
- Huấn luyện mô hình lớn: cần băng thông và hệ sinh thái thư viện mà NPU chưa theo kịp.
- Mô hình có toán tử lạ: bộ biên dịch NPU thường không hỗ trợ, buộc phải rơi về CPU.
- Tương tác với người dùng nặng như trò chơi hay dựng video, nơi GPU tỏ ra linh hoạt hơn hẳn.
- Chuỗi thao tác phức tạp xen kẽ với logic điều khiển, nơi CPU xử lý tốt hơn nhiều.
Có một ví dụ sử dụng NPU đáng chú ý trong game: công nghệ nâng cấp hình ảnh bằng AI như DLSS của NVIDIA kết hợp GPU render khung hình nền ở độ phân giải thấp với bộ nâng cấp AI, đưa đầu ra lên độ phân giải cao hơn nhiều ở tần số khung hình cao. Bước nâng cấp chính là một mô hình AI chạy trên phần cứng chuyên dụng.
Chạy mô hình trên NPU cần những gì
Không phải mô hình ONNX nào cũng chạy được trên mọi NPU. Bạn cần một runtime biết cách biên dịch cho phần cứng đích, ví dụ:
- ONNX Runtime với execution provider tương ứng: DirectML, OpenVINO, QNN, CoreML. Nền tảng tại onnxruntime.ai.
- Core ML cho Apple Neural Engine trên iOS và macOS.
- TensorFlow Lite phổ biến trên Android.
- Qualcomm AI Engine Direct cho dòng Hexagon.
Chưa có một API thống nhất cho NPU, nên thực tế phải chọn runtime theo từng nhóm phần cứng, và việc biên dịch cùng lượng tử mô hình là bước bắt buộc trong quy trình phát triển.
Kết luận
NPU là câu trả lời phần cứng cho bài toán suy luận AI thường xuyên với mức tiêu thụ điện thấp. Nó thắng GPU ở hiệu suất mỗi watt và ở tính riêng tư, thua ở sự linh hoạt với mô hình lạ và ở việc huấn luyện.
Khi đọc thông số NPU, hãy tìm ba thứ: định dạng số dùng để tính TOPS, quy ước đếm phép toán, và điều kiện đo có thực tế hay không. Ba thông tin đó quyết định con số đó có nghĩa gì.