Zstandard (thường gọi tắt là zstd) là thuật toán nén dữ liệu do Yann Collet phát triển tại Facebook và phát hành mã nguồn mở năm 2016. Điểm mạnh của nó là nén nhanh gấp nhiều lần zlib ở cùng tỷ lệ nén, giải nén trên một lõi đạt tốc độ hàng gigabyte mỗi giây, và đã được chuẩn hoá thành RFC 8878 nên bất kỳ ai cũng có thể viết bộ giải nén tương thích.
Bài viết này phân tích cấu trúc khung dữ liệu của Zstandard, cách nó mã hoá entropy bằng Huffman và FSE, vai trò của bảng từ điển, các mức nén từ âm đến 22, cùng nơi zstd đã được đưa vào sử dụng thực tế.
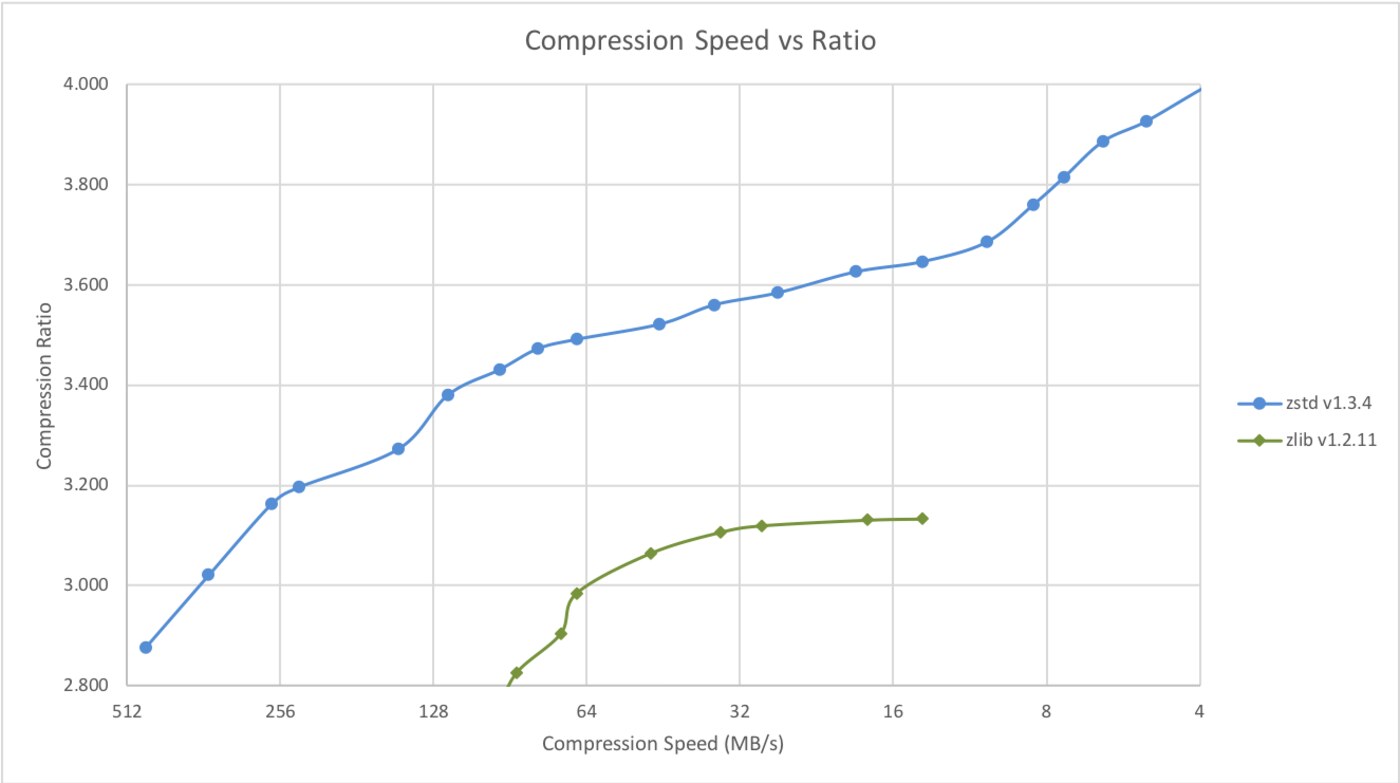
Đường cong tốc độ nén theo tỷ lệ nén cho thấy bước nhảy chất lượng mà zstd đạt được. Trong hầu hết các chế độ, zstd nằm bên phải và phía trên zlib, nghĩa là với cùng một tốc độ nén thì zstd ép được dữ liệu nhỏ hơn, và với cùng một tỷ lệ nén thì zstd chạy nhanh hơn nhiều lần. Chỉ ở vùng tỷ lệ nén rất cao bên trên góc phải, zlib mới bắt kịp được zstd về kích thước đầu ra.
Chất lượng đó đến từ cách Zstandard chia dữ liệu thành các khối tuần tự độc lập. Mỗi khối được nén riêng thành một block nén, nên chỉ cần giải nén đúng block đang cần là xong mà không phải giải nén toàn bộ tệp.
Cấu trúc khung dữ liệu của Zstandard
Theo đặc tả RFC 8878, một luồng nén của zstd là chuỗi các khung (frame) độc lập, mỗi khung bắt đầu bằng số ma 4 byte ở dạng little-endian, giá trị 0xFD2FB528, nên khi ghi ra đĩa byte đầu tiên đọc dưới dạng 28 B5 2F FD. Số ma này cho phép bộ giải nén nhận ra định dạng ngay lập tức và bỏ qua âm thanh bảo mật khi người dùng không muốn giải nén.
Sau số ma là một header mô tả các thuộc tính của khung, trong đó có cờ có dùng bảng từ điển hay không, có kiểm tra tổng hay không, và kích thước cửa sổ (window size). Kích thước cửa sổ tối thiểu là 1 KB và tối đa lên tới vài terabyte; cửa sổ lớn hơn thường cho tỷ lệ nén tốt hơn nhưng đòi hỏi nhiều bộ nhớ hơn khi giải nén.
Khung được chia thành các block, và mỗi block có 3 byte header chứa ba trường: cờ cho biết đây có phải block cuối cùng không, trường loại block chiếm 2 bit, và kích thước block. Có bốn loại block, trong đó loại 3 dành riêng và bộ giải nén phải từ chối nếu gặp:
| Loại block | Giá trị | Cách hoạt động |
|---|---|---|
| Raw block | 0 | Dữ liệu được giữ nguyên, chỉ dùng cho phần dữ liệu không nén được |
| RLE block | 1 | Một byte lặp lại Block_Size lần, cực hữu ích với dữ liệu chạy dài |
| Compressed block | 2 | Khối đã nén thật, chứa literals và chuỗi so khớp |
| Reserved | 3 | Dành riêng, bộ giải nén bắt buộc từ chối |
Điểm thiết kế đáng chú ý là các khung độc lập giải mã và có thể nối tiếp: bộ giải nén không cần khung trước đó để đọc khung sau. Nhờ vậy một tệp nén bị hỏng ở giữa vẫn giải được phần đầu. Zstandard còn định nghĩa khung bỏ qua với dải số ma 0x184D2A50 đến 0x184D2A5F, cho phép nhúng siêu dữ liệu tuần tự trong khi không ảnh hưởng tới bộ giải nén.
Thuật toán nén bên trong: LZ và mã hoá entropy
Zstandard là thuật toán kiểu LZ, tức nó săn các đoạn lặp lại trong dữ liệu và chỉ ghi lại tham chiếu thay vì ghi lại toàn bộ nội dung. Nét khác biệt so với zlib nằm ở đâu nó dành công sức: thay vì chỉ tìm so khớp theo một chiến lược duy nhất, zstd tách dữ liệu thành hai phần là các ký tự nguyên văn (literals) và chuỗi so khớp (sequences) chứa độ dài khớp cùng khoảng cách tới vị trí khớp trước đó.
Để nén hai phần này, zstd dùng hai họ phương pháp mã hoá entropy khác nhau. Huffman, vốn quen thuộc, dùng cho literals. Còn chuỗi so khớp thì dùng FSE (Finite State Entropy), kỹ thuật dựa trên hệ số đếm từ hệ đối xứng. FSE giữ trạng thái qua từng ký hiệu và có bảng tra cỡ lũy thừa hai, với độ chính xác suy ra từ tham số Accuracy_Log; mỗi phần tử bảng lưu ký hiệu, số bit cần dùng và một giá trị nền. Nhờ không cần truyền cây Huffman cho bảng FSE, tổng chi phí phần overhead giảm đáng kể so với deflate.
Khối literals cũng chia thành bốn kiểu: Raw, RLE, Compressed với cây Huffman nhúng bên trong, và Treeless, kiểu tái sử dụng cây Huffman đã dùng ở khối trước hoặc từ bảng từ điển. Đây chính là kỹ thuật mà gói thư viện zstd manual mô tả chi tiết, cùng với ba khoảng cách lặp được giữ theo thứ tự động thay đổi, ban đầu là 1, 4 và 8 nếu bảng từ điển không cung cấp giá trị khác.
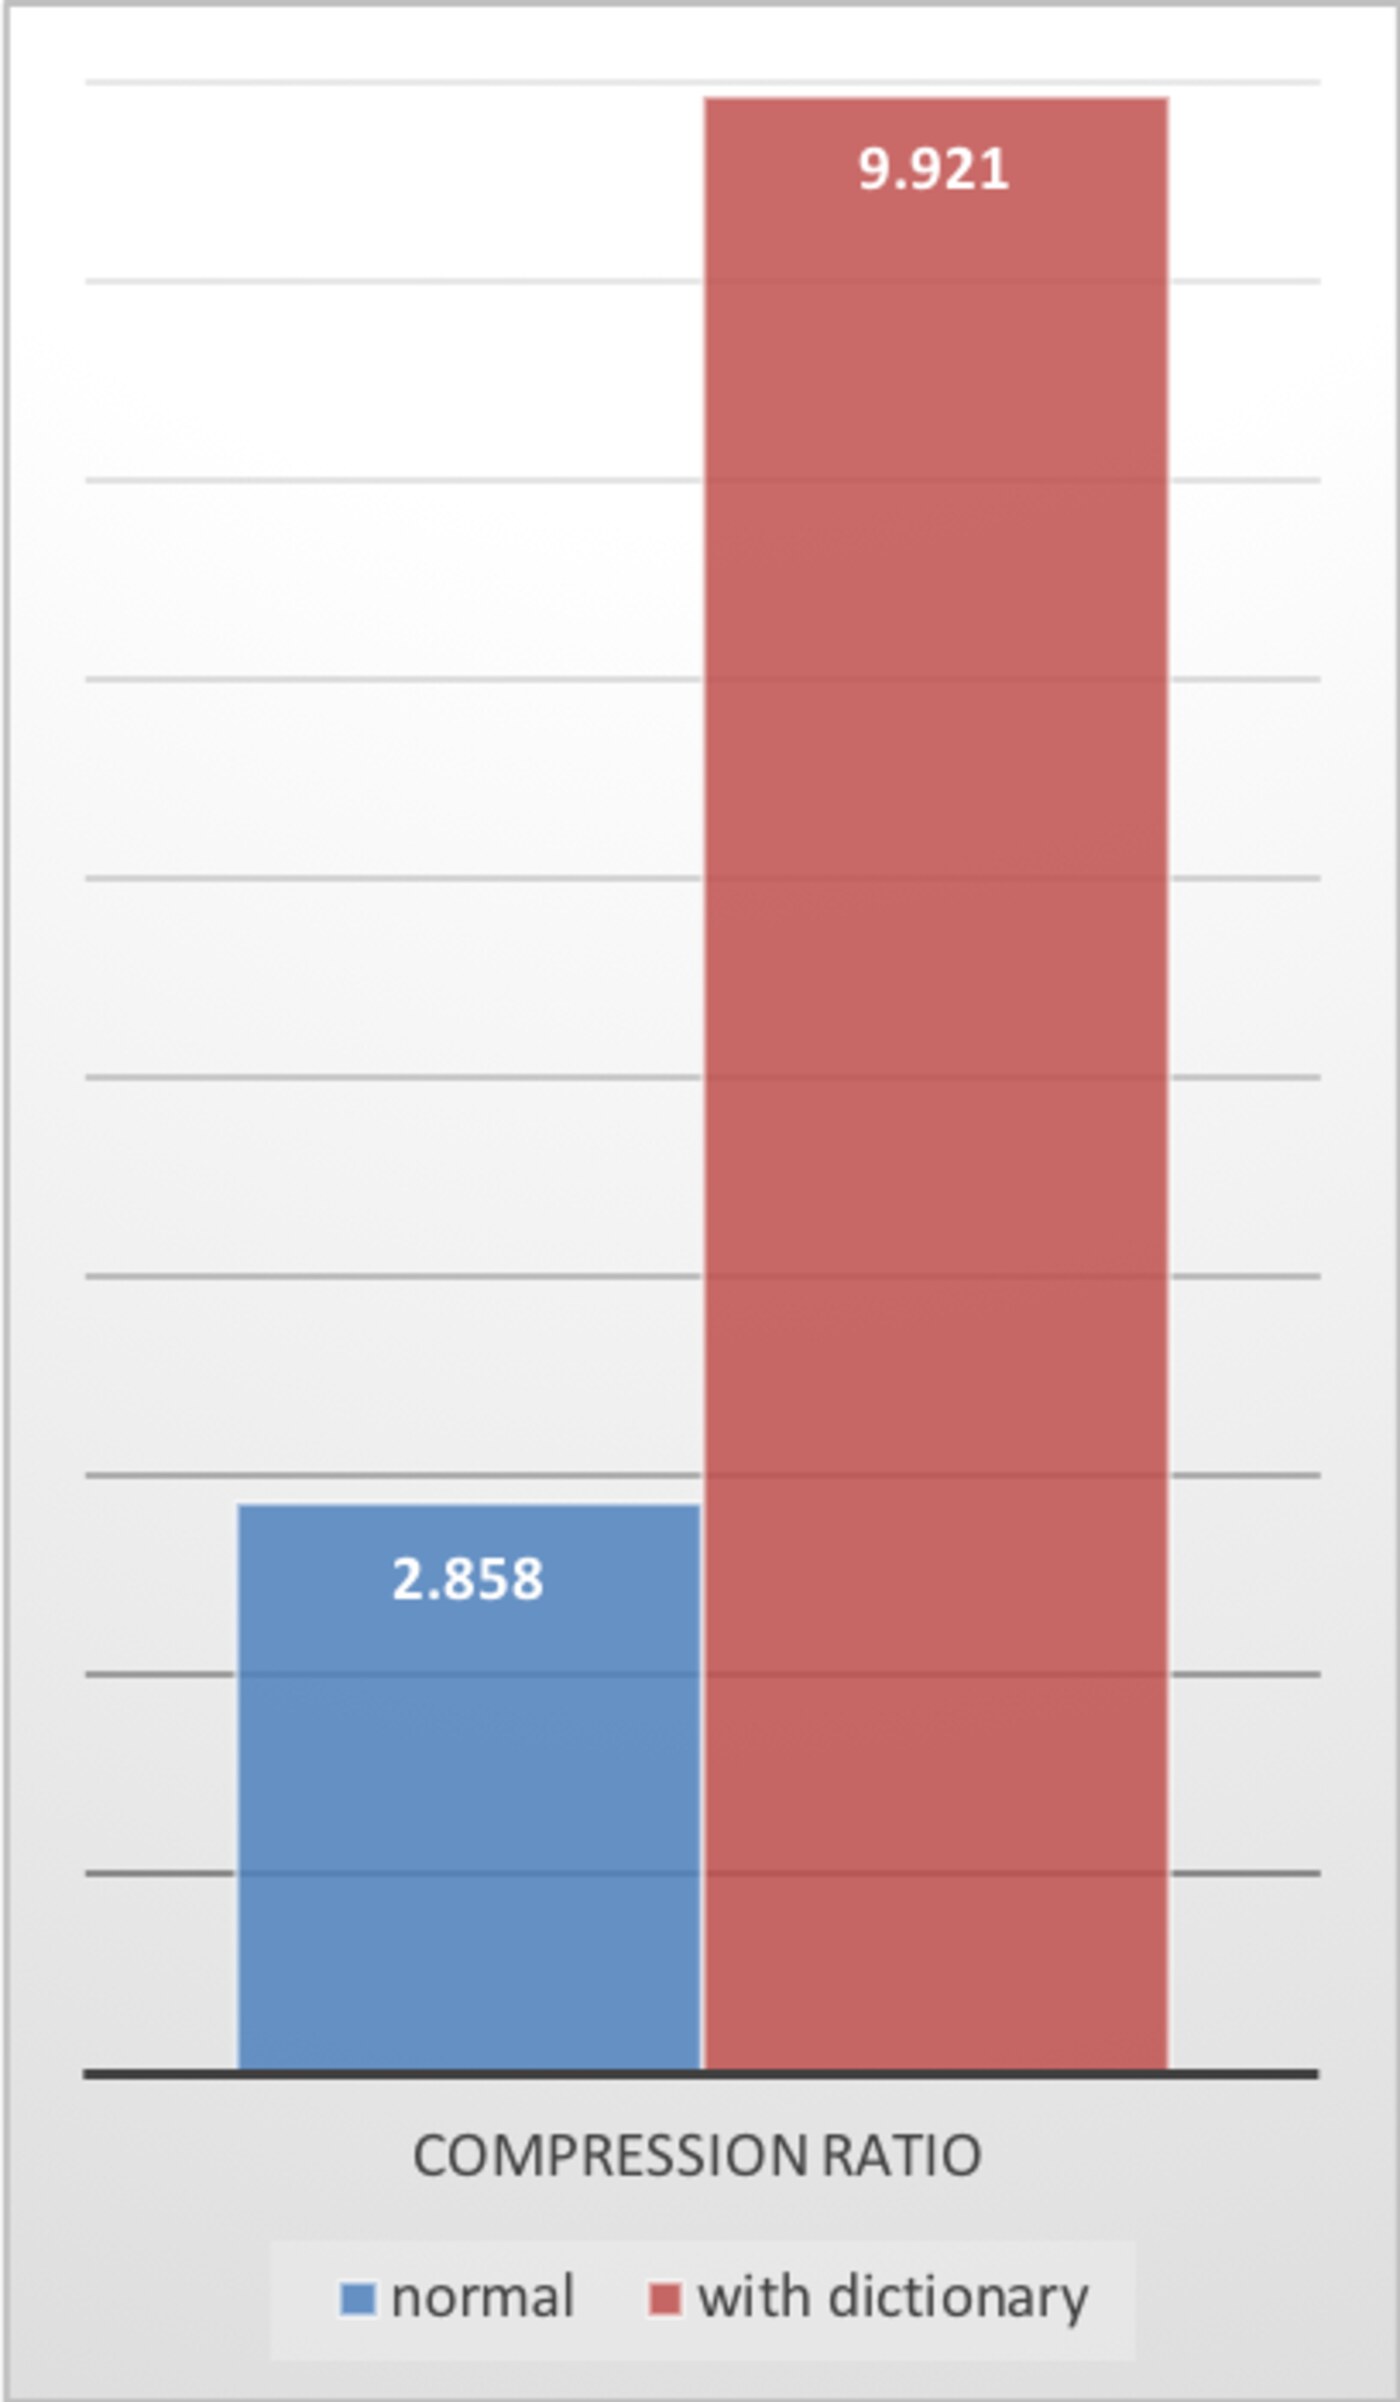
Hiệu quả của bảng từ điển thể hiện rõ nhất trên dữ liệu nhỏ. Với file vài kilobyte, lịch sử giải nén chưa kịp học được mẫu nào, nên bảng từ điển huấn luyện trên chính loại dữ liệu đó cho tỷ lệ nén vượt trội so với nén thông thường.
Bảng từ điển: nén theo bối cảnh
Giải pháp từ điển giải quyết một hạn chế cố hữu của mọi thuật toán LZ: ở đầu luồng dữ liệu, chưa có lịch sử nào để so khớp. Khung zstd có thể mang theo một mã định danh bảng từ điển dài 1, 2 hoặc 4 byte, và bảng từ điển thật thì được truyền riêng ngoài luồng nén.
Bảng từ điển có cấu trúc riêng, mở đầu bằng số ma 0xEC30A437 rồi đến mã định danh 4 byte, sau đó là các bảng entropy: Huffman cho literals, FSE cho khoảng cách, FSE cho độ dài khớp, FSE cho độ dài literals, và cuối cùng là ba khoảng cách lặp. Công cụ dòng lệnh zstd tạo bảng từ điển bằng tuỳ chọn --train, theo tài liệu trong kho mã nguồn chính thức.
Điểm cần nhấn mạnh là lợi ích tập trung vào vài kilobyt đầu tiên của luồng; sau đó lịch sử giải nén tự đóng vai trò và hiệu quả bảng từ điển giảm dần. Đó là lý do RFC 8878 khuyến nghị không dùng bảng từ điển trong nội dung công khai qua HTTP nếu hai bên không thỏa thuận riêng về bảng đó.
Các mức nén và tuỳ chọn thực dụng
zstd hỗ trợ mức nén từ 1 đến 22, mặc định là 3. Mức cao hơn cho tỷ lệ nén tốt hơn nhưng chậm hơn và tốn nhiều bộ nhớ hơn; từ mức 20 trở đi cần bật tuỳ chọn --ultra. Chiều ngược lại, zstd còn cho phép mức nén âm, trao đổi tỷ lệ nén lấy tốc độ, phù hợp khi băng thông là điểm nghẽn chứ không phải CPU.
Ngoài ra còn có các tuỳ chọn đáng chú ý: --fast[=#] nén nhanh nhất, --long[=#] bật cơ chế so khớp khoảng cách xa cho các tệp lớn có mẫu lặp ở xa nhau, và -T0 để tự động dùng nhiều luồng. Theo bảng benchmark trong README dự án, trên bộ dữ liệu Silesia với lõi i7-9700K, zstd ở mức âm 1 đạt tỷ lệ nén 2,896 với tốc độ nén 510 MB/s và giải nén 1550 MB/s, nhanh hơn hẳn zlib ở cùng tỷ lệ nén.
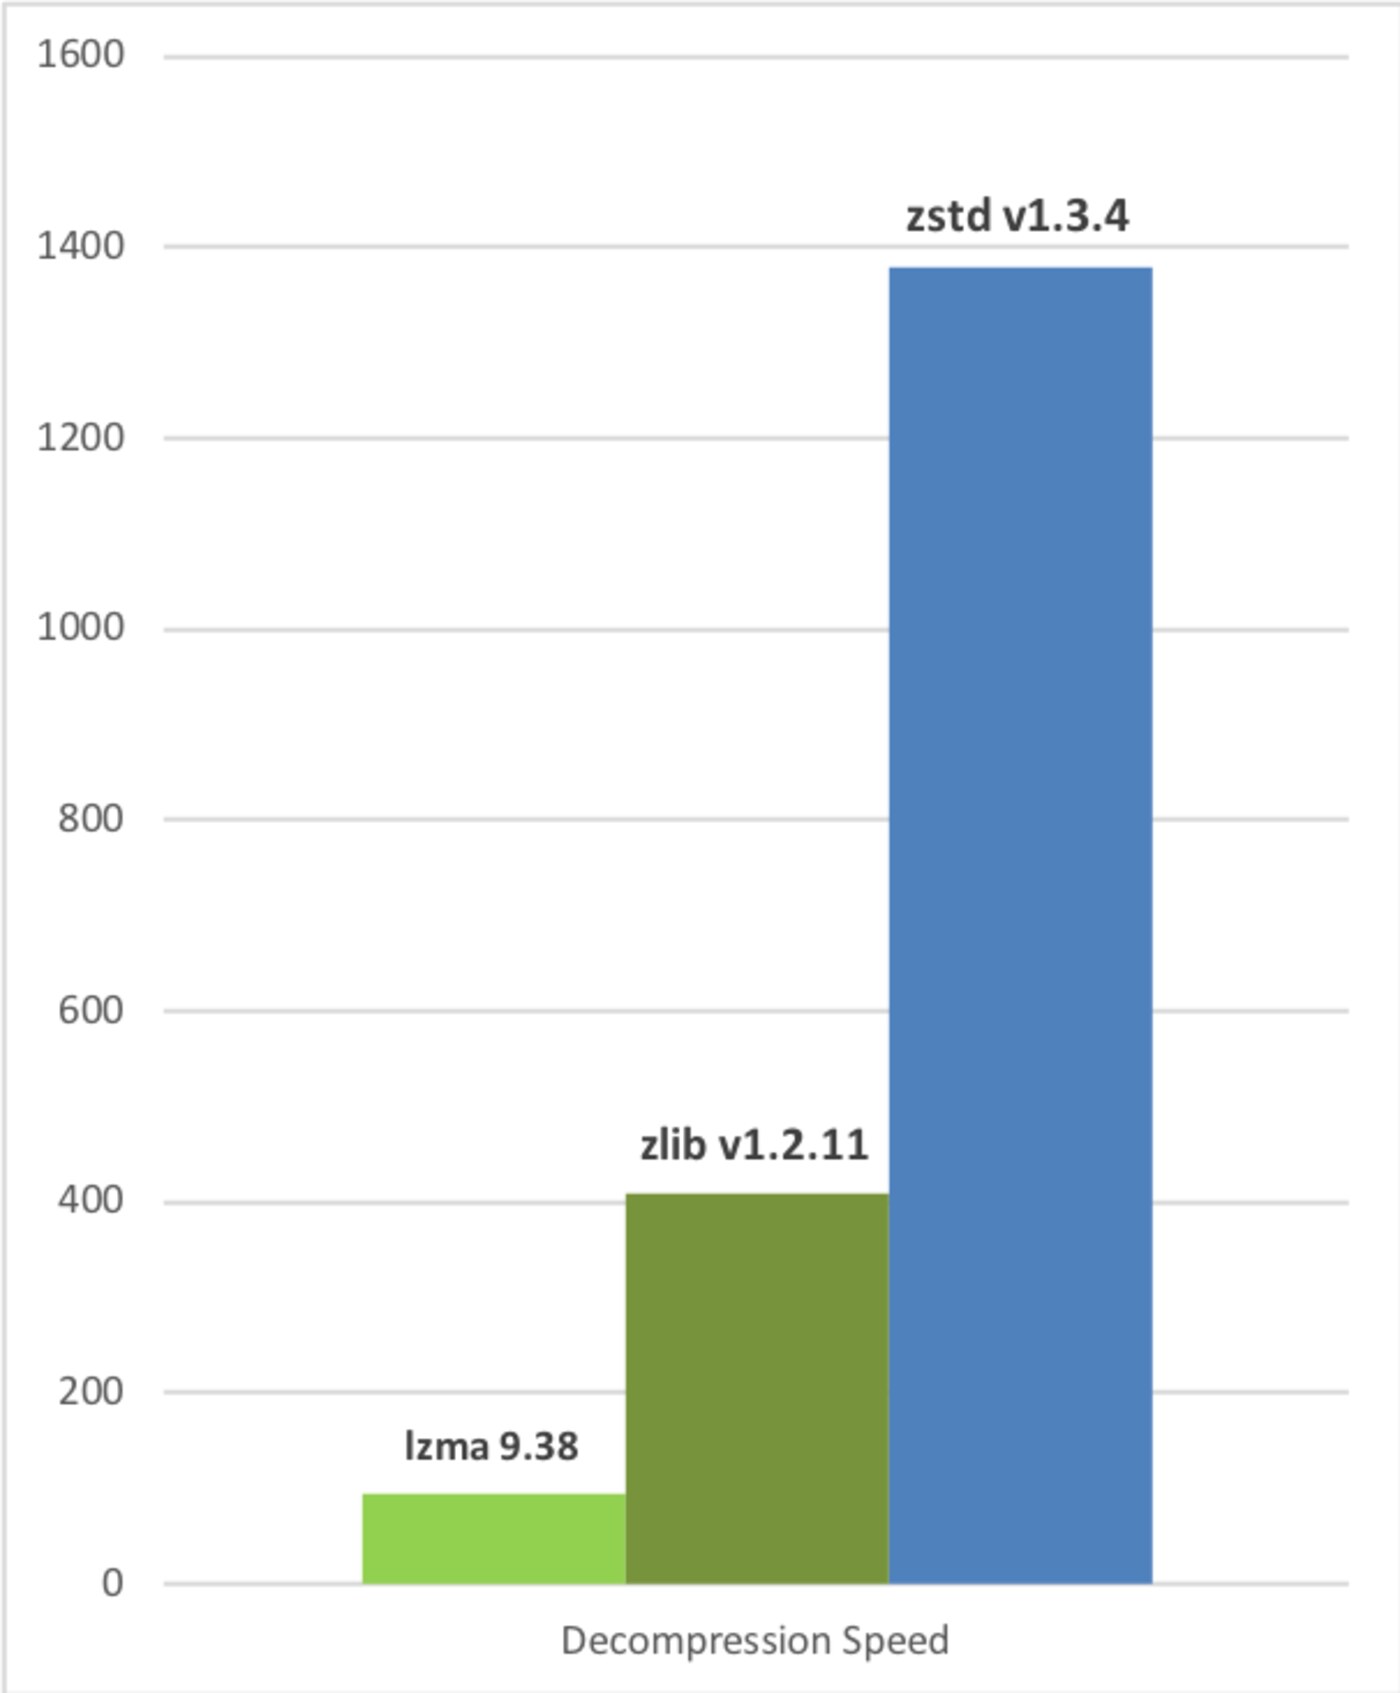
Biểu đồ tốc độ giải nén cho thấy khoảng cách rất lớn giữa zstd và các thư viện nén lâu đời. zstd nằm ở nhóm nén tốc độ cao, trong khi lzma và lzham phải hy sinh tốc độ để đổi lấy tỷ lệ nén nhỏ hơn nhiều.
Nơi zstd đã được sử dụng
zstd được tích hợp vào nhánh chính của nhân Linux: thư mục lib/zstd chứa các tệp nén và giải nén, và bản [Makefile trong mã nguồn nhân](https://raw.githubusercontent.com/torvalds/linux/master/lib/zstd/Makefile) liệt kê các tệp đối tượng gồm zstd_compress.o, zstd_decompress.o, zstd_common.o, fse_compress.o và huf_compress.o, với bản quyền thuộc Meta Platforms và giấy phép BSD-3-Clause hoặc GPL-2.0+.
Tính từ Linux 4.14, zstd trở thành tuỳ chọn nén trong Btrfs và [Squashfs](https://raw.githubusercontent.com/torvalds/linux/master/fs/squashfs/Kconfig), dùng cho cả initramfs và nén zram. Riêng initramfs, tài liệu Kconfig ghi rõ nén tốt hơn GZIP với tốc độ giải nén quanh LZ4. Với Btrfs, mức mặc định là 3 và nhánh nhân chỉ đưa ra các mức từ âm 15 đến 15.
Trên web, zstd đã được đăng ký là Content Coding của HTTP với tên zstd, và [RFC 9659](https://www.rfc-editor.org/rfc/rfc9659.txt) sửa đổi RFC 8878 để yêu cầu bộ giải nén phải hỗ trợ cửa sổ tới 8 MB, đồng thời cấm bộ nén phát ra cửa sổ lớn hơn mức đó qua HTTP. Bản ghi chú phát hành của Firefox 126 cũng đã đưa zstd vào danh sách Content-Encoding mà trình duyệt hiểu.
| So sánh | Tỷ lệ nén | Tốc độ nén | Tốc độ giải nén |
|---|---|---|---|
| zstd mức âm 1 | Thấp nhất trong nhóm zstd | Nhanh nhất, dưới 500 MB/s | Trên 1500 MB/s |
| zstd mức 3 | Cân bằng | Trung bình | Trên 1000 MB/s |
| zstd mức 19 | Cao nhất trong nhóm zstd | Chậm, dưới 5 MB/s | Vẫn nhanh hơn zlib |
| zlib mức 6 | Tương đương zstd mức 3 | Chậm hơn zstd nhiều lần | Chậm hơn zstd nhiều lần |
| gzip mức 6 | Kém hơn zstd | Chậm hơn zlib | Chậm hơn zlib |
Khi nào nên dùng Zstandard
zstd là lựa chọn mặc định hợp lý cho mọi việc nén mới, đặc biệt khi bạn cần giải nén nhanh: hệ thống tệp, sao lưu cơ sở dữ liệu, cache, trao đổi tin nhắn nội bộ, và nén HTTP. Nếu hệ thống cũ chỉ giải nén được gzip, hãy giữ gzip để tương thích. Với dữ liệu nhỏ lặp lại nhiều lần và có cấu trúc giống nhau, huấn luyện bảng từ điển sẽ cho thêm lợi ích đáng kể. Khi dung lượng quan trọng hơn tốc độ và không gấp về thời gian, hãy thử mức 12 trở lên hoặc chuyển sang xz, nhưng đừng quên rằng xz giải nén chậm hơn zstd nhiều lần.
Nguồn tham khảo: đặc tả RFC 8878 về định dạng Zstandard, tài liệu kỹ thuật zstd trong kho mã nguồn chính thức, sổ tay thư viện zstd, bài viết Zstandard trên Wikipedia, và tài liệu nén của Btrfs.