Gradient Descent là gì: Thuật toán tối ưu mọi mô hình học máy
Gradient descent là thuật toán tối ưu cơ bản nhất của học máy, dùng để tìm các tham số tối ưu của một mô hình bằng cách liên tục đi ngược hướng dốc của hàm mất mát. Khi bạn huấn luyện một mô hình tuyến tính, một mạng nơ-ron hay một mô hình ngôn ngữ lớn, xuyên suốt quá trình đó, gradient descent chính là cơ chế điều chỉnh trọng số. Bài viết này giải thích nguyên lý, toán học, các biến thể thực tế, và lý do Adam trở thành lựa chọn mặc định trong hầu hết các framework hiện đại.
Gradient descent giải quyết vấn đề gì?
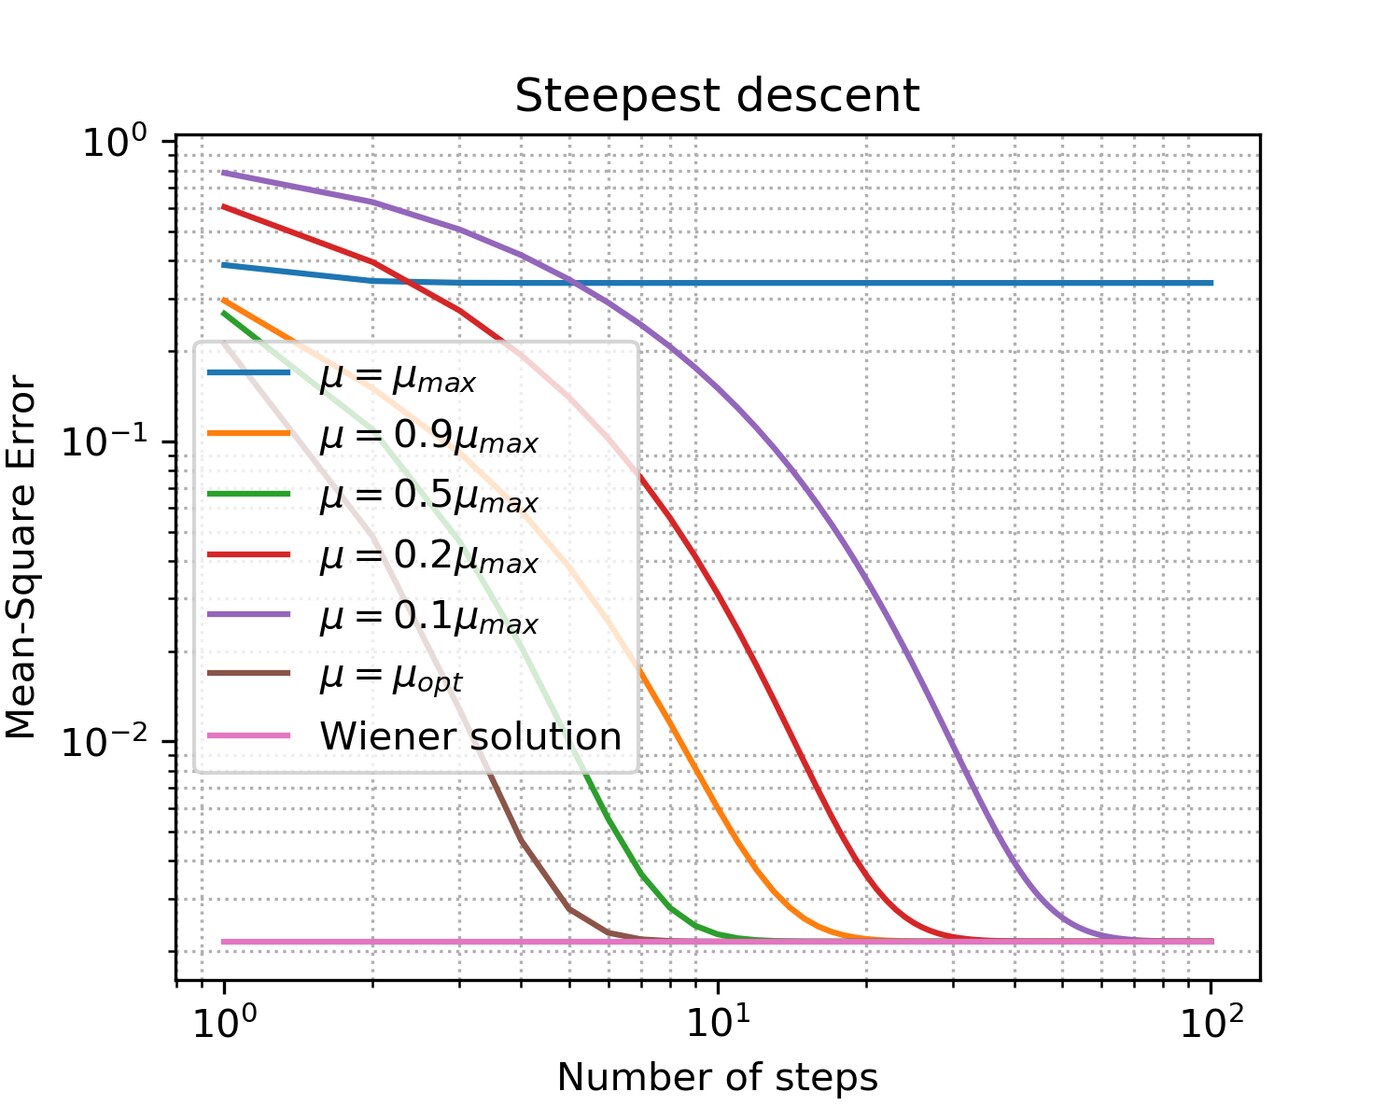
Học máy là bài toán tối ưu. Ta có một hàm mất mát (hàm chi phí) J(w) đo độ tệ của mô hình với bộ tham số w. Mục tiêu là tìm w sao cho J(w) nhỏ nhất. Gradient của một hàm nhiều biến tại một điểm là vector chỉ hướng tăng nhanh nhất của hàm số đó. Nếu ∇J là vector độ dốc đi lên, thì −∇J là vector độ dốc đi xuống nhanh nhất, còn gọi là hướng từ trường tối ưu (steepest descent).
Công thức cập nhật chuẩn là:
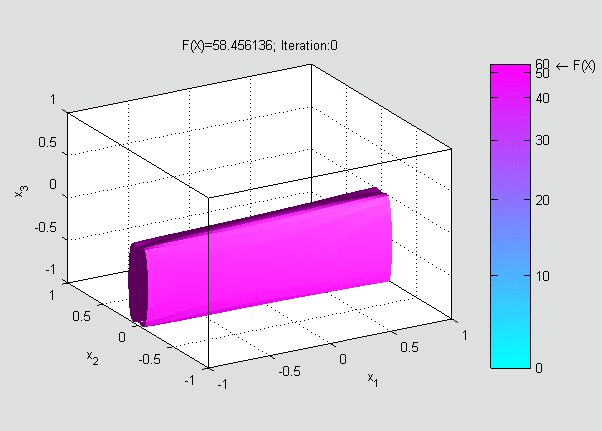
w_{t+1} = w_t − η · ∇J(w_t)Trong đó η (learning rate) là chiều dài bước. Quá nhỏ thì hội tụ chậm, quá lớn thì vượt qua vùng tối ưu, thậm chí phân kỳ. Cách hình dung trực quan nhất là coi J như một mặt địa hình: gradient là độ dốc đi lên, −∇J là hướng xuống dốc, và η là bước chân.
Ba biến thể: batch, stochastic và mini-batch
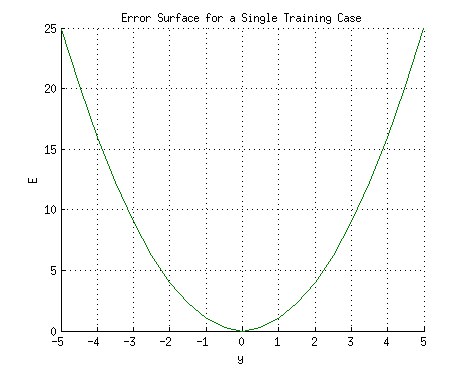
Gradient descent thuần dùng toàn bộ tập dữ liệu cho mỗi lần cập nhật. Trong Deep Learning (Goodfellow, Bengio, Courville), ba cách tính gradient được phân biệt rõ. Bên dưới là hình bề mặt lỗi của một nơ-ron tuyến tính với một mẫu dữ liệu: trục hoành là đầu ra y, trục tung là lỗi E bằng bình phương hiệu giữa đầu ra thực tế và đầu ra mục tiêu bằng 0, cho thấy hàm mất mát của một nơ-ron tuyến tính là một parabol. Mặt đường này chính là “địa hình” mà gradient descent phải đi xuống.
| Biến thể | Số ví dụ mỗi lần cập nhật | Đặc điểm |
|---|---|---|
| Batch gradient descent | Toàn bộ tập dữ liệu | Gradient chính xác, 1 cập nhật = 1 epoch, tốn bộ nhớ |
| Stochastic gradient descent (SGD) | 1 ví dụ | Gradient nhiễu, N cập nhật mỗi epoch, cập nhật rất nhanh mỗi bước |
| Mini-batch gradient descent | Lô nhỏ, thường 32–256 | Thoả hiệp giữa nhiễu và ổn định, phổ biến nhất trong deep learning |
Trong thực tế, deep learning gần như luôn dùng mini-batch với kích thước là lũy thừa của 2, thường trong khoảng 32 đến 256. Ngay cả khi batch rất lớn (lên đến 8192 ảnh), hiệu quả học vẫn giữ được — nghiên cứu Accurate, Large Minibatch SGD cho thấy huấn luyện ResNet-50 với batch 8192 vẫn đạt độ chính xác tương đương.
Điểm yên ngựa và lý do nhiễu lại là điều tốt
Với hàm lồi (convex), gradient descent hội tụ về cực tiểu toàn cục duy nhất. Nhưng hàm mất mát của mạng nơ-ron sâu là hàm không lồi, có rất nhiều cực tiểu cục bộ và đặc biệt là điểm yên ngựa (saddle point): điểm cực tiểu theo một chiều nhưng cực đại theo chiều khác, nên gradient tại đó bằng 0 và thuật toán dừng lại dù chưa tới nghiệm tối ưu. Trong không gian cao chiều, điểm yên ngựa lại phổ biến hơn cực tiểu cục bộ (chương 8 của Deep Learning Book, mục 8.2.3).
May mắn là nhiễu của SGD lại có tác dụng: gradient ước lượng từ mini-batch tạo dao động ngẫu nhiên quanh vùng phẳng, giúp thoát khỏi các vùng hẹp (sharp minima) và giảm overfit. Tài liệu CS231n của Stanford chỉ ra SGD rất khó thoát khỏi điểm yên ngựa nếu không có nhiễu này.
Momentum và Nesterov: tích luỹ đà
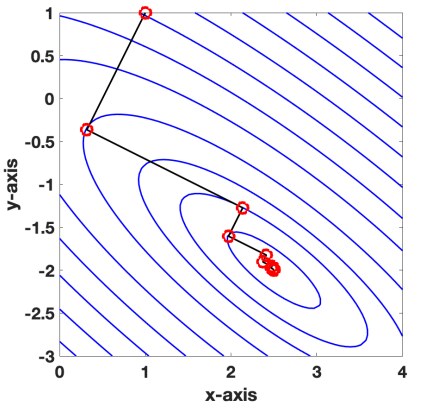
Gradient descent thuần bị “oscillate” (dao động) khi hàm mất mát có hình dạng thon. Ý tưởng của momentum (heavy-ball) là tích luỹ vận tốc từ các bước trước:
b_t = μ · b_{t−1} + g_t
θ_t = θ_{t−1} − γ · b_t
Trong đó μ (momentum) thường đặt trong khoảng 0.9. Nesterov accelerated gradient (NAG) là biến thể “nhìn trước”: tính gradient tại vị trí dự đoán sau momentum, giúp phản ứng chính xác hơn với độ dốc thực tế. Cả hai đều được hỗ trợ trực tiếp trong torch.optim.SGD của PyTorch (tham số nesterov=True).
Adam: vì sao trở thành mặc định
Adam (Kingma & Ba, 2014) kết hợp momentum với ước lượng moment thứ hai, tự điều chỉnh learning rate cho từng tham số. Công thức đầy đủ theo tài liệu torch.optim.Adam:
m_t = β1·m_{t−1} + (1−β1)·g_t        (moment thứ nhất)
v_t = β2·v_{t−1} + (1−β2)·g_t²       (moment thứ hai)
m̂_t = m_t / (1−β1t)
v̂_t = v_t / (1−β2t)
θ_t = θ_{t−1} − η·m̂_t / (√v̂_t + ε)
Tham số mặc định xác minh được từ tài liệu PyTorch và Keras: learning rate = 0.001, β1 = 0.9, β2 = 0.999, epsilon = 1e-8 (Keras dùng 1e-7). Ý nghĩa của phép chia trên là sửa sai lệch (bias correction) ở những bước đầu tiên khi m và v chưa có dữ liệu lịch sử. Paper gốc: Adam: A Method for Stochastic Optimization.
Điều chỉnh learning rate theo lịch
Learning rate thường không cố định mà giảm dần theo lịch để tinh chỉnh ở các bước cuối. Các họ phổ biến:
- Step decay: giảm một hệ số cố định sau mỗi khoảng epoch (ví dụ ×0.5 mỗi 5 epoch, hoặc ×0.1 mỗi 20 epoch).
- Exponential decay:
α = α0·e^(−kt). - Cosine annealing: theo lều từ
η_maxxuốngη_mintheo đường cos, thường kèm warm restarts (SGDR, Loshchilov & Hutter). - ReduceLROnPlateau: giảm learning rate khi metric ngừng cải thiện sau
patienceepoch (mặc địnhfactor=0.1, patience=10, threshold=1e-4).
Không có con số vàng cho learning rate: CS231n khuyến nghị quét log-uniform trong khoảng 10−6 đến 101, với heuristic tỷ lệ cập nhật trên giá trị tham số xấp xỉ 10−3.
Lịch sử và nguồn tham khảo
Gradient descent được quy cho Augustin-Louis Cauchy, người đề xuất nó vào năm 1847; tính chất hội tụ của nó cho tối ưu phi tuyến được Haskell Curry nghiên cứu vào năm 1944, theo lịch sử trên Wikipedia.
Tóm lại, gradient descent là xương sống của mọi quy trình huấn luyện mô hình. Nếu bạn hiểu rõ cách learning rate, momentum và Adam điều chỉnh đường đi xuống đỉnh của hàm mất mát, bạn sẽ dễ dàng chẩn đoán các hiện tượng quen thuộc: loss không giảm (learning rate quá lớn), loss giảm quá chậm (quá nhỏ), hay mô hình hội tụ tới cực tiểu cục bộ kém (cần regularization hoặc momentum cao hơn).