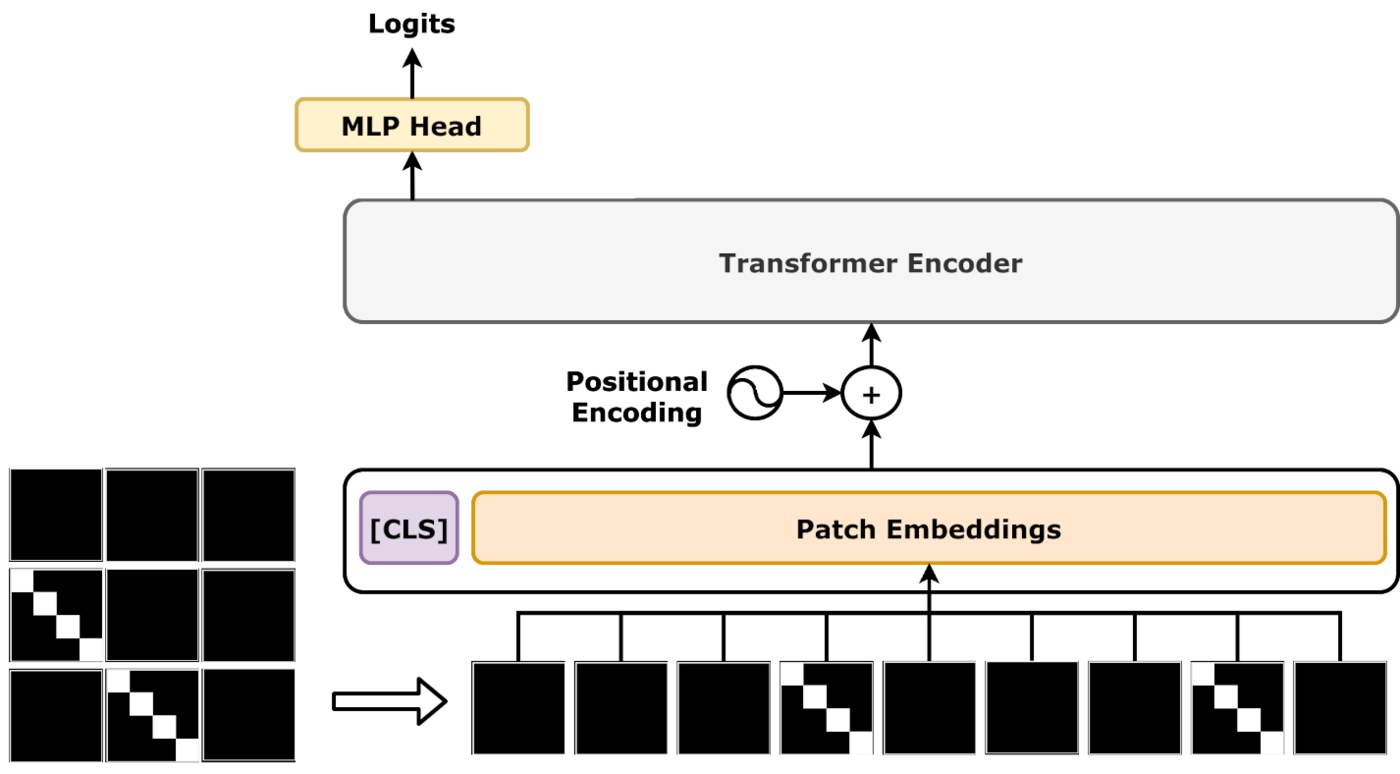
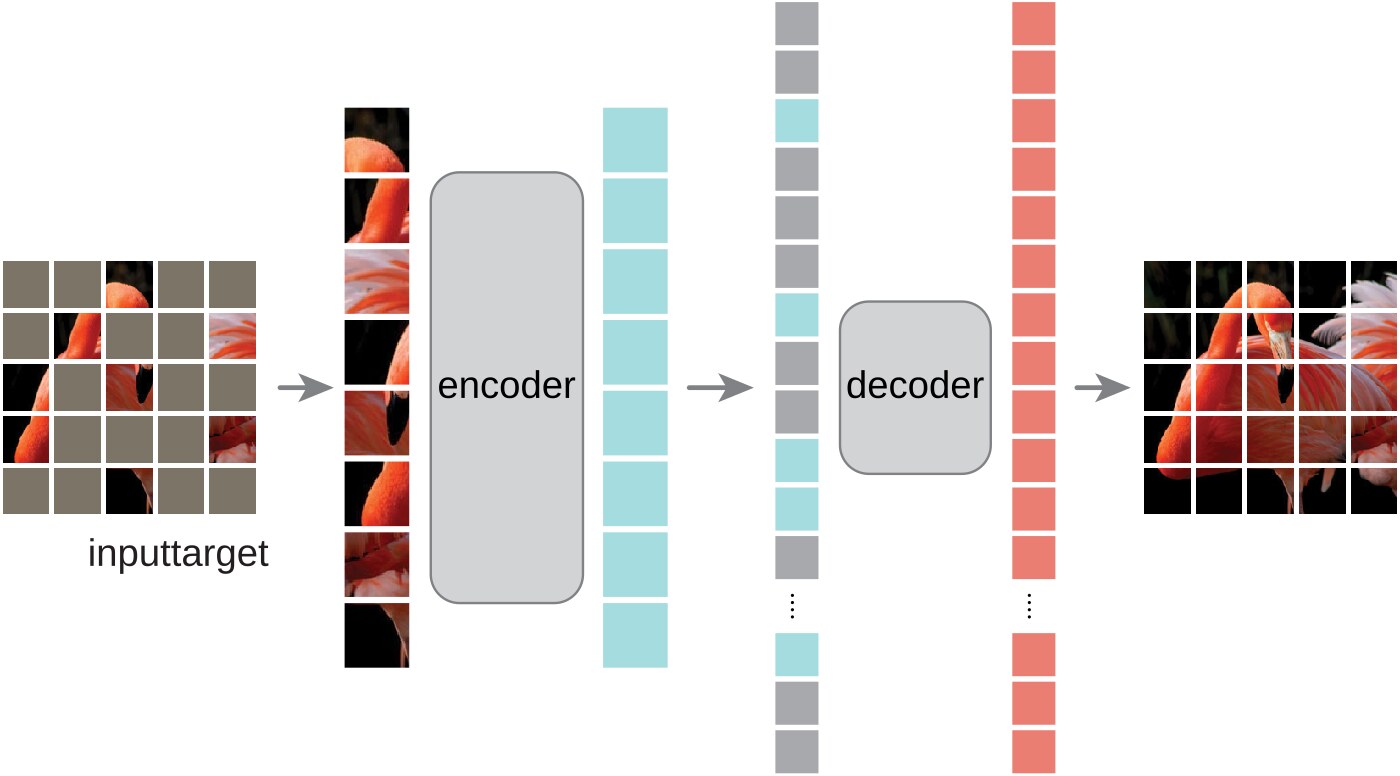
Vision Transformer (ViT) là kiến trúc mô hình AI xử lý ảnh bằng chính cơ chế tự chú ý (self-attention) của Transformer, thay cho tích chân tích. Thay vì quét ảnh bằng các bộ lọc tích chập, ViT cắt ảnh thành những ô vuông nhỏ rồi coi mỗi ô là một token, giống như một câu văn trong ngôn ngữ.
Ý tưởng này xuất phát từ bài báo An Image is Worth 16×16 Words, đăng trên arXiv với mã 2010.11929, do Alexey Dosovitskiy cùng nhóm tại Google Research và Đại học Cambridge viết năm 2020. Bài báo đặt câu hỏi đơn giản: nếu bỏ hết tích chập đi và dùng nguyên kiến trúc Transformer vốn sinh ra cho văn bản, hiệu quả có còn tốt không?
Vision Transformer cắt ảnh như thế nào
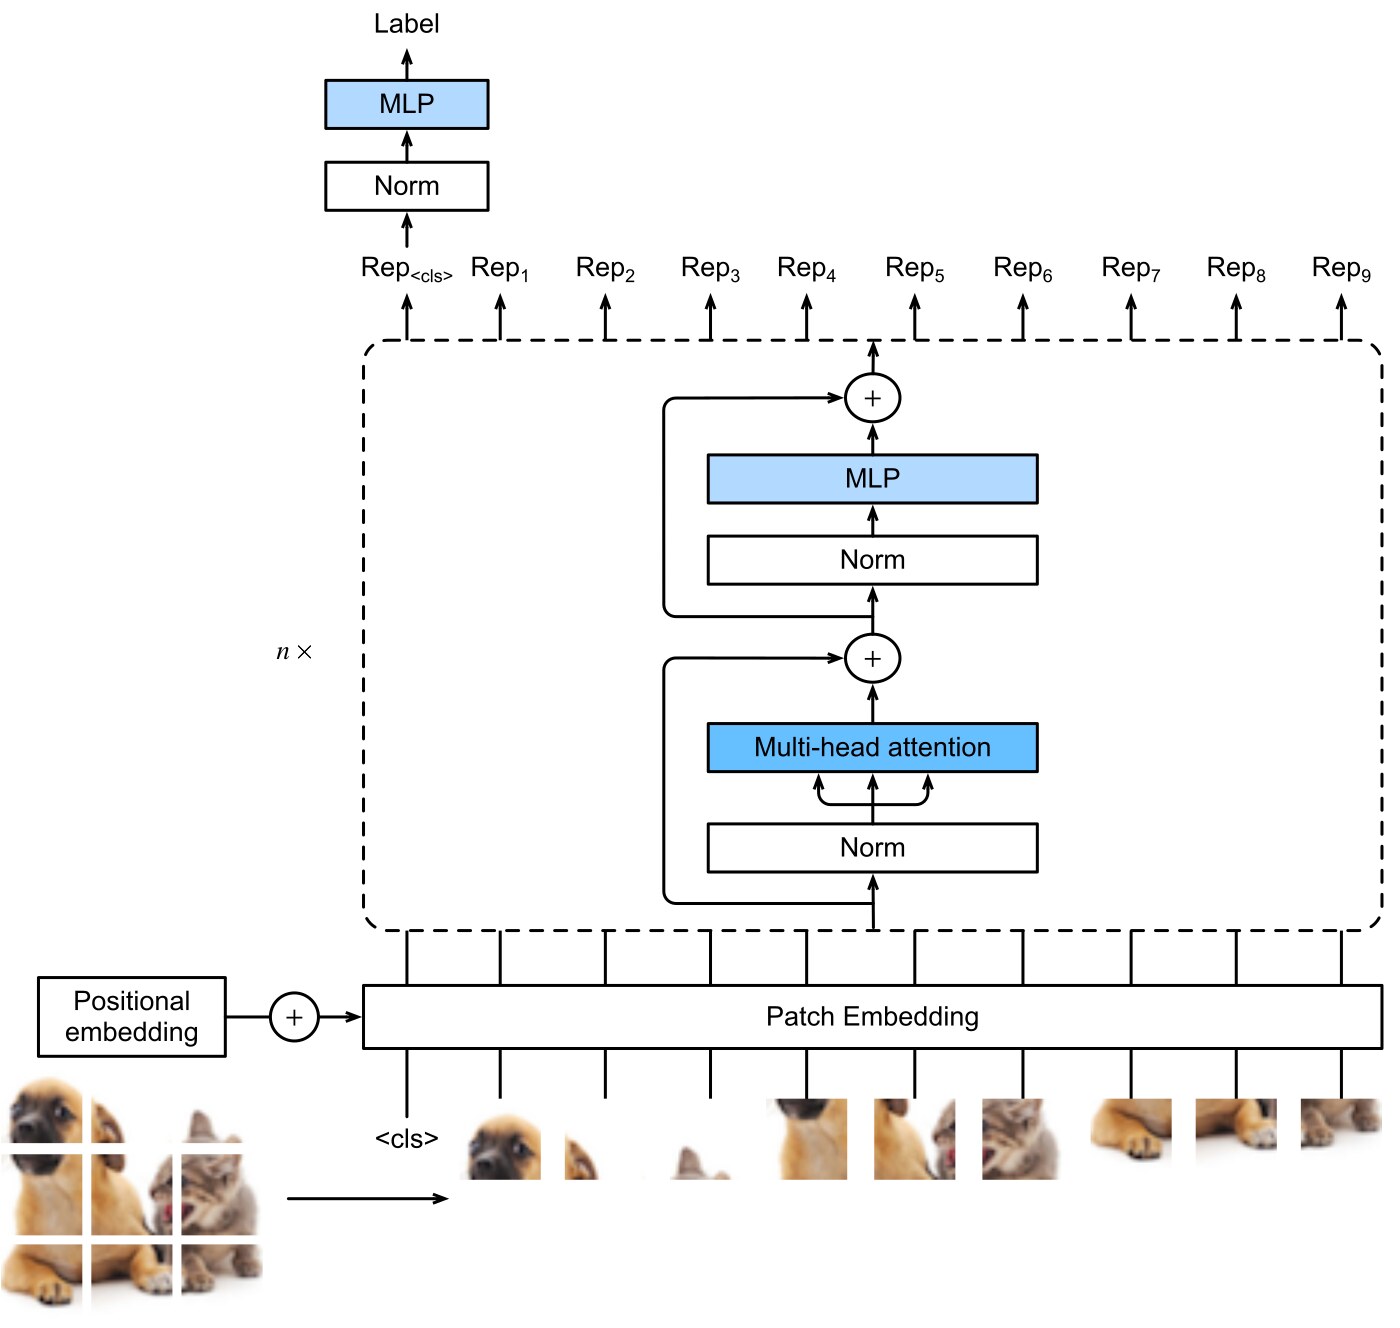
Quy trình biến một bức ảnh thành chuỗi token gồm bốn bước:
- Cắt thành patch vuông. Một ảnh kích thước H nhân W được chia thành các ô cạnh P pixel. Số ô là N = H×W / P², và mỗi ô được làm phẳng thành một vector có P²×C chiều, với C là số kênh màu.
- Chiếu tuyến tính. Mỗi vector patch được đưa qua một lớp chiếu tuyến tính để đưa về cùng số chiều ẩn với các phần tử còn lại của mô hình.
- Thêm token CLS. Bài báo mô tả thêm một token phân loại có thể học được vào đầu chuỗi. Đầu ra của token này được đưa qua một mô hình perceptron nhỏ với hàm kích hoạt tanh để suy ra nhãn lớp.
- Thêm position embedding. Cơ chế tự chú ý không tự biết thứ tự, nên vị trí của mỗi ô phải được mã hoá bằng vector vị trí cộng vào.
Với ảnh 224×224 pixel và patch 16×16, công thức N = (224 / 16)² cho ra đúng 196 ô, tức 197 token sau khi thêm token CLS. Bài báo cũng lưu ý chiều dài chuỗi tỉ lệ nghịch với bình phương kích thước patch, nên dùng patch 32×32 sẽ chỉ còn 49 ô.
Các biến thể ViT và quy mô tham số
Bảng tham số trong bài báo gốc chia ViT thành ba cấu hình chính, ký hiệu ViT-L/16 nghĩa là phiên bản Large dùng patch 16×16:
| Phiên bản | Số lớp | Chiều ẩn | Chiều MLP | Số đầu chú ý | Số tham số |
|---|---|---|---|---|---|
| ViT-Base | 12 | 768 | 3072 | 12 | 86 triệu |
| ViT-Large | 24 | 1024 | 4096 | 16 | 307 triệu |
| ViT-Huge | 32 | 1280 | 5120 | 16 | 632 triệu |
Lưu ý số tham số gần như bằng đúng một nửa so với biến thể lớn hơn liền kề: 86 triệu so với 307 triệu, 307 triệu so với 632 triệu. Đây là đặc điểm của bảng tham số Transformer, không phải của riêng ViT.
Hiệu năng thực tế và chi phí huấn luyện
Khi tiền huấn luyện trên tập JFT-300M rồi tinh chỉnh trên ImageNet, bảng kết quả của bài báo ghi nhận:
- ViT-Huge/14 đạt độ chính xác top-1 trên ImageNet là 88,55% và trên ImageNet-ReaL là 90,72%.
- Trên CIFAR-10 đạt 99,50%, CIFAR-100 đạt 94,55% và bộ VTAB gồm 19 nhiệm vụ đạt 77,63%.
- ViT-Large/16 cùng huấn luyện JFT đạt 87,76% top-1; nếu chỉ dùng ImageNet-21k thì đạt 85,30%.
- Để so sánh, BiT-L dùng ResNet152x4 đạt 87,54% và Noisy Student với EfficientNet-L2 đạt khoảng 88,4%.
Về mặt tính toán, bài báo ước lượng ViT dùng khoảng hai đến bốn lần ít hơn để đạt cùng mức hiệu năng. Đơn vị đo là ngày lõi TPUv3: ViT-Huge/14 tốn 2,5 nghìn, ViT-Large/16 huấn luyện JFT tốn 680, bản ImageNet-21k tốn 230, trong khi BiT-L tốn 9,9 nghìn và Noisy Student tốn 12,3 nghìn.
Điểm yếu: thiếu thiên lệch cảm giác không gian
Nguyên nhân ViT cần dữ liệu lớn nằm ở thiên lệch cảm giác không gian (inductive bias). Ngôn ngữ nghiên cứu viết thẳng rằng Vision Transformer có thiên lệch riêng về ảnh ít hơn nhiều so với mạng tích chập. Trong CNN, tính cục bộ, cấu trúc lân cận hai chiều và tính bất biến dịch chuyển được đặt sẵn vào từng lớp. Còn ở ViT, chỉ các lớp MLP là cục bộ và bất biến dịch chuyển, còn lớp tự chú ý là toàn cục.
Hệ quả trực tiếp là ViT dễ bị quá phù hợp với tập huấn luyện hơn ResNet khi dữ liệu nhỏ, và mô hình chỉ thấy hết lợi thế ở quy mô rất lớn. Hướng cải thiện đi theo ba hướng:
- Đầy đủ thiên lệch vào không gian chỉ xuất hiện ở đúng hai chỗ: cách cắt patch và phép nội suy position embedding khi đổi độ phân giải.
- DeiT thay giải pháp đồ giảm bằng một token phân giải (distillation token), để mô hình học từ một giáo viên là mạng tích chập. Kết quả là 83,1% top-1 trên ImageNet cho bản 86 triệu tham số mà không cần dữ liệu ngoài, rồi lên 85,2% khi dùng token phân giải.
- DINO huấn luyện không nhãn bằng chính token CLS để gom thông tin cả chuỗi, đạt 78,3% top-1 với đánh giá k-nearest-neighbor và 80,1% với đánh giá tuyến tính trên ViT-Base.
Nói cách khác, thiên lệch tích chập không phải thứ bị bỏ đi vô điều kiện, mà là thứ phải bù lại bằng dữ liệu và bằng kiến trúc. Đây chính là lý do các mô hình thương mại hiện nay thường kết hợp cả hai: phần xương sống là tích chập để bắt cục bộ, phần còn lại là tự chú ý để gom ngữ cảnh toàn cục.
Dùng ViT trong thực tế
Với tài liệu Hugging Face cho mô hình ViT, các giá trị mặc định là kích thước ảnh 224, patch 16, 12 lớp ẩn và 12 đầu chú ý, công thức số patch là (kích thước ảnh chia cho kích thước patch) bình phương. Khi tinh chỉnh trên ảnh có độ phân giải khác 224, cần bật tham số nội suy position embedding để mô hình không bị lệch vị trí.
Với tập dữ liệu nhỏ, cách dùng hợp lý là tải trọng số đã tiền huấn luyện rồi đóng băng phần trục, hoặc chỉ tinh chỉnh các lớp cuối. Bài báo gốc ghi nhận kết quả chuyển với dữ liệu ít trên bộ VTAB khá đáng kể, và quy trình tinh chỉnh dùng SGD có động lượng, batch 512, kết hợp tăng độ phân giải ở giai đoạn cuối.
Tóm lại, Vision Transformer đổi một bài toán thị giác thành một bài toán xử lý chuỗi, và mọi điểm mạnh cùng điểm yếu của Transformer đều được thừa hưởng nguyên vẹn: rất mạnh khi có đủ dữ liệu và đủ tính toán, nhưng cần cẩn trọng khi dữ liệu khan hiếm.
Nguồn tham khảo: bài báo gốc trên arXiv, bản toàn văn có bảng số liệu, tài liệu Hugging Face, bài về DeiT, bài về DINO và mã nguồn DINO.