Bloom filter là gì? Cấu trúc dữ liệu xác suất chống trùng lặp
Bloom filter là cấu trúc dữ liệu xác suất dùng một mảng bit và nhiều hàm băm để trả lời câu hỏi phần tử có nằm trong một tập hợp hay không. Điểm mạnh của nó là cực tiết kiệm bộ nhớ, thao tác thêm và kiểm tra đều chạy trong thời gian gần như cố định, còn điểm yếu là chấp nhận khả năng báo nhầm. Cấu trúc dữ liệu này được nhà khoa học máy tính Burton Howard Bloom đề xuất vào năm 1970, và cho đến nay vẫn là lựa chọn mặc định của rất nhiều hệ thống lớn khi cần loại bỏ phần lớn số lần truy vấn không cần thiết.
Bloom filter hoạt động như thế nào
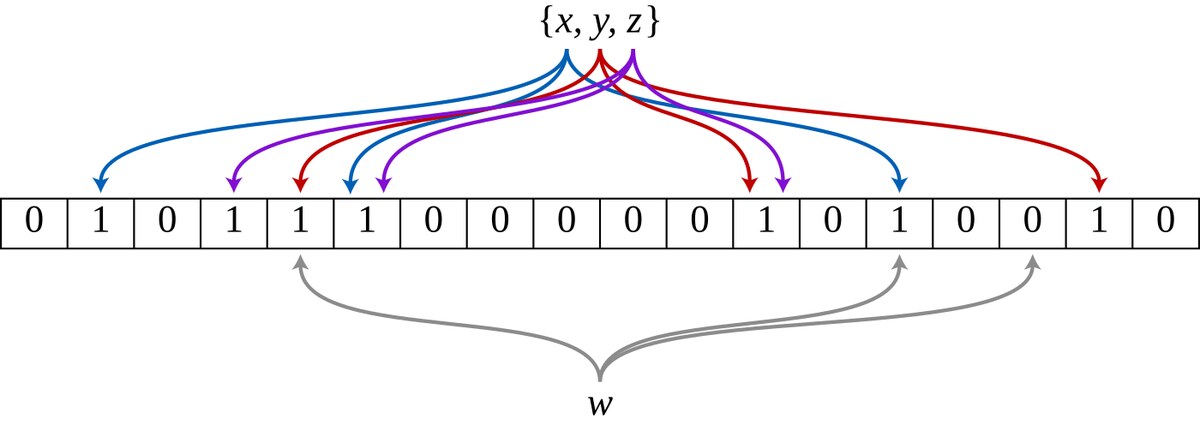
Một Bloom filter khởi tạo gồm một mảng gồm m bit, tất cả đều bằng 0, kèm với k hàm băm độc lập. Quy trình thêm một phần tử và kiểm tra một phần tử diễn ra như sau:
- Bước 1 — Thêm phần tử: đưa phần tử qua cả k hàm băm, mỗi hàm trả về một chỉ số trong mảng. Đặt tất cả các bit tại những chỉ số đó thành 1.
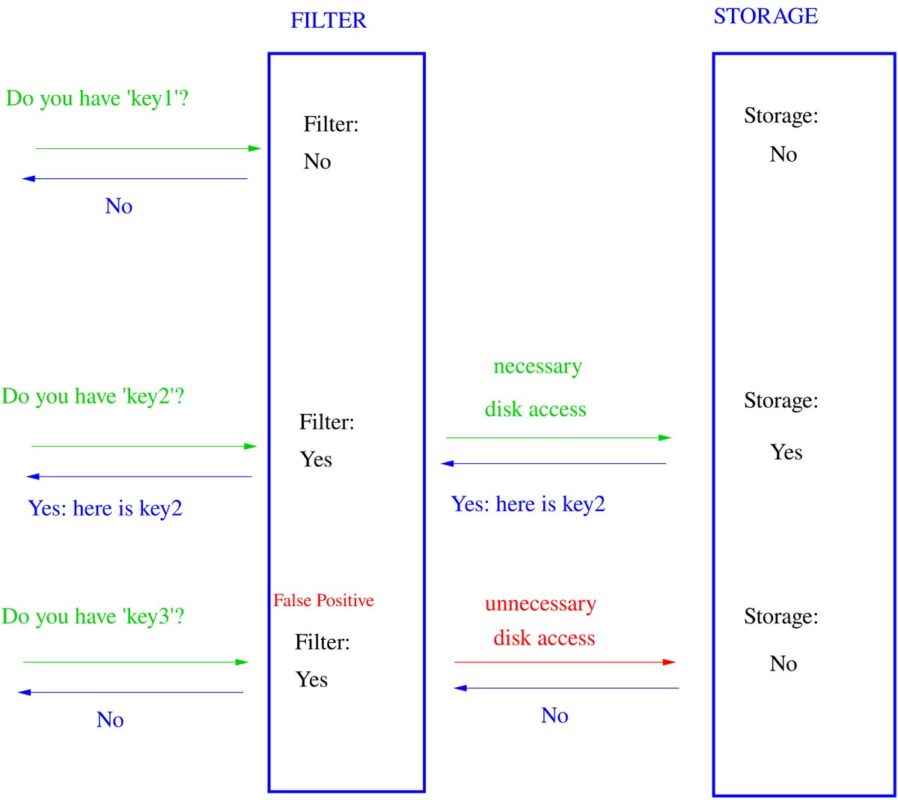
- Bước 2 — Kiểm tra phần tử: tính lại k chỉ số như bước trên. Nếu bất kỳ bit nào vẫn bằng 0, phần tử chắc chắn không có trong tập hợp. Nếu tất cả đều bằng 1, phần tử hoặc là có, hoặc là gặp may mắn trùng với các phần tử đã thêm trước đó.
- Bước 3 — Kết luận: Bloom filter không bao giờ báo nhầm về chiều âm, tức không bao giờ nói một phần tử có thật sự nằm trong tập là không có. Sai sót chỉ xảy ra theo chiều khác: nó có thể báo có cho một phần tử thực sự không tồn tại. Tỉ lệ sai sót này gọi là tỉ lệ dương giả.
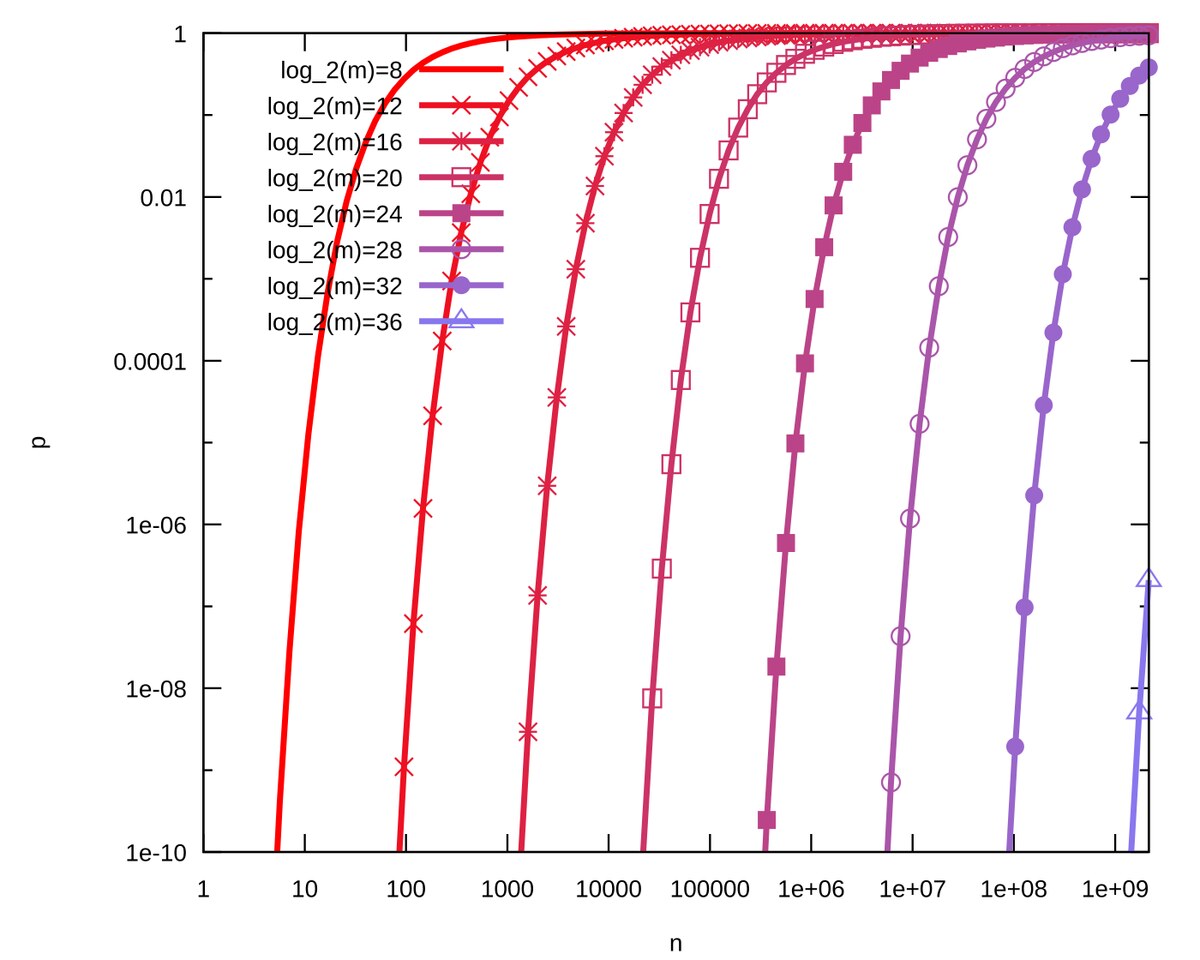
Việc chọn tham số có công thức rõ ràng. Với n phần tử và mục tiêu tỉ lệ dương giả p, số bit cần dùng là m = -n·ln(p) / (ln2)² và số hàm băm tối ưu là k = (m/n)·ln2. Với mục tiêu 1 phần trăm, mỗi phần tử chỉ cần khoảng 9,6 bit, độc lập với việc phần tử dài bao nhiêu. Giảm tỉ lệ dương giả xuống còn 0,1 phần trăm chỉ cần thêm khoảng 4,8 bit cho mỗi phần tử nữa.
Vì sao Bloom filter lại tiết kiệm bộ nhớ
Bộ lọc này không lưu phần tử, chỉ lưu trạng thái của các bit. Một cây tìm kiếm cân bằng hay một bảng băm thông thường phải lưu cả khóa lẫn con trỏ, nên chi phí bộ nhớ tăng theo độ dài của phần tử. Bloom filter bỏ hẳn phần đó đi, nhờ vậy nó thắng áp đảo khi tập hợp rất lớn nhưng phần tử lại ngắn, ví dụ như tập hợp mã định danh URL hợp lệ.
| Cấu trúc dữ liệu | Bộ nhớ mỗi phần tử | Kiểm tra thành viên | Khả năng sai |
|---|---|---|---|
| Bloom filter | khoảng 10 bit cho sai 1% | O(k), gần như cố định | Chỉ dương giả |
| Bảng băm | Vài chục byte trở lên | Trung bình O(1) | Không, nếu xử lý va chạm đúng |
| Cây tìm kiếm nhị phân | Vài chục byte cộng con trỏ | O(log n) | Không |
| Mảng bit tất định | 1 bit cho mỗi giá trị có thể có | O(1) | Không |
Bảng so sánh cho thấy điểm mấu chốt: Bloom filter đánh đổi một chút độ chính xác lấy dung lượng và tốc độ. Khi số giá trị khả thể nhỏ và phần lớn đều xuất hiện trong tập, một mảng bit tất định lại rẻ hơn nhiều, vì nó chỉ tốn đúng một bit cho mỗi giá trị. Bloom filter chỉ thắng khi không gian giá trị khả thể lớn hơn rất nhiều so với số phần tử thực sự lưu.
Giới hạn và lỗi thường gặp
- Không xóa được phần tử: bộ lọc không biết bit nào thuộc về phần tử cần xóa. Xóa bất kỳ bit nào cũng có thể làm mất phần tử khác, tạo ra sai sót âm giả, tức loại lỗi nguy hiểm hơn nhiều. Muốn xóa thì phải dùng biến thể đếm, hay Counting Bloom Filter, nơi mỗi vị trí lưu một bộ đếm thay vì một bit.
- Tỉ lệ dương giả tăng theo số phần tử thêm: càng thêm nhiều, càng nhiều bit chuyển sang 1 và bộ lọc càng dễ nói nhầm có. Khi tỉ lệ sai vượt ngưỡng chấp nhận được, chỉ có cách dựng lại bộ lọc từ đầu.
- Cần nhiều hàm băm thực sự độc lập: dùng cùng một hàm băm với các hạt giống khác nhau là cách phổ biến để lấy nhiều chỉ số. Nếu dùng nhầm cách băm chuỗi ký tự chuyển tiếp, chất lượng phân bố sẽ tệ và tỉ lệ sai tăng vọt.
- Bộ lọc cũ dần theo thời gian: nếu tập hợp thay đổi liên tục mà bộ lọc không được làm mới, tỉ lệ dương giả sẽ trượt dần lên và bộ lọc mất hết tác dụng.
Ứng dụng thực tế và cách dùng
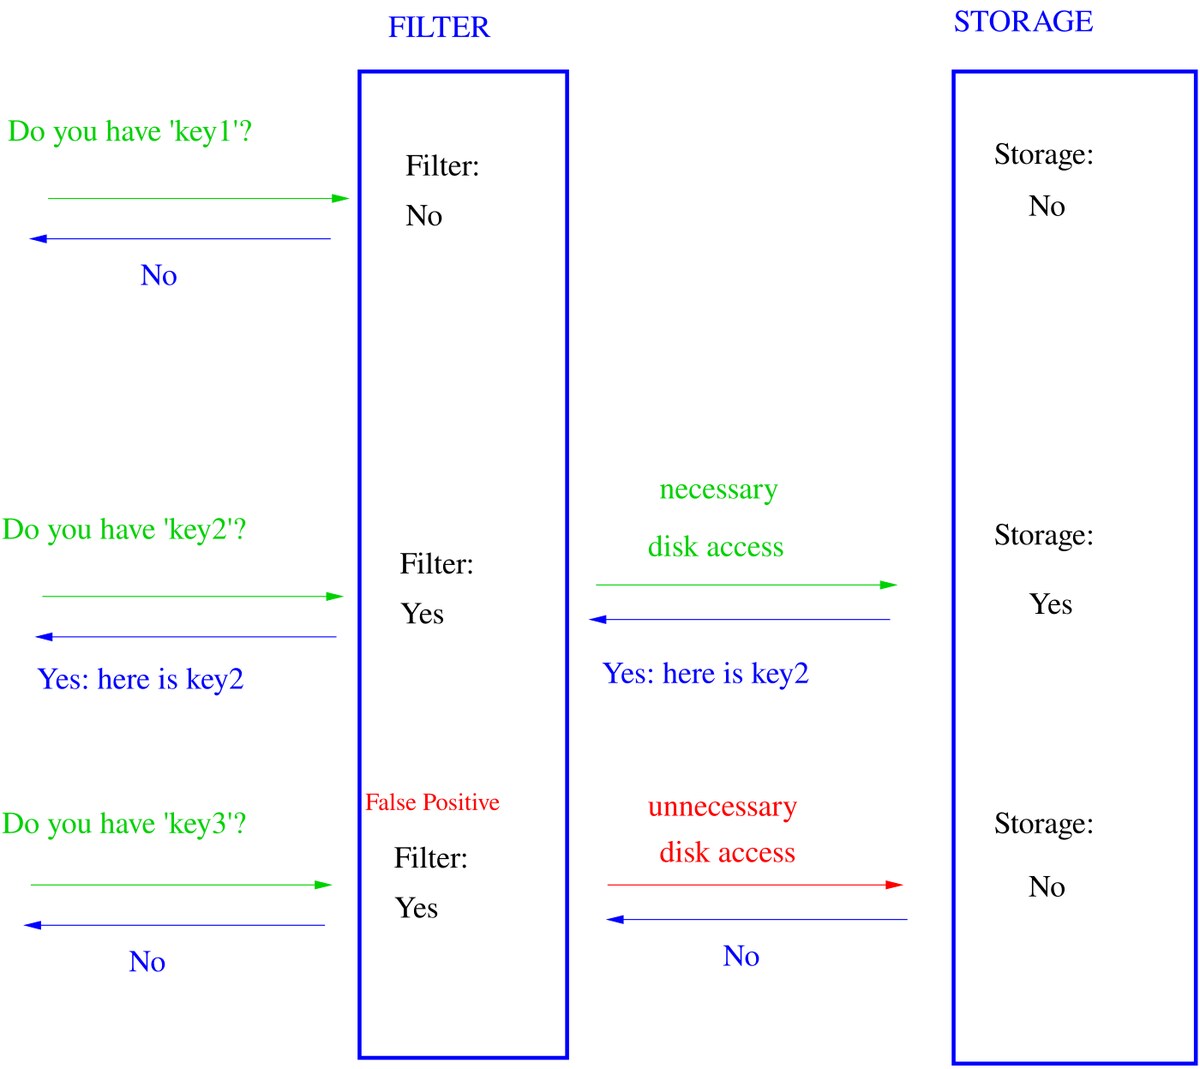
Việc loại bỏ phần lớn số lần đọc đĩa không cần thiết chính là lý do Bloom filter được dùng rộng rãi: bộ lọc trong bộ nhớ kiểm tra trước, chỉ khi trả lời có thì hệ thống mới đi tìm dữ liệu thật. Ngoài ra còn có các ứng dụng quen thuộc như chống truy cập lặp lại ở tầng CDN, lọc phần tử đã xem trong danh sách khuyến nghị, kiểm tra thành viên của tập hợp rất lớn, và chống lạm dụng hình thức đăng ký tài khoản miễn phí.
Trong hệ sinh thái Redis có sẵn module Bloom filter, nên không cần tự viết thuật toán. Hai lệnh cơ bản là thêm và kiểm tra thành viên:
BF.ADD filter1 "chuhung.net"
BF.EXISTS filter1 "chuhung.net"
BF.EXISTS filter1 "mot-domain-khac.com"
Lệnh BF.ADD trả về 1 nếu phần tử mới, 0 nếu đã tồn tại. Lệnh BF.EXISTS trả về 1 nghĩa là chắc chắn có, 0 nghĩa là chắc chắn không có. Chi tiết về tham số cấu hình, tài liệu chính thức nằm trong trang lệnh BF.ADD của Redis.
Nếu tự triển khai, hãy chọn m và k theo công thức ở trên thay vì đoán mò, và luôn theo dõi tỉ lệ dương giả thực tế sau khi nạp dữ liệu. Bạn có thể đọc thêm phần giải thích chi tiết và lịch sử phát minh trong bài Bloom filter trên Wikipedia, cùng khái niệm nền về hàm băm để hiểu rõ vì sao chất lượng băm quyết định tỉ lệ sai.