CQRS (Command Query Responsibility Segregation) là một mẫu kiến trúc phần mềm tách biệt hai loại thao tác: thao tác ghi (command) thay đổi trạng thái hệ thống và thao tác đọc (query) chỉ lấy dữ liệu về mà không làm thay đổi gì. Trong bài viết này, chúng ta sẽ phân tích cấu trúc, cơ chế hoạt động, lợi ích cũng như điểm yếu của mẫu thiết kế này.
Nhiều hệ thống doanh nghiệp hiện đại gặp phải một nghịch lý: cùng một lớp nghiệp vụ vừa phải xử lý đặt hàng, vừa phải trả về danh sách báo cáo phức tạp, vừa ghi log, vừa xử lý retry. Khi số lượng yêu cầu và độ phức tạp nghiệp vụ tăng lên, mô hình này nhanh chóng trở nên rối rắm và khó mở rộng. CQRS ra đời để giải quyết chính xác vấn đề đó.
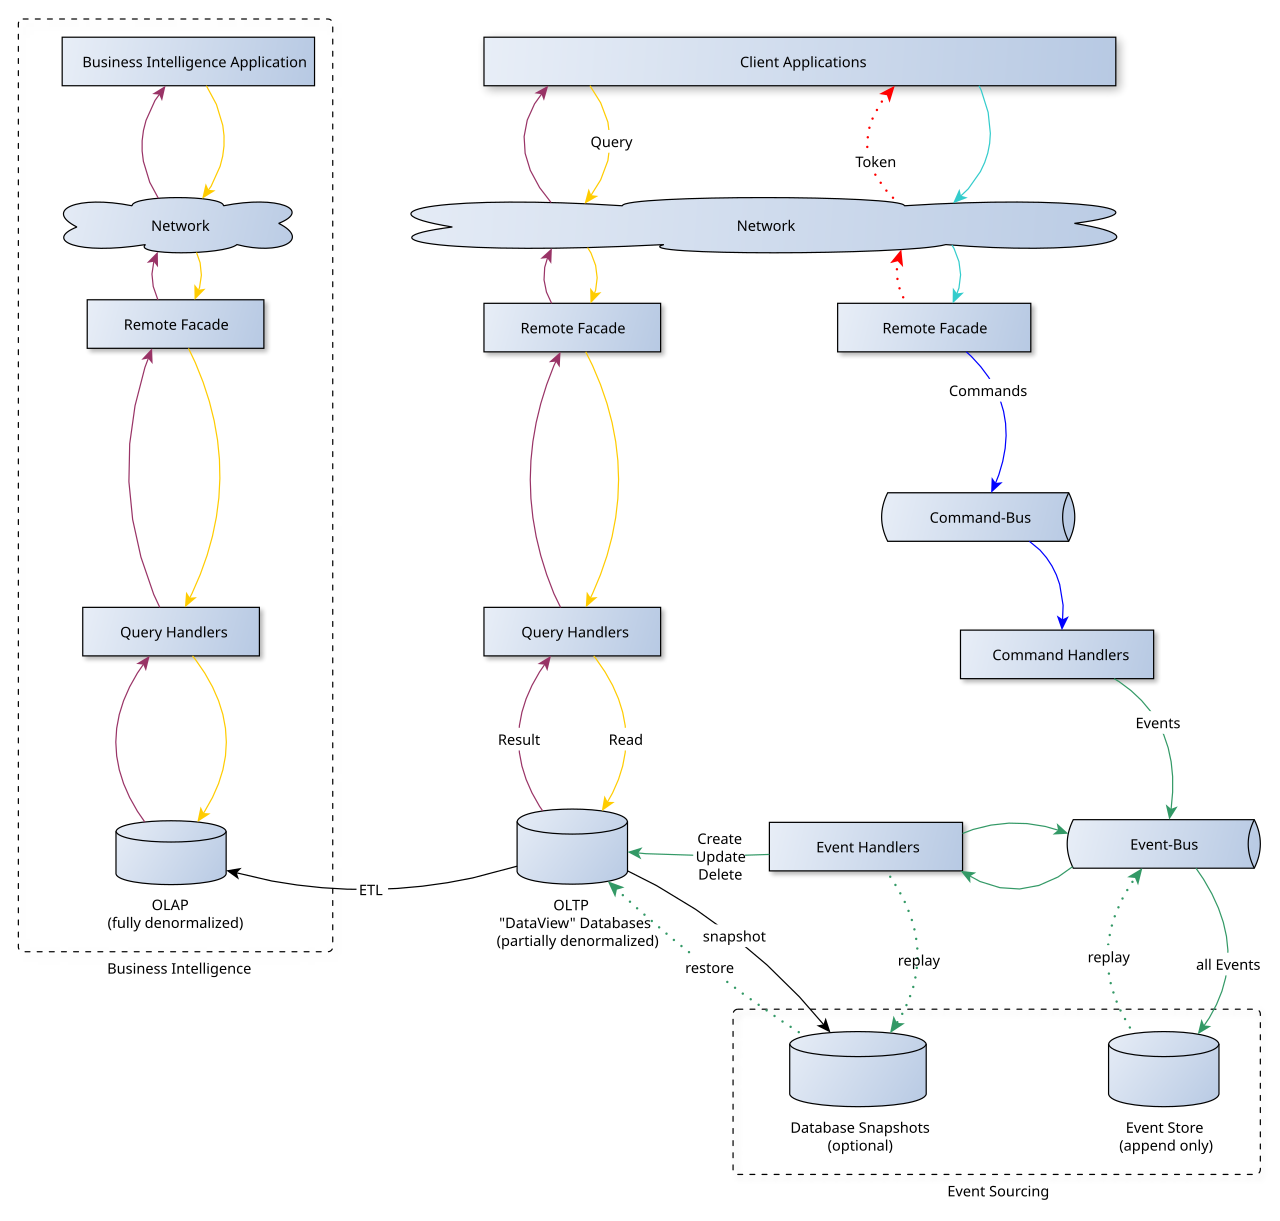
CQRS là gì
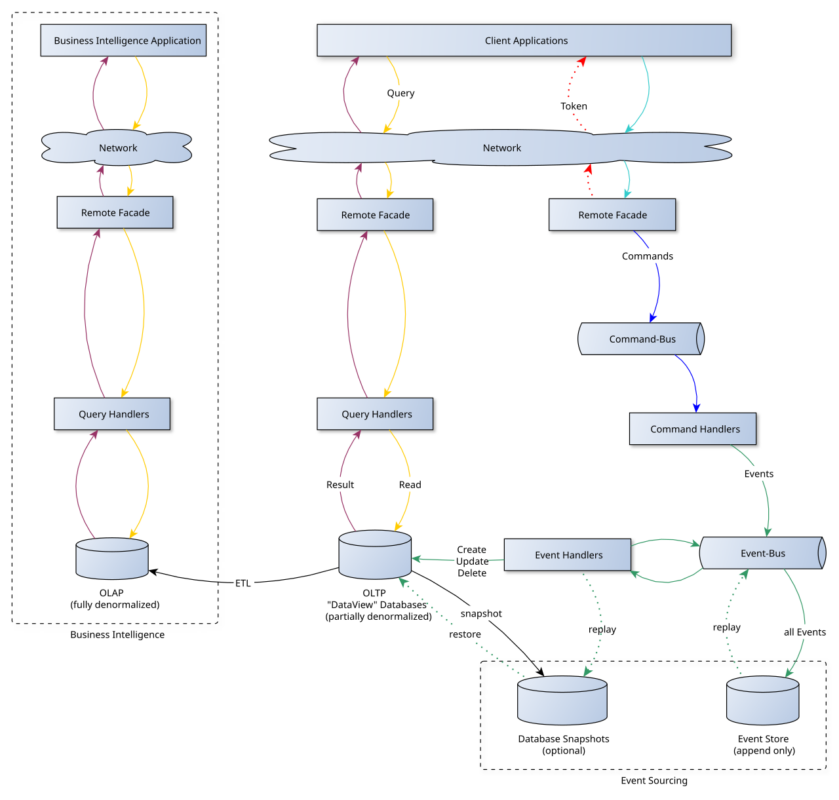
CQRS là một kiến trúc phần mềm mở rộng ý tưởng command-query separation (CQS) từ cấp độ hàm lên cấp độ dịch vụ. Trong hệ thống CQRS, sẽ có hai giao diện API riêng biệt:
- Query — chỉ đọc dữ liệu và trả về kết quả, tuyệt đối không thay đổi trạng thái hệ thống (ngoại trừ các thao tác phụ như ghi log truy cập).
- Command — mang ý nghĩa thay đổi trạng thái: tạo, sửa, xoá hoặc kích hoạt một quy trình nghiệp vụ nào đó.
Nhiều hệ thống CQRS hiện đại còn đẩy việc tách biệt này xuống tận tầng dữ liệu. Mô hình dùng để xử lý truy vấn thường được gọi là read model, còn mô hình dùng để xử lý lệnh là write model. Hai mô hình này có thể dùng chung một database hoặc tách hoàn toàn thành hai database riêng, tuỳ mức độ phức tạp của hệ thống.
CQRS thường đi kèm với Event Sourcing — trong đó mọi thay đổi trạng thái đều được lưu lại như một chuỗi sự kiện bất biến. Tuy nhiên hai khái niệm này là hai thứ độc lập: bạn hoàn toàn có thể dùng CQRS mà không cần Event Sourcing.
Lịch sử phát triển của CQRS thường được quy cho Greg Young vào khoảng năm 2010, khi ông phổ biến nó trong cộng đồng .NET. Tuy nhiên nhiều tài liệu chỉ ra tiền thân là Udi Dahan, người đã công bố bài viết về cách áp dụng CQRS cùng SOA vào năm 2008 và làm rõ khái niệm này vào cuối năm 2009. Bạn có thể đọc thêm tại trang Wikipedia về Command Query Responsibility Segregation.
Vì sao một mô hình truyền thống lại không ổn</
Hãy hình dung một API đơn giản lấy danh sách đơn hàng kèm thông tin khách hàng. Nếu mọi thứ nằm chung một lớp nghiệp vụ, chúng ta sẽ phải viết một phương thức khổng lồ chứa cả logic ghi lẫn logic đọc, kèm hàng loạt câu lệnh SQL phức tạp với các JOIN chồng chất. Khi cần tối ưu tốc độ đọc, chúng ta phải sửa đúng cái hàm mà cả nhóm đang dùng để ghi dữ liệu, dễ dẫn tới hồi quy.
Trong các hệ thống doanh nghiệp lớn, việc tích hợp các mối quan tâm xuyên suốt (cross-cutting concerns) như ghi log, chính sách retry, truyền tải audit vào cùng logic nghiệp vụ lại tạo ra sự gắn kết chặt (tight coupling), làm giảm tính mô đun và gây khó khăn cho việc phát triển dài hạn.
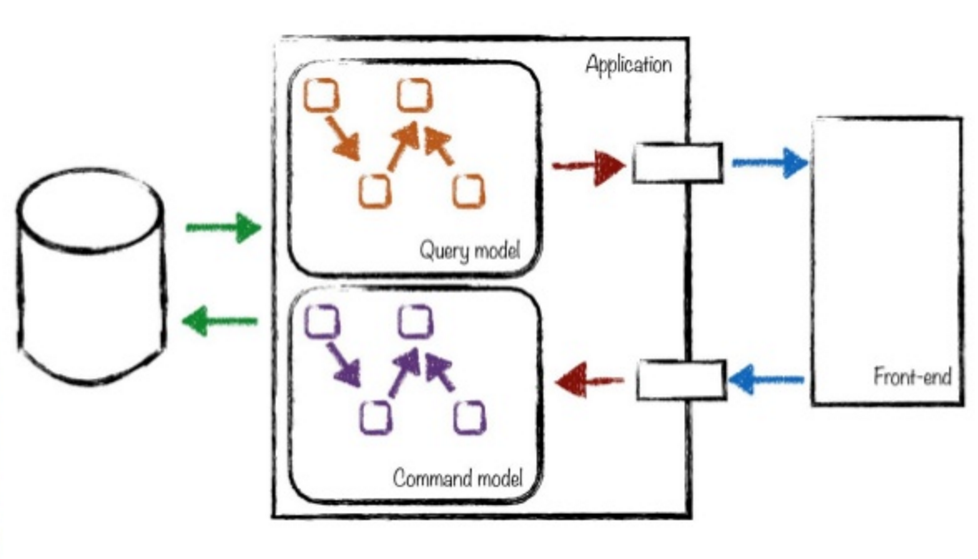
CQRS hoạt động như thế nào
Trong một pipeline CQRS điển hình, mỗi command sẽ đi qua một chuỗi xử lý được gọi là interceptor chain. Các bước có thể bao gồm định tuyến, chạy middleware, gọi handler và hậu xử lý. Cách tiếp cận này kế thừa từ các nguyên tắc thiết kế quen thuộc như Chain of Responsibility và Strategy pattern, kết hợp với lập trình khai báo.
Điểm mấu chốt nằm ở chỗ mô hình lệnh được xử lý như một quy trình chức năng thuần tuý, giúp tái sử dụng được các bước kiểm tra quyền, xác thực đầu vào, kiểm tra phiên bản tối ưu và ghi log. Kiến trúc này mang lại độ trễ dự đoán được, thông lượng cao, an toàn kiểu dữ liệu mạnh và tính lũy đảm (idempotency) đáng tin cậy — rất phù hợp với các ứng dụng phân tán quy mô lớn.
Write side và read side
Ở phía ghi (write side), dữ liệu được tối ưu để bảo đảm tính nhất quán: áp dụng ràng buộc, kiểm tra nghiệp vụ, giao dịch. Ngược lại, phía đọc (read side) có thể lưu dữ liệu ở dạng phi chuẩn hoá, denormalize, thậm chí sao chép ra nhiều bản sao phục vụ từng loại truy vấn khác nhau.
| Tiêu chí | Write model | Read model |
|---|---|---|
| Mục đích | Thay đổi trạng thái | Trả về dữ liệu |
| Ưu tiên | Tính nhất quán, toàn vẹn | Tốc độ đọc |
| Hình dạng dữ liệu | Chuẩn hoá cao | Denormalize, phục vụ view |
| Cập nhật | Đồng bộ tức thì | Có thể trễ (eventual) |
Lợi ích và điểm yếu
Ưu điểm lớn nhất của CQRS là khả năng mở rộng độc lập: bạn có thể nhân bản riêng phần đọc khi lưu lượng truy vấn tăng vọt mà không ảnh hưởng tới phần ghi, và ngược lại. Bên cạnh đó, mô hình này tạo ra audit trail tự nhiên, code dễ đọc hơn nhờ mô hình tách biệt rõ ràng, đồng thời thuận tiện cho việc kiểm thử.
Tuy nhiên, đây không phải công cáp dành cho mọi dự án. Những hệ thống nhỏ, yêu cầu đơn giản sẽ không đáng trả thêm độ phức tạp của việc vận hành hai mô hình dữ liệu riêng biệt. Rủi ro lớn nhất là tính nhất quán cuối cùng: khi dùng Event Sourcing, read model có thể bị trễ vài giây so với write model, khiến người dùng vừa đặt hàng lại chưa thấy trong danh sách. Ngoài ra, debug trở nên khó khăn hơn vì luồng dữ liệu phân tán qua nhiều thành phần.
Khi nào nên dùng CQRS
CQRS phát huy tác dụng khi hệ thống có mô hình đọc và ghi khác biệt rõ rệt, có tải đọc lớn hơn nhiều lần tải ghi, hoặc nghiệp vụ phức tạp đòi hỏi kiểm soát chặt chẽ. Nếu ứng dụng của bạn chỉ có vài bảng dữ liệu đơn giản, mô hình CRUD truyền thống vẫn là lựa chọn hợp lý và ít rủi ro hơn nhiều.
Tóm lại, CQRS là công cụ mạnh để tách biệt trách nhiệm đọc và ghi, mang lại khả năng mở rộng và khả năng kiểm toán vượt trội khi áp dụng đúng. Điều quan trọng nhất là đánh giá kỹ độ phức tạp thực tế trước khi triển khai, bởi mẫu thiết kế này sẽ trở thành gánh nặng nếu hệ thống không đủ lớn để cần đến nó.