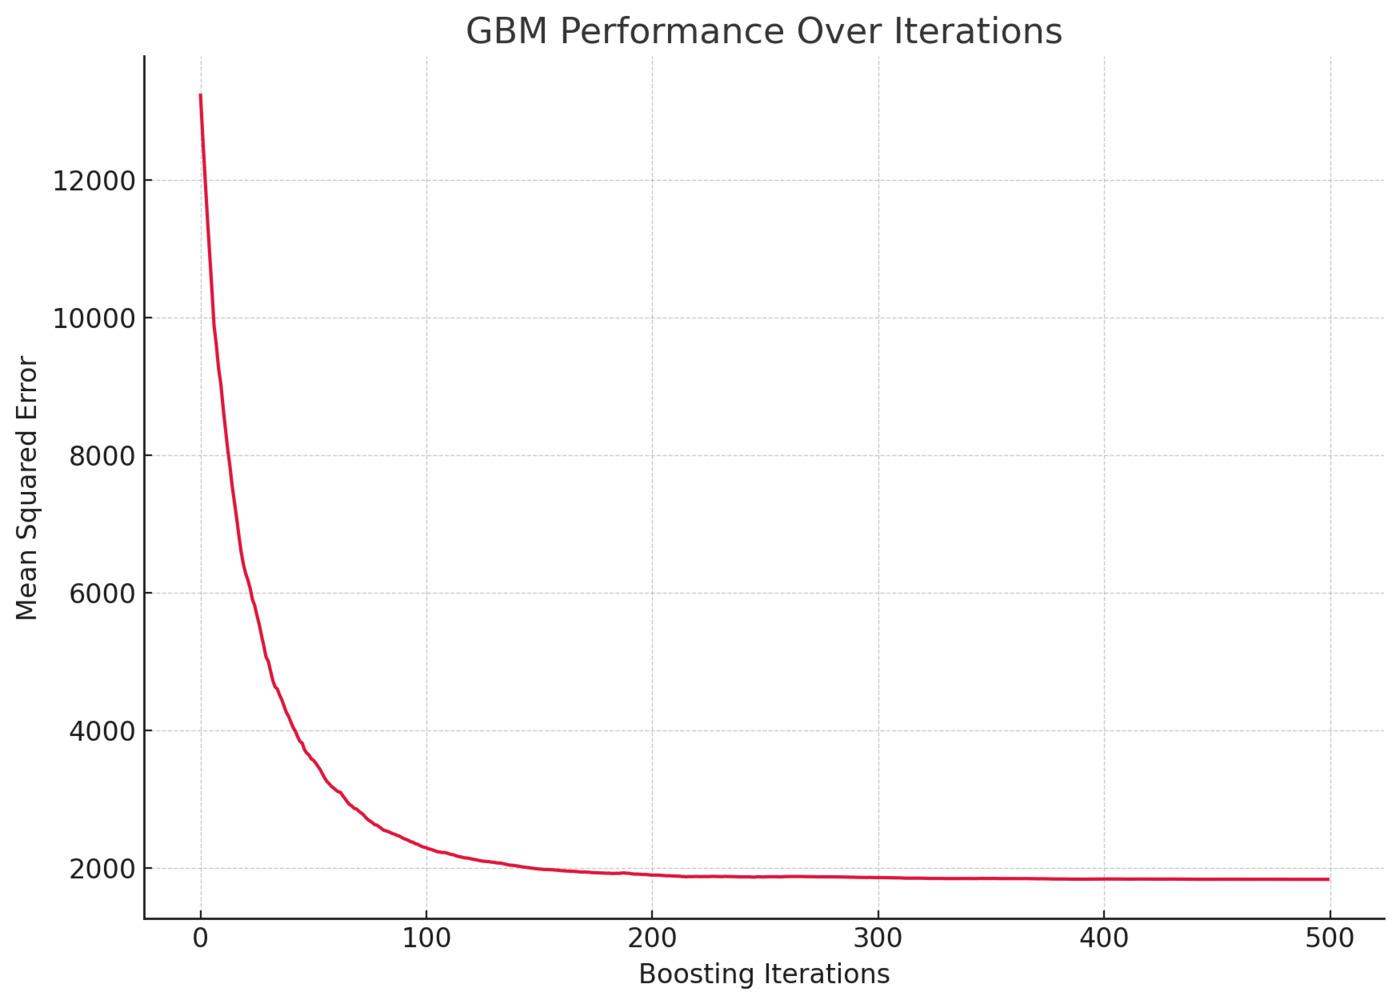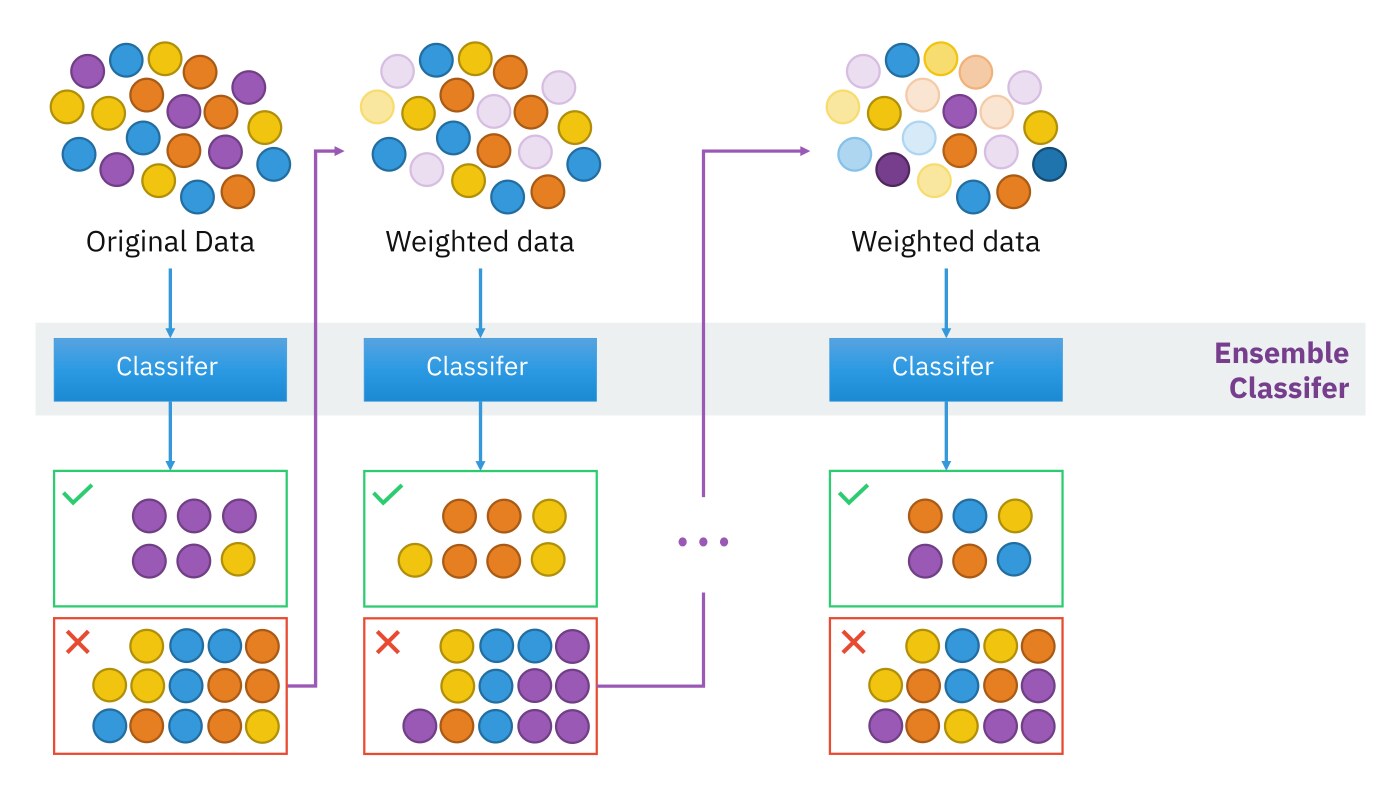
Gradient Boosting (GBM) là một trong những thuật toán học máy phổ biến nhất để giải quyết bài toán dự báo trên dữ liệu có cấu trúc (tabular data). Thuật toán hoạt động dựa trên nguyên lý boosting: xây dựng mô hình theo thứ tự, mỗi mô hình mới học hỏi để sửa những sai sót còn lại của các mô hình trước đó. Kết quả là một mô hình tổng hợp rất mạnh, thường chiếm ưu thế trên dữ liệu bảng.
Gradient Boosting hoạt động như thế nào
Thay vì huấn luyện một cây quyết định duy nhất trên dữ liệu gốc, Gradient Boosting khởi tạo bằng một mô hình cực kỳ đơn giản (thường là một hằng số), rồi mỗi vòng lặp thêm vào một mô hình phụ yếu (weak learner) được huấn luyện trên phần sai sót còn lại của mô hình hiện tại. Công thức dự đoán cuối cùng là tổng của tất cả các mô hình phụ:
y_hat(i) = F_M(x_i) = sum h_m(x_i) voi m = 1 den M
Trong đó M chính là số vòng lặp (n_estimators), còn mỗi h_m là một cây quyết định có độ sâu giới hạn bởi max_depth. Vì mỗi cây mới chỉ học phần còn lại, mô hình tập trung được vào những mẫu dữ liệu khó dự đoán, từ đó hạ đồng thời cả sai lệch (bias) và phương sai (variance). Cách tổng hợp theo thứ tự này được scikit-learn mô tả chi tiết trong phần ensemble learning.
Bộ siêu tham số quan trọng
Các thư viện hiện đại như scikit-learn, XGBoost, LightGBM và CatBoost dùng chung một nhóm siêu tham số nền tảng, chỉ khác nhau ở tên gọi và phạm vi giá trị cho phép. Bảng dưới đây tổng hợp giá trị mặc định theo tài liệu chính thức của từng thư viện.
| Tham số | Ý nghĩa | Mặc định đáng chú ý |
|---|---|---|
learning_rate (XGBoost gọi là eta) |
Quy mô đóng góp của mỗi cây mới vào tổng dự đoán | scikit-learn 0.1, XGBoost 0.3, LightGBM 0.1 |
n_estimators |
Số cây được thêm vào | 100 ở cả bốn thư viện |
max_depth |
Độ sâu tối đa mỗi cây | scikit-learn 3, XGBoost 6, LightGBM không giới hạn |
subsample |
Tỷ lệ mẫu dữ liệu cho mỗi cây | 1.0 (dùng toàn bộ dữ liệu) |
colsample_bytree |
Tỷ lệ đặc trưng được xét khi tách nút | 1.0, XGBoost cho phép khoảng (0, 1] |
min_data_in_leaf |
Số mẫu tối thiểu trong một lá | LightGBM 20 |
Giá trị learning_rate nhỏ buộc mô hình phải dùng nhiều cây hơn để hội tụ, đổi lại thường cho độ chính xác cao hơn và ít overfit hơn. Ngược lại, max_depth quá lớn khiến từng cây dễ ghi nhớ dữ liệu nhiễu. Tham số đầy đủ của XGBoost nằm trong tài liệu tham số chính thức, còn bộ mặc định của scikit-learn nằm ở trang GradientBoostingRegressor.
Boosting khác bagging ở chỗ nào
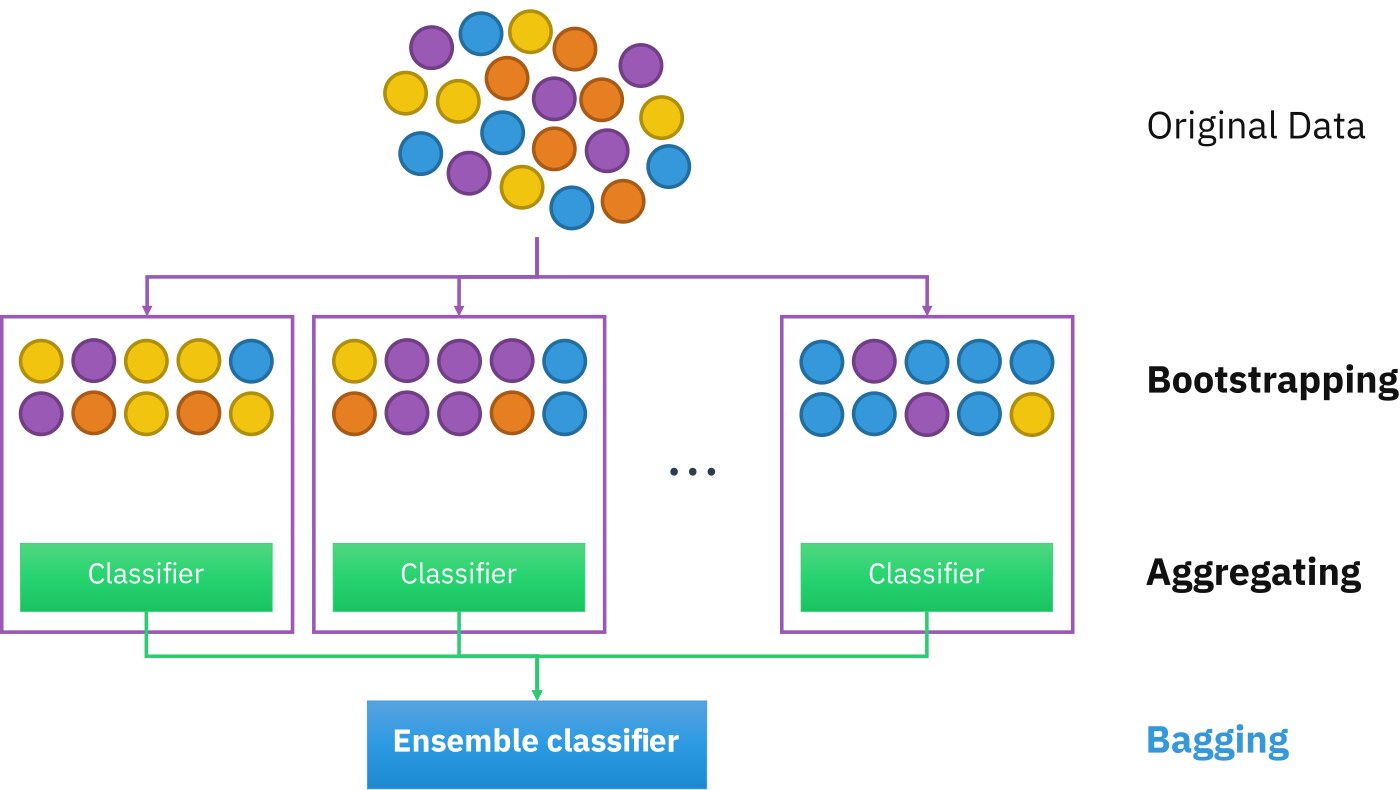
Random Forest cũng dùng nhiều cây quyết định, nhưng triết lý hoàn toàn đối lập với Gradient Boosting. Việc so sánh này quyết định việc bạn chọn thuật toán nào cho bài toán của mình.
- Random Forest (bagging): mỗi cây được xây trên một mẫu bootstrap độc lập và có thể phát triển tới độ sâu tối đa, sau đó lấy trung bình hoặc đa số phiếu. Các cây không biết gì về nhau nên rất nhanh khi huấn luyện song song và ít khi overfit.
- Gradient Boosting (boosting): các cây được xây tuần tự, cây sau nhận đầu vào là sai số của tổng các cây trước. Nhờ vậy mô hình biểu diễn được hàm phức tạp hơn với cùng số cây, đổi lại là dễ overfit nếu không kiểm soát
learning_ratevà số vòng lặp.
Quy tắc thực hành: dữ liệu sạch, cần độ chính xác cao nhất thì chọn Gradient Boosting; dữ liệu nhiều nhiễu, cần mô hình ổn định và ít tinh chỉnh thì Random Forest vẫn là lựa chọn an toàn.
XGBoost, LightGBM, CatBoost khác nhau ra sao
Ba thư viện nổi bật nhất đều dựa trên Gradient Boosting nhưng có những cải tiến riêng đáng chú ý:
- XGBoost: dùng thuật toán tìm điểm tách nhận biết giá trị thiếu và một sketch định lượng trọng số, cho phép huấn luyện ngoài lõi (out-of-core) trên tập dữ liệu hàng tỷ dòng. Trong bài báo gốc, XGBoost nhanh hơn khoảng 10 lần so với bản Gradient Boosting của scikit-learn trên tập Higgs-1M với độ chính xác gần như tương đương (AUC 0.8304 so với 0.8302). Chi tiết tốc độ nằm trong bài báo XGBoost trên arXiv.
- LightGBM: kết hợp GOSS (Gradient-based One-Side Sampling) và EFB (Exclusive Feature Bundling) để không phải xét toàn bộ dữ liệu ở mỗi nhánh, nhờ đó tăng tốc huấn luyện hơn 20 lần so với GBDT truyền thống với độ chính xác gần như không đổi, theo bài báo LightGBM tại NeurIPS.
- CatBoost: xử lý trực tiếp đặc trưng dạng danh mục bằng ordered boosting, tránh rò rỉ thông tin mục tiêu. Đổi lại chế độ ordered chậm hơn khoảng 1.7 lần so với chế độ thường trên tập dữ liệu nhỏ, như lưu ý trong bài báo CatBoost.
Tham số mặc định đầy đủ của LightGBM được liệt kê tại trang Parameters, còn nguyên lý dựng cây tuần tự của CatBoost nằm ở tài liệu thuật toán.
Ứng dụng thực tế và lưu ý khi dùng
Gradient Boosting là lựa chọn mặc định trong nhiều ngành công nghiệp nhờ tốc độ học nhanh và độ chính xác cao trên dữ liệu có cấu trúc:
- Ngân hàng: chấm điểm tín dụng, phát hiện gian lận giao dịch.
- Thương mại điện tử: dự đoán tỷ lệ nhấp (CTR), gợi ý sản phẩm.
- Y tế: phân loại bệnh dựa trên chỉ số xét nghiệm và ảnh y khoa.
- Sản xuất: dự báo thời gian hỏng thiết bị, tối ưu chuỗi cung ứng.
- Quảng cáo trực tuyến: ước lượng giá thầu và tỷ lệ chuyển đổi.
Hai điểm cần nhớ khi triển khai. Thứ nhất, vì mỗi cây phụ thuộc kết quả cây trước, thuật toán này khó song song hóa trên một máy đơn, nên tăng tốc chủ yếu đến từ thư viện và phần cứng hơn là từ thuật toán. Thứ hai, mô hình dễ học thói quen của dữ liệu huấn luyện, nên luôn dùng early stopping và kiểm tra trên tập validation để tránh overfit. Nếu dữ liệu quy mô rất lớn và cần tốc độ dự đoán cao, hãy cân nhắc LightGBM; nếu có nhiều cột dạng danh mục, CatBoost tiết kiệm thời gian chuẩn bị dữ liệu đáng kể.