Huffman coding là gì? Thuật toán nén dữ liệu theo tần suất ký tự
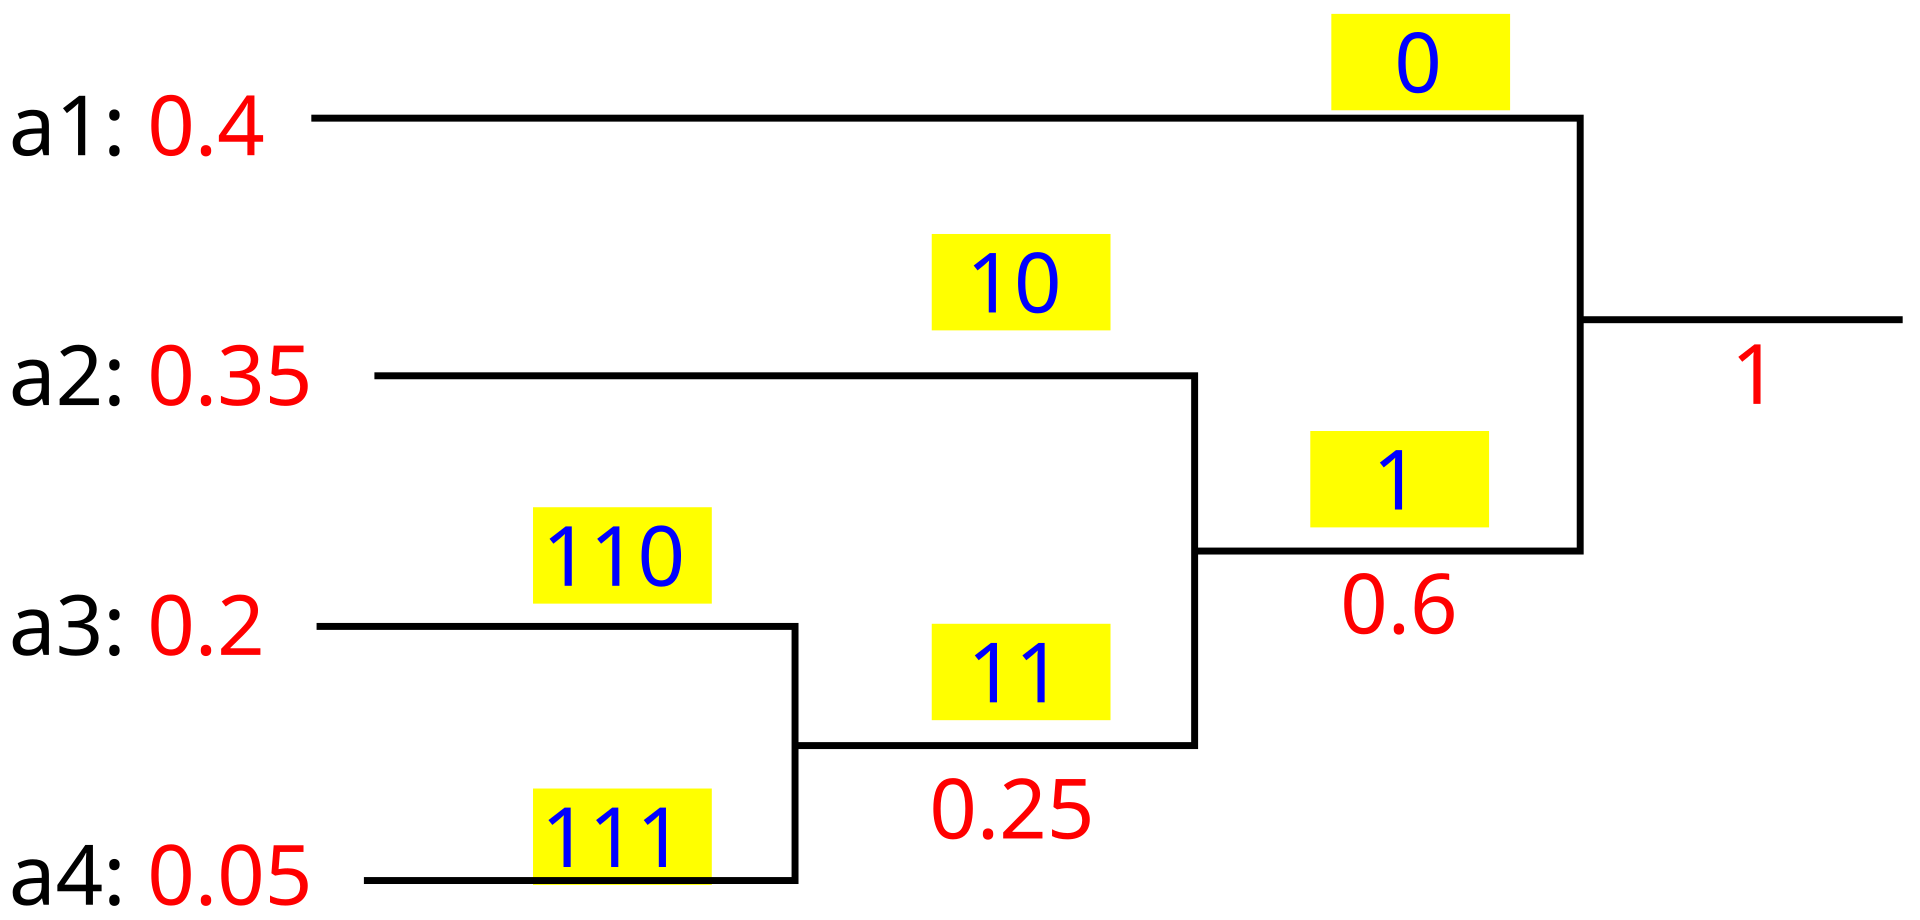
Nguyên lý cốt lõi
Trước Huffman coding, cách mã hoá cố định được dùng: mỗi ký tự luôn chiếm cùng số bit, ví dụ 8 bit cho ASCII. Cách này lãng phí rõ ràng khi văn bản tiếng Việt hay văn bản HTML chứa một ký tự lặp đi lặp lại hàng nghìn lần cùng với những ký tự chỉ xuất hiện đúng một lần.
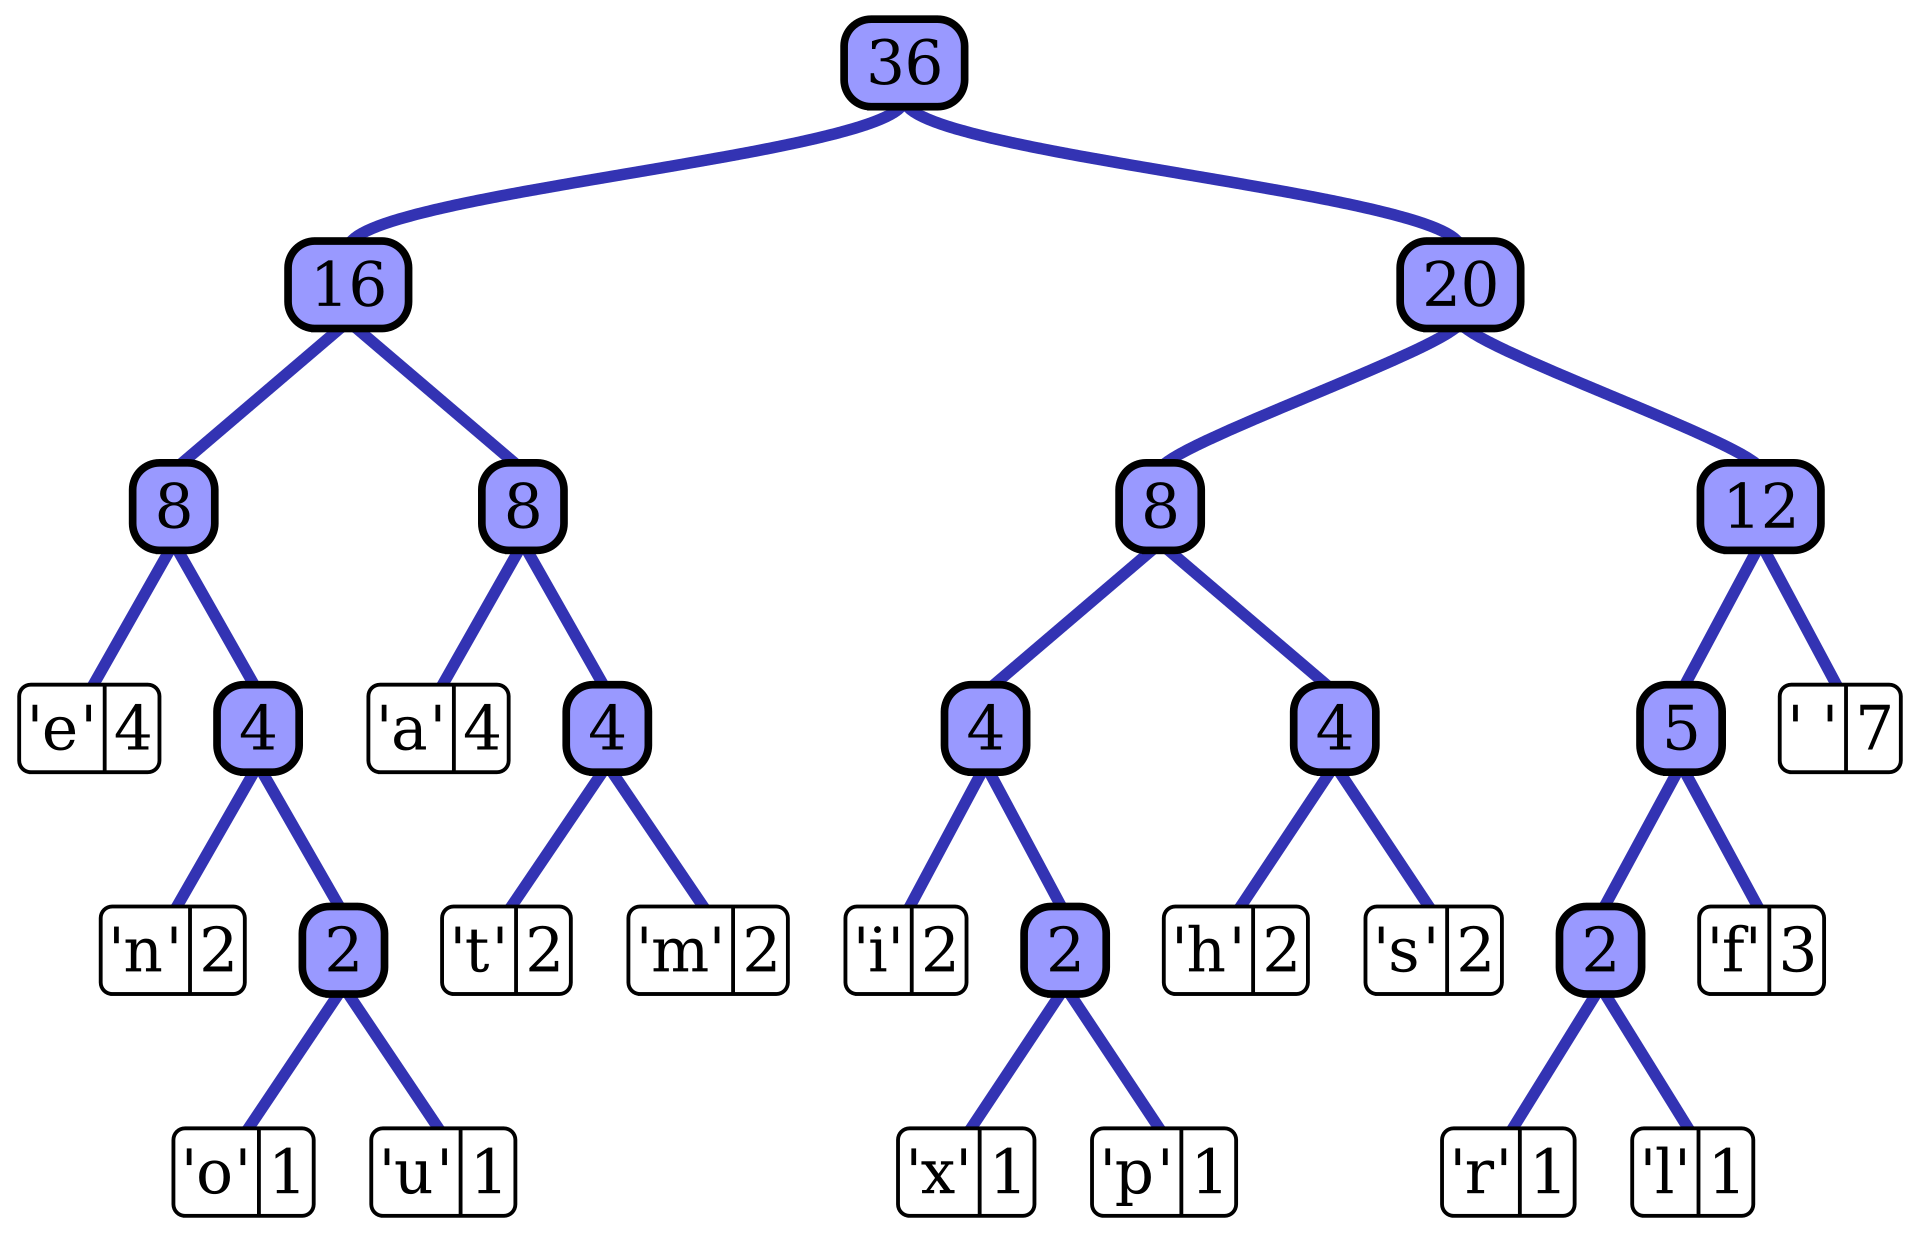
Các bước dựng cây Huffman
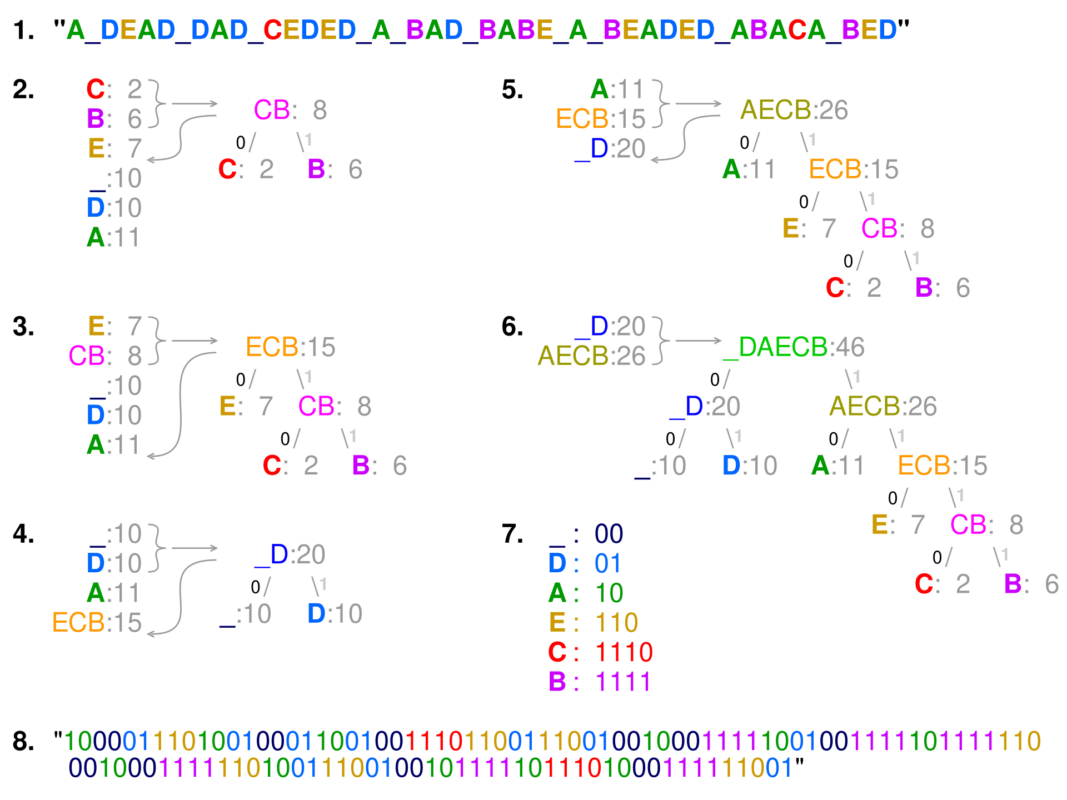
Cây Huffman là một cây nhị phân đầy đủ, trong đó mỗi lá là một ký tự và trọng số của lá bằng tần suất xuất hiện. Thuật toán dựng cây theo thuật toán tham lam (greedy), chỉ bốn bước lặp:
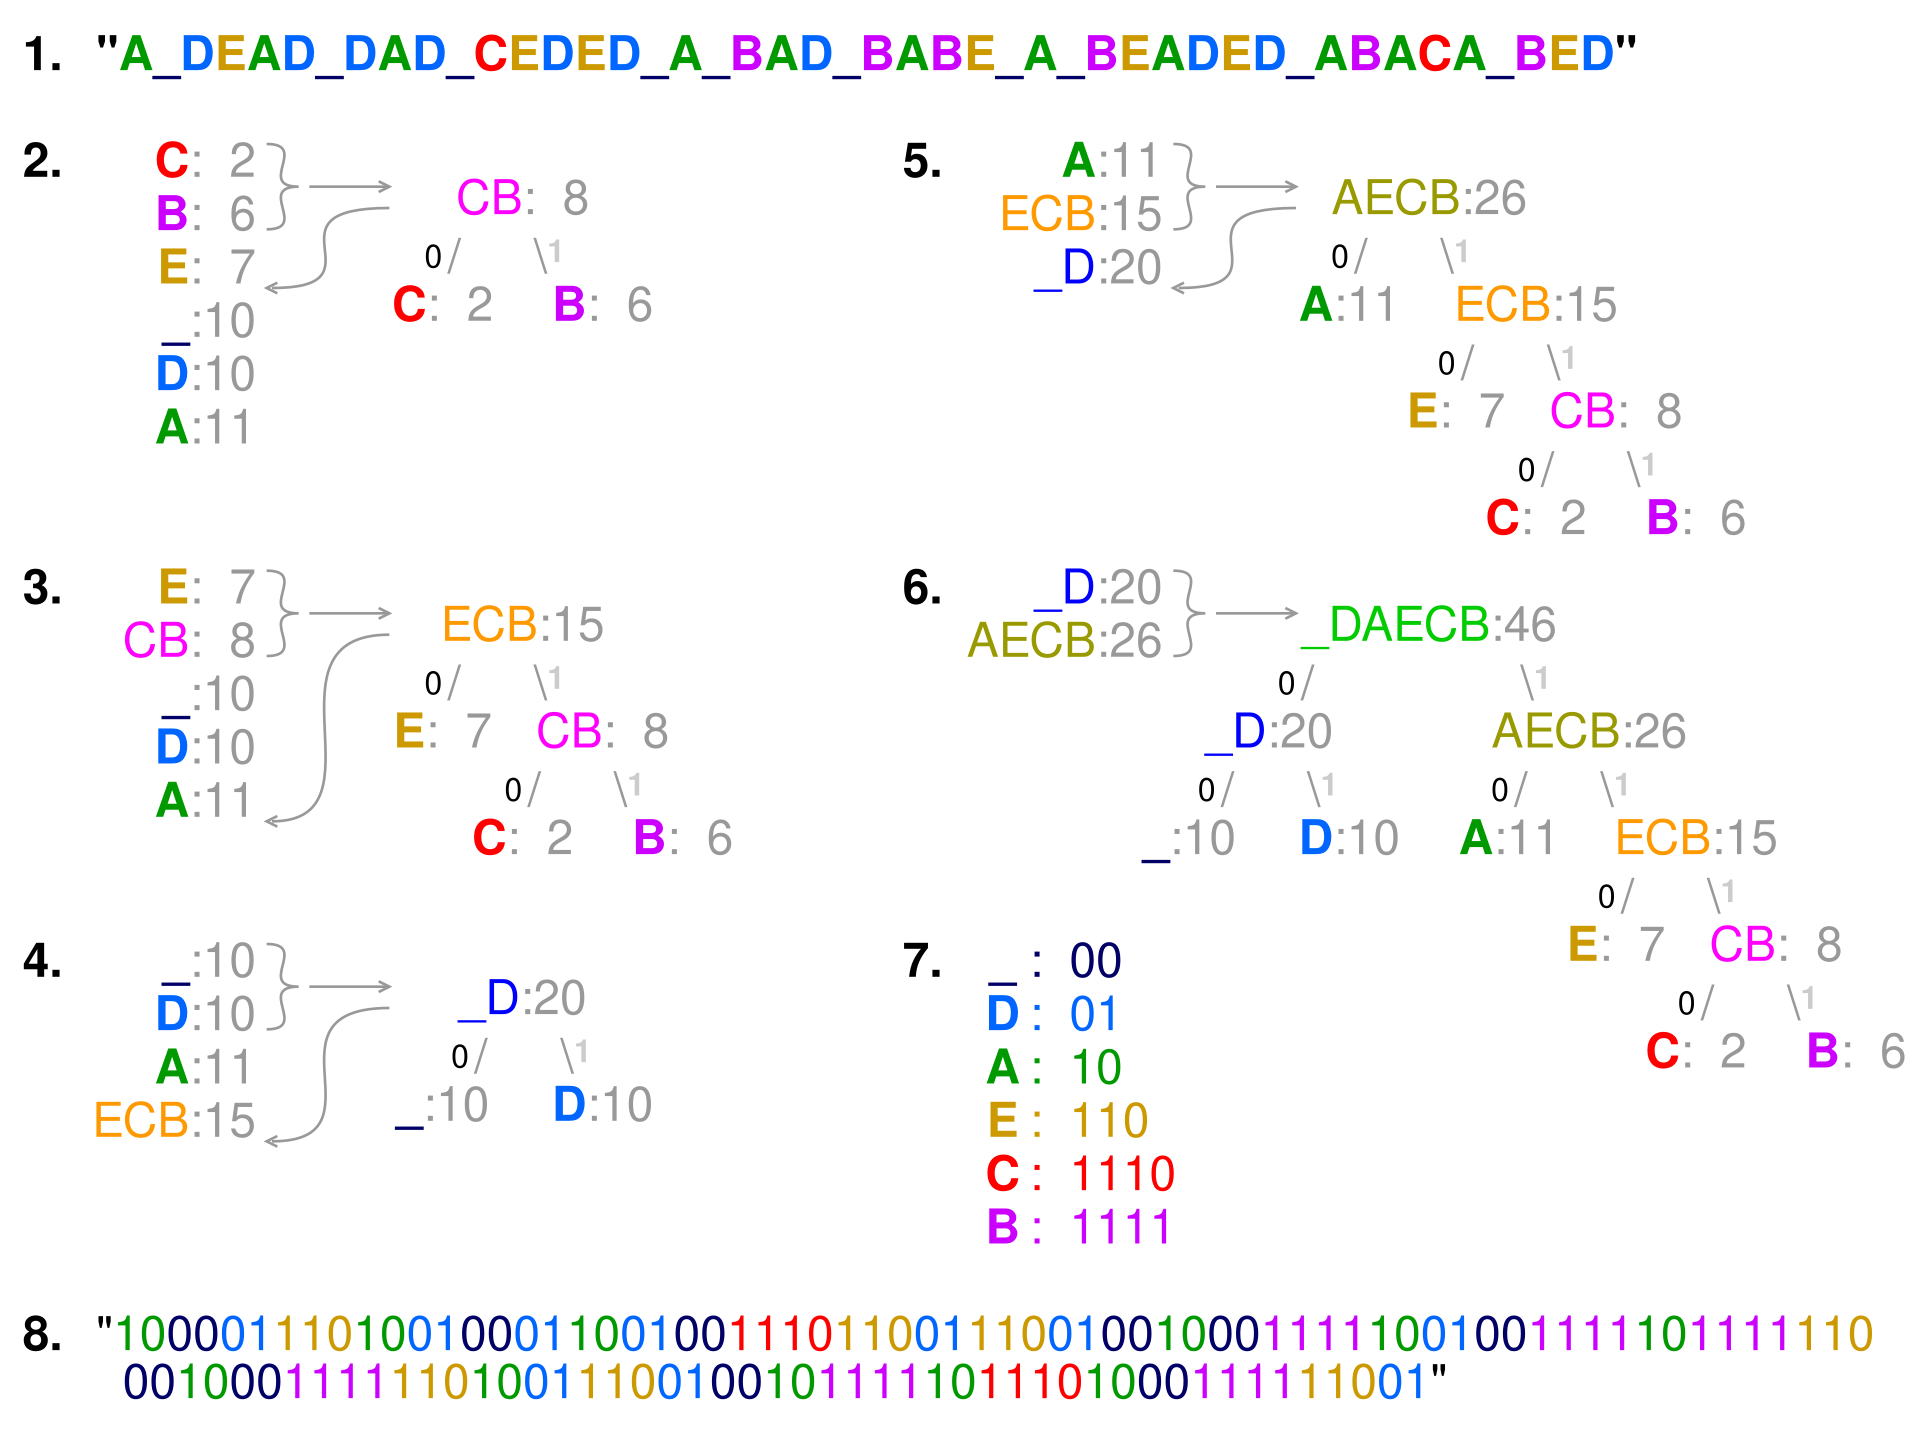
- Khởi tạo: tạo một nút lá cho mỗi ký tự, gán trọng số bằng tần suất xuất hiện của ký tự đó trong dữ liệu.
- Chọn hai nút nhẹ nhất: lấy hai nút có trọng số nhỏ nhất đang nằm trong hàng đợi ưu tiên (min-heap).
- Gộp: tạo một nút cha mới, đặt hai nút vừa chọn làm hai lá của nó, trọng số của cha bằng tổng hai trọng số con. Đưa nút cha trở lại hàng đợi.
- Lặp lại cho tới khi hàng đợi chỉ còn đúng một nút. Nút đó là gốc cây, và nó chính là nút gốc.
Xét chuỗi mẫu kinh điển beep boop beer! gồm 16 ký tự. Đếm tần suất ta có: e xuất hiện 6 lần, b 4 lần, khoảng trắng 3 lần, o 2 lần, p 2 lần, và các ký tự r, ! mỗi ký tự 1 lần. Tổng cộng lại đúng 16 lá.
Dựng cây theo quy trình trên, ký tự e đứng sâu nhất nên mã của nó chỉ dài 1 bit (0), còn các ký tự hiếm như ! nằm gần gốc nên mã dài 6 bit. Khi nối lại toàn bộ, chuỗi gốc 16 ký tự với 16 byte dữ liệu được rút xuống còn khoảng 40 bit, tức giảm hơn một nửa.
Huffman coding kết hợp với mã hoá tiền tố
Điểm yếu cố hữu của Huffman coding là nó tạo ra một bảng mã riêng cho từng tập dữ liệu. Nếu tần suất phân bố kém, hiệu quả nén suy giảm rõ rệt; với dữ liệu đã nén sẵn, thuật toán thậm chí còn làm file lớn thêm. Vì vậy, các định dạng nén hiện đại không dùng Huffman độc lập mà ghép nó với mã hoá chuỗi (run-length) và mã hoá theo thứ tự xuất hiện.
| Định dạng | Cách dùng Huffman | Phạm vi áp dụng |
|---|---|---|
| ZIP / DEFLATE | Huffman cho ký tự chữ và ký tự khác nhau, cùng bảng chuỗi khoảng trắng | Tệp nén tổng quát |
| GZIP | DEFLATE kết hợp LZ77 | Tệp nén Unix |
| PNG | Huffman cho dữ liệu pixel đã lọc | Ảnh PNG |
| JPEG | Huffman cho hệ số lượng tử hoá từng khối 8×8 | Ảnh JPEG |
| MP3 / AAC | Huffman cho dữ liệu âm thanh đã nén theo băng tần số | Âm thanh số |
Ưu điểm và hạn chế
Ưu điểm:
- Đơn giản, dễ cài đặt, thời gian nén và giải nén đều là O(n log n).
- Không cần bảng tra cứu phức tạp: cây nhị phân biểu diễn gọn gàng bảng mã.
- Phù hợp với dữ liệu văn bản, mã nguồn, log, dữ liệu phân phối không đều.
Hạn chế:
- Không nén được dữ liệu phân phối đều, tỷ lệ nén gần bằng không.
- Là thuật toán một lớp, mỗi tập dữ liệu cần một cây riêng, bảng mã phải lưu kèm tệp nén.
- Không phù hợp với dữ liệu đã chuẩn hoá, ví dụ video hoặc ảnh JPEG đã nén.
Khi nào nên dùng Huffman coding
Nếu bạn đang xây dựng một hệ thống lưu trữ hoặc truyền dữ liệu văn bản, hãy dùng sẵn zlib hay gzip thay vì tự hiện thực. Ngược lại, khi cần thuật toán tối ưu cho một bộ ký tự cố định, ví dụ nén ký tự trong file log, hay khi thiết kế giao thức truyền dữ liệu trên mạng với băng thông hạn chế, Huffman coding là lựa chọn chuẩn và rẻ tiền nhất.
Tham khảo thêm: Huffman coding trên Wikipedia, và bảng đặc tả gói tin trong đặc tả DEFLATE (RFC 1951) giải thích cách Huffman được dùng trong ZIP.