Hướng dẫn tối ưu hiệu suất Python với NumPy và Pandas
Trong thời đại dữ liệu lớn, Python cùng với NumPy và Pandas là bộ công cụ không thể thiếu cho khoa học dữ liệu và học máy. Tuy nhiên, việc xử lý hiệu quả tập dữ liệu lớn đòi hỏi hiểu sâu về cách tối ưu hóa mã. Bài viết này sẽ hướng dẫn bạn các kỹ thuật tối ưu hiệu suất thực tế để làm cho code Python của bạn chạy nhanh hơn đáng kể.
1. Tiểu biểu vector hóa với NumPy
Một trong những nguyên tắc cơ bản khi làm việc với NumPy là vectorization – thay vì sử dụng vòng lặp Python chậm, chúng ta thực hiện các phép toán trên toàn bộ mảng cùng một lúc.
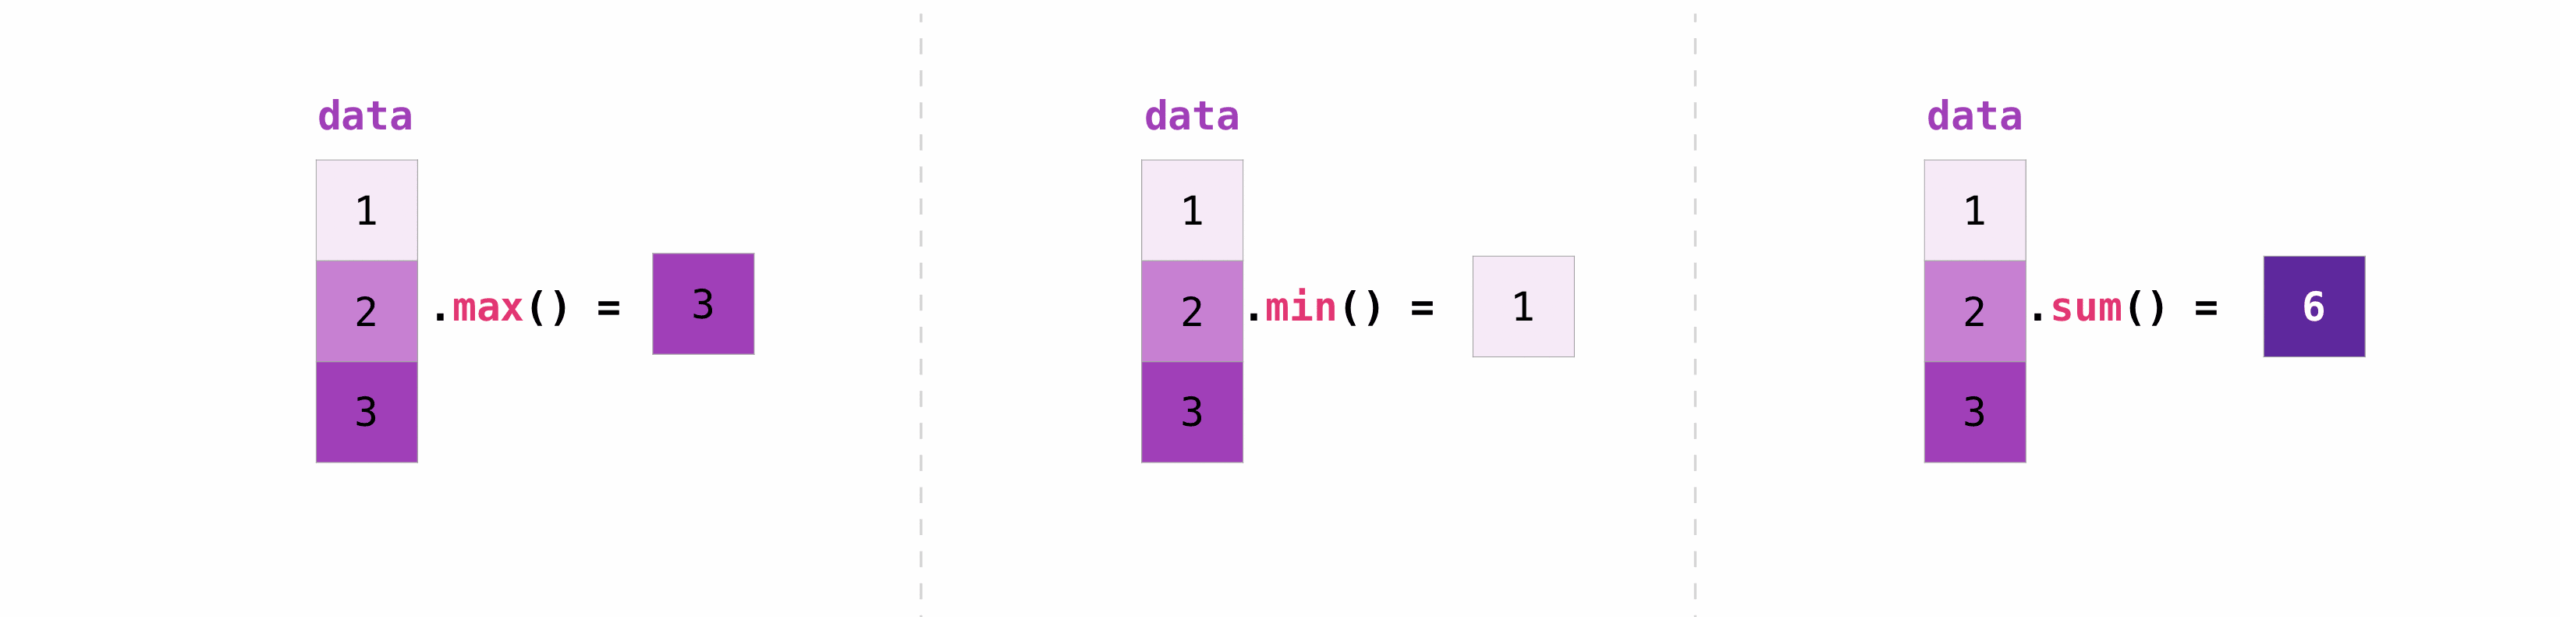
Ví dụ thay vì:
# Chậm - vòng lặp Python
result = []
for i in range(len(array)):
    result.append(array[i] * 2)
Chúng ta nên viết:
# Nhanh - vectorization với NumPy
result = array * 2
Vectorization wykorzysta các instruction SIMD của CPU và được thực hiện trong mã C, dẫn đến tăng hiệu suất 10-100x so với vòng lặp Python thuần túy.
2. Sử dụng dtype thích hợp
Chọn dtype (kiểu dữ liệu) phù hợp không chỉ tiết kiệm bộ nhớ mà còn cải thiện hiệu suất vì CPU có thể xử lý nhiều dữ liệu hơn trong mỗi cache line.
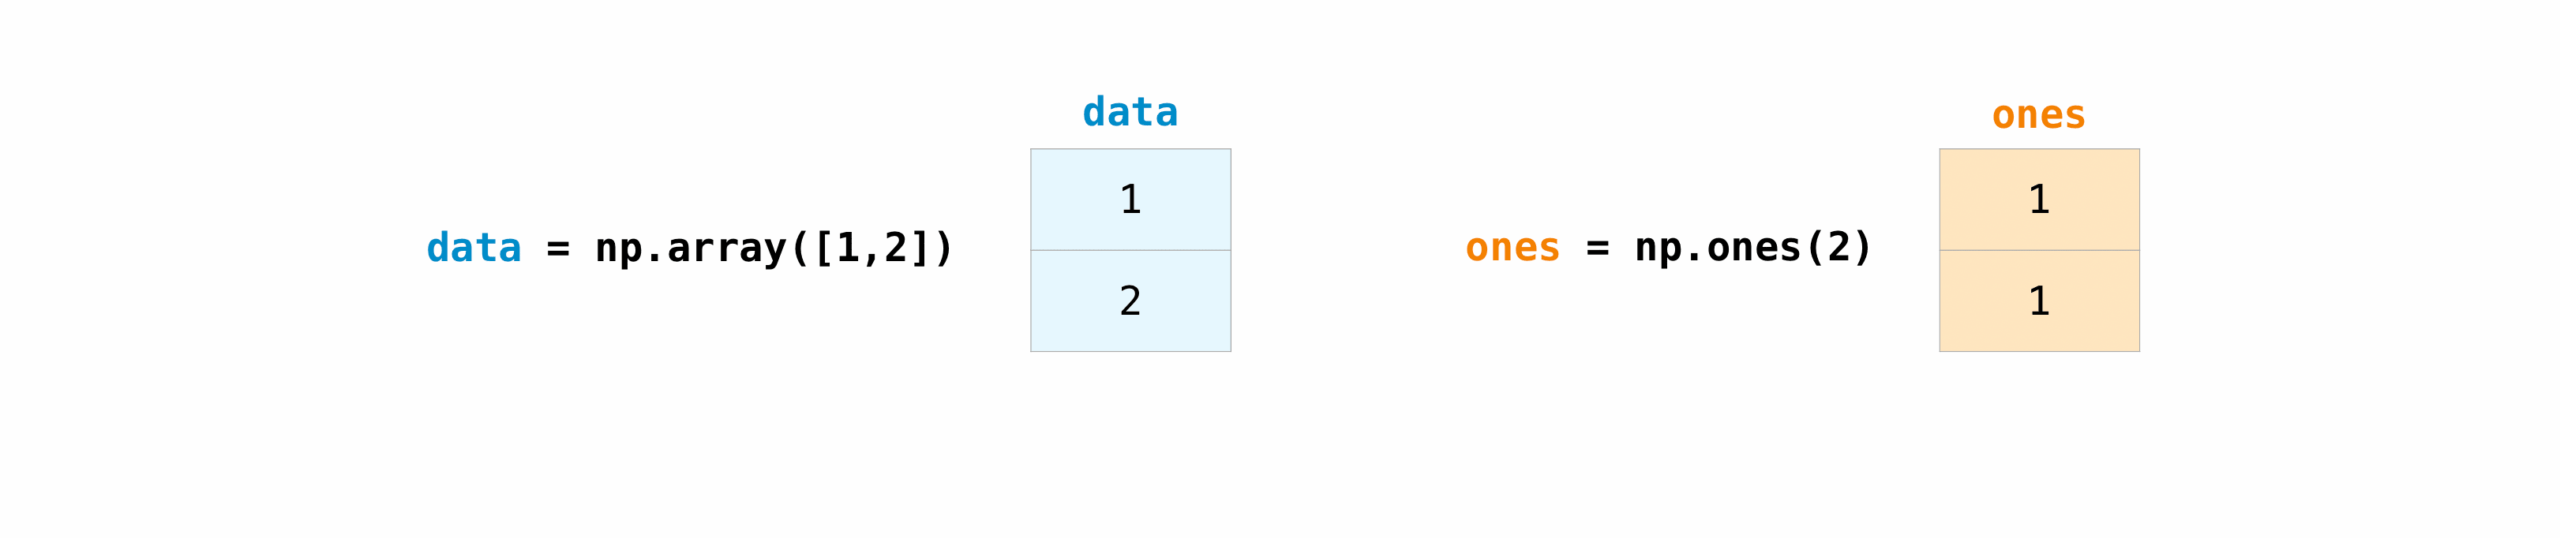
Ví dụ:
# H lãng - sử dụng dtype mặc định (int64, float64)
import numpy as np
arr = np.array([1, 2, 3, 4, 5])  # int64 - 8 bytes per element

# Tối ưu - sử dụng dtype phù hợp với phạm vi giá trị
arr_opt = np.array([1, 2, 3, 4, 5], dtype=np.int32)  # int32 - 4 bytes per element
arr_float = np.array([1.0, 2.0, 3.0], dtype=np.float32)  # float32 - 4 bytes per element
Khi làm việc với mảng có triệu phần tử, việc giảm dung lượng bộ nhớ từ 8 bytes xuống 4 bytes mỗi phần tử có thể tiết kiệm hàng trăm MB và cải thiện hiệu suất cache đáng kể.
3. Tránh sao chép dữ liệu không cần thiết trong Pandas
Một lỗi phổ biến khi sử dụng Pandas là tạo ra nhiều bản sao (copy) của DataFrame không cần thiết, dẫn đến lãng phí bộ nhớ và giảm hiệu suất.
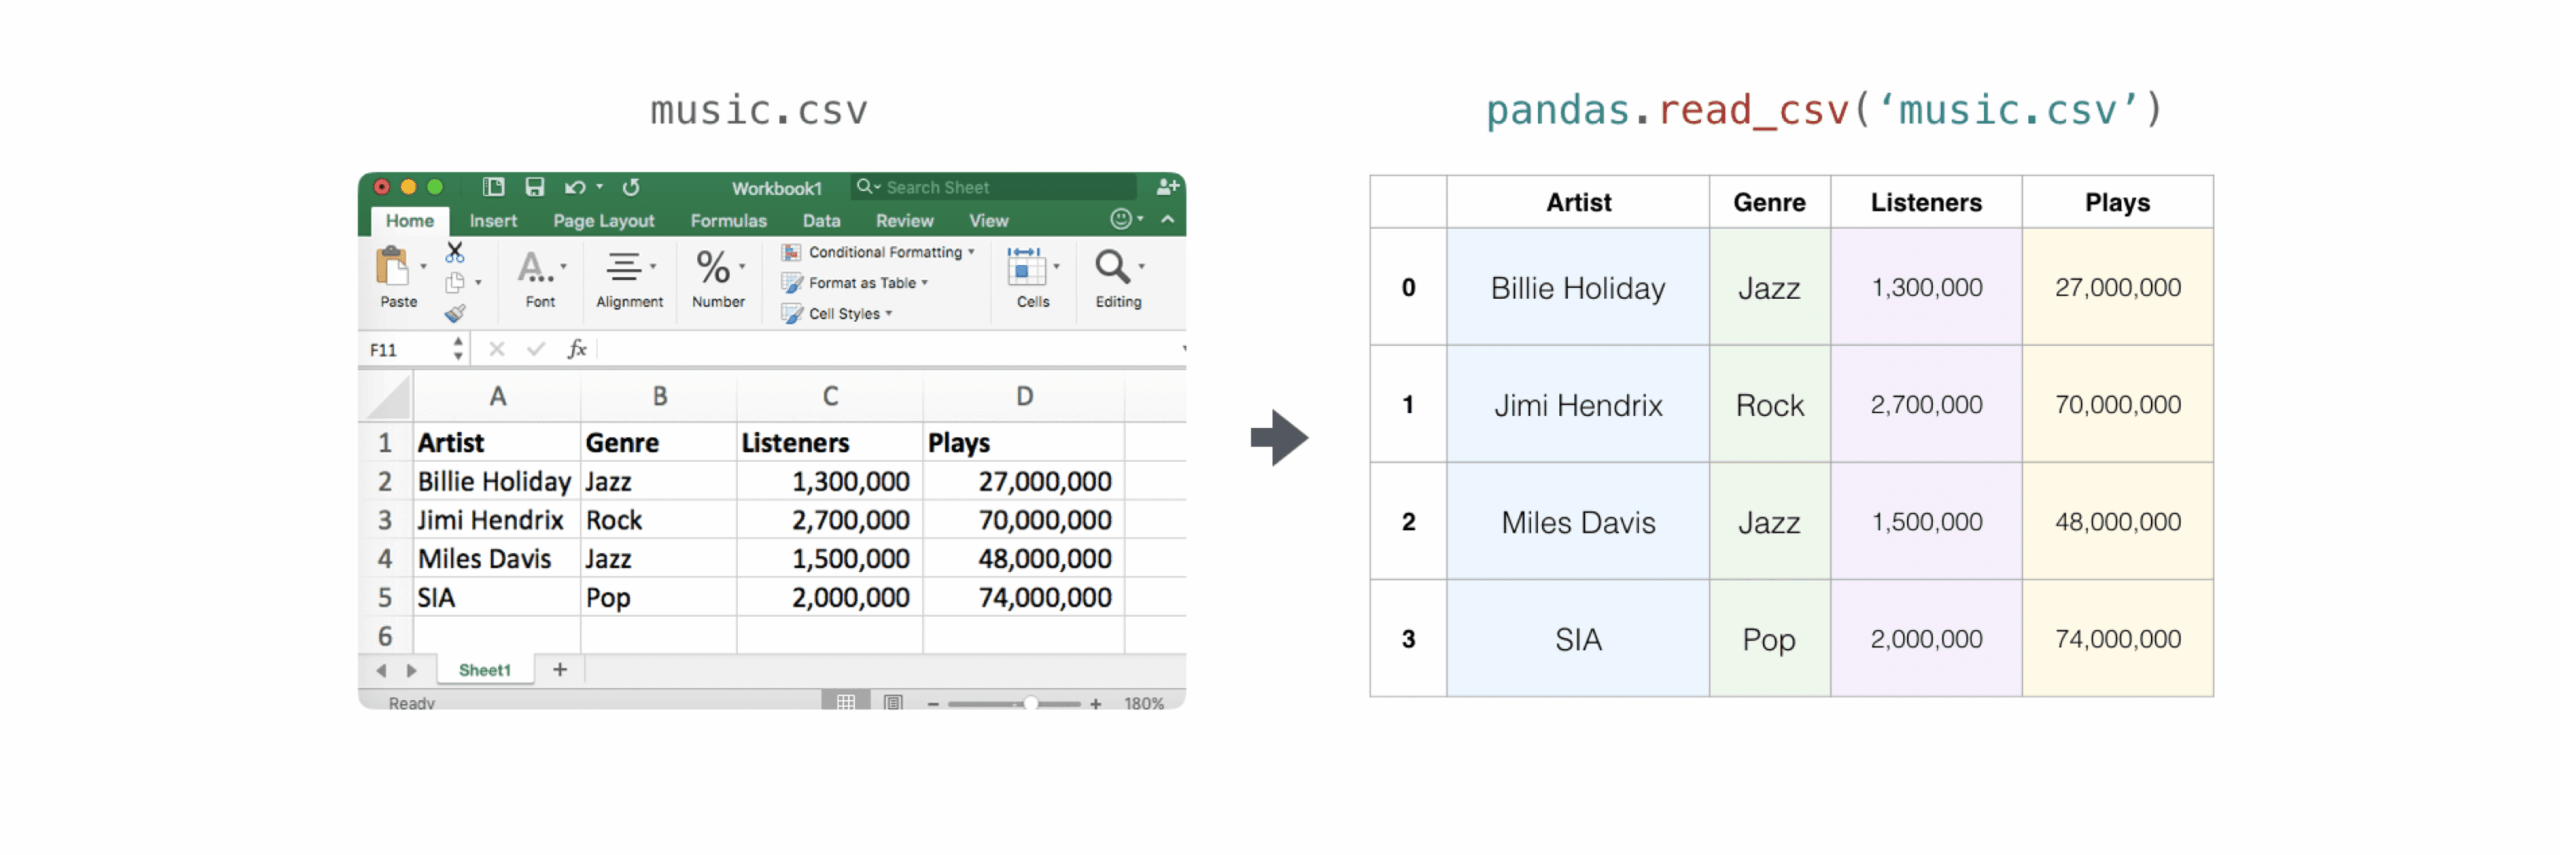
Thay vì:
# Tạo nhiều bản sao không cần thiết
df_filtered = df[df['column'] > 0]  # Tạo bản sao
df_filtered['new_col'] = df_filtered['column'] * 2  # Thao tác trên bản sao
result = df_filtered.groupby('category').sum()  # Tạo bản sao khác
Chúng ta nên sử dụng các phương pháp:
# Tối ưu - giảm lượng sao chép
df_filtered = df[df['column'] > 0].copy()  # Rõ ràng khi cần bản sao
df_filtered = df_filtered.assign(new_col=lambda x: x['column'] * 2)
result = df_filtered.groupby('category', as_index=False).sum()
Sử dụng .copy() chỉ khi thực sự cần thiết và .assign() để tạo các cột mới mà không thay đổi DataFrame gốc.
4. Sử dụng categorical data trong Pandas
Các cột chứa dữ liệu lặp lại nhiều lần (như categorical variables) nên được chuyển đổi thành categorical dtype để tiết kiệm bộ nhớ và tăng tốc các thao tác nhóm nhóm.
Ví dụ:
# Trước khi tối ưu - dtype object (string)
df['category'] = df['category'].astype('category')

# Sau khi chuyển đổi - categorical dtype
print(df['category'].dtype)  # category
# Kích thước bộ nhớ giảm đáng kể, đặc biệt khi có nhiều giá trị lặp lại
Chuyển đổi sang categorical có thể giảm uso bộ nhớ lên đến 80% và tăng tốc groupby operations 2-10x tùy thuộc vào cardinality của dữ liệu.
5. Sử dụng eval() và query() trong Pandas
Pandas cung cấp các hàm eval() và query() sử dụng numexpr backend để thực hiện các phép toán phức tạp nhanh hơn so với cú pháp Pandas truyền thống.
Thay vì:
# Cú pháp Pandas thường
result = df[(df['A'] > 10) & (df['B'] < 20)]
result['C'] = result['A'] + result['B']
Chúng ta có thể viết:
# Sử dụng query() và eval()
result = df.query('A > 10 and B < 20')
result = result.assign(C=eval('A + B'))  # hoặc trực tiếp: result.eval('C = A + B', inplace=True)
Các hàm này đặc biệt hiệu quả khi làm việc với các biểu thức phức tạp và DataFrame lớn, thường mang lại cải thiện hiệu suất 2-5x.
6. Tránh áp dụng hàm Python trên từng phần tử
Áp dụng hàm Python tùy chỉnh trên từng phần tử của Series hoặc DataFrame thường chậm vìthường chậm vì Python interpreter cho mỗi phần tử.
Thay vì:
# Chậm - áp dụng hàm trên từng phần tử
df['new_col'] = df['column'].apply(lambda x: x * 2 if x > 0 else x)
Chúng ta nên sử dụng các phương pháp vectorized của NumPy hoặc Pandas:
# Nhanh - sử dụng numpy.where (vectorized)
import numpy as np
df['new_col'] = np.where(df['column'] > 0, df['column'] * 2, df['column'])

# Hoặc sử dụng pandas vectorized operations
df['new_col'] = df['column'].where(df['column'] <= 0, df['column'] * 2)
Vectorized operations trong NumPy được biên dịch thành mã máy và có thể xử lý hàng triệu phần tử trong mili-giay.
7. Sử dụng chunksize để xử lý file lớn
Khi làm việc với file CSV hoặc JSON lớn không thể tải vào bộ nhớ hết, chúng ta nên sử dụng tham số chunksize để đọc và xử lý dữ liệu theo từng phần.
Ví dụ thay vì:
# Có thể gây ra lỗi bộ nhớ không đủ
df = pd.read_csv('large_file.csv')  # Tải toàn bộ file vào RAM
result = df.groupby('category').sum()
Chúng ta có thể viết:
# Xử lý theo chunks - tiết kiệm bộ nhớ
chunks = []
for chunk in pd.read_csv('large_file.csv', chunksize=10000):
    chunk_processed = chunk.groupby('category').sum()
    chunks.append(chunk_processed)
result = pd.concat(chunks).groupby('category').sum()
Phương pháp này cho phép xử lý file có kích thước hàng chục GB với mức sử dụng bộ nhớ dự đoán được.
8. Profiling và benchmarking
Trước khi tối ưu, chúng ta cần xác định accurately bottlenecks bằng cách sử dụng các công cụ profiling.
Một vài công cụ hữu ích:
- cProfile: Built-in Python profiler để xác định hàm nào tốn nhiều thời gian nhất
- line_profiler: Phân tích hiệu suất từng dòng código
- memory_profiler: Theo dõi sử dụng bộ nhớ theo thời gian
- Pandas built-in profiling:
df.profile_report()từ pandas-profiling
Ví dụ sử dụng cProfile:
import cProfile
import pstats
from io import StringIO

pr = cProfile.Profile()
pr.enable()
# Hàm cần profiling
process_large_dataset()
pr.disable()

s = StringIO()
ps = pstats.Stats(pr, stream=s).sort_stats('cumulative')
ps.print_stats()
print(s.getvalue())  # In ra báo cáo profiling
Nhờ profiling, chúng ta có thể tập trung tối ưu vào những nơi thực sự ảnh hưởng đến hiệu suất thay vì đoán mò.
Kết luận
Tối ưu hiệu suất Python với NumPy và Pandas không chỉ giúp code chạy nhanh hơn mà còn tiết kiệm tài nguyên và mở rộng khả năng xử lý dữ liệu lớn. Bằng cách áp dụng các kỹ thuật như vectorization, chọn dtype thích hợp, tránh sao chép không cần thiết, sử dụng categorical data, và tận dụng eval()/query(), bạn có thể cải thiện hiệu suất ứng dụng của mình từ 2-100x tùy thuộc vào trường hợp sử dụng cụ thể.
Hãy nhớ rằng premature optimization là gốc của nhiều vấn đề – luôn luôn profile trước khi tối ưu và tập trung vào những bottlenecks thực tế. Với những kiến thức trên, bạn đã sẵn sàng viết mã Python hiệu quả hơn cho các ứng dụng khoa học dữ liệu và học máy của mình.
Tài liệu tham khảo: