Kubernetes Pod Management là nghệ thuật điều phối container ở cấp nhỏ nhất — pod đơn lẻ, nhóm pod, và lifecycle handler. Hiểu đúng pod giúp engineer tối ưu resource, giảm cost cloud, và tăng độ tin cậy hệ thống. Hướng dẫn này phân tích pod lifecycle, management patterns, và best practices triển khai production.
Pod là gì: đơn vị triển khai nhỏ nhất trong Kubernetes
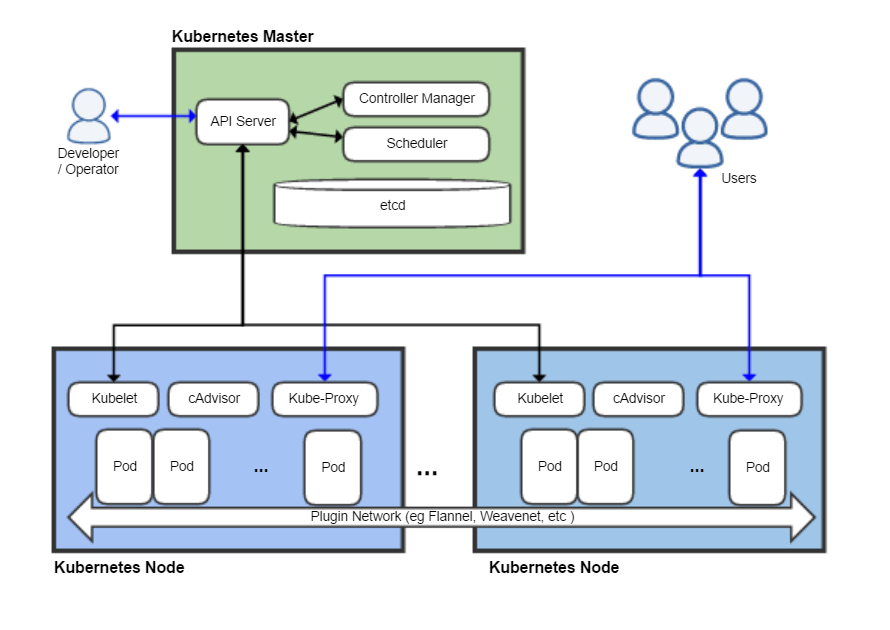
Pod wrapping một hoặc nhiều container chia sẻ namespace network, storage, và IPC. Container trong cùng pod cùng IP, có thể giao tiếp qua localhost. Pod là đơn vị quản lý nhỏ nhất Kubernetes không chia nhỏ hơn — nhưng pattern triển khai thực tế vượt xa “một pod = một container”.
Đặc điểm cốt lõi:
- Ephemeral: pod có vòng đời ngắn, restart policy quyết định hành vi khi lỗi.
- Shared context: volumes mount vào pod, tất cả container cùng truy cập.
- IP-per-pod: mỗi pod nhận IP riêng (dù tạm thời, trừ khi dùng HostNetwork).
- No self-healing ở cấp pod: ReplicaSet/Deployment mới đảm bảo số bản sao mong muốn.
Pod Lifecycle: từ tạo đến xóa
Hiểu lifecycle giúp engineer debug nhanh và cấu hình đúng handler:
| Giai đoạn | Trạng thái | Controller hành động |
|---|---|---|
| Pending | Pod chấp nhận nhưng chưa chạy | Scheduler tìm node đủ resource |
| ContainerCreating | Kéo image, tạo container | kubelet gọi container runtime |
| Running | Tất cả container đang hoạt động | Health probe giám sát liên tục |
| Succeeded | Hoàn thành (Jobs) | Pod dừng, không restart |
| Failed | Exit code khác 0 | Restart policy quyết định retry |
| Unknown | Không xác định trạng thái | Thường do kubelet mất kết nối |
Restart Policies: Always, OnFailure, Never
Pod.spec.restartPolicy chỉ định hành vi khi container exit:
- Always (mặc định cho Deployments): restart bất kể exit code.
- OnFailure: chỉ restart khi exit code khác 0 (phù hợp batch job).
- Never: không restart (dùng cho debugging hoặc CronJob hoàn thành).
Kết hợp với restartPolicy và backoffLimit trong Job spec, engineer kiểm soát retry. Ví dụ: backoffLimit=3, restartPolicy=OnFailure → tối đa 3 retry, sau đó chuyển Job sang Failed.
Probes: Liveness, Readiness, Startup
Three probe types quyết định traffic và lifecycle:
- Liveness: phát hiện app chết → restart container. Không dùng cho dependency check (DB offline không có nghĩa app chết).
- Readiness: xác định pod nhận traffic hay không. Pod chưa ready sẽ bị loại khỏi Service endpoint.
- Startup: cho app khởi động chậm (Java, ML model). Bỏ qua Liveness/Readiness cho đến khi startup probe succeed.
Khuyến nghị cấu hình:
livenessProbe:
  httpGet:
    path: /healthz
    port: 8080
  initialDelaySeconds: 15
  periodSeconds: 10
  failureThreshold: 3
  timeoutSeconds: 2
readinessProbe:
  httpGet:
    path: /ready
    port: 8080
  initialDelaySeconds: 5
  periodSeconds: 5
  failureThreshold: 3
  timeoutSeconds: 2
startupProbe:
  httpGet:
    path: /healthz
    port: 8080
  failureThreshold: 30
  periodSeconds: 2
Startup probe failureThreshold=30 với periodSeconds=2 cho phép 60s khởi động — phù hợp Java Spring Boot load class nặng.
Management Patterns: từ Pod đến Production
Pattern 1: Deployment — Stateless ứng dụng
Deployment quản lý ReplicaSet, tự rollback version. Spec tối thiểu:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web-app
spec:
  replicas: 3
  selector:
    matchLabels:
      app: web-app
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 1
      maxUnavailable: 0
  template:
    spec:
      containers:
      - name: app
        image: registry.example.com/web-app:v1.2.0
        resources:
          requests:
            cpu: 250m
            memory: 256Mi
          limits:
            cpu: 500m
            memory: 512Mi
maxSurge=1, maxUnavailable=0: rolling update không gián đoạn — luôn đảm bảo toàn bộ bản sao chạy.
Pattern 2: StatefulSet — Ứng dụng stateful
Database (PostgreSQL, Redis) cần StatefulSet: stable network ID, persistent storage, ordered deployment.
- Pod tên:
db-0,db-1(không random). - PersistentVolumeClaim template gắn volume ổn định qua restart.
- Startup/Shutdown ordered: db-1 khởi động sau db-0 (cụm master trước).
Pattern 3: DaemonSet — Node-level agent
Log collector (Fluentd), monitoring (Prometheus Node Exporter), network plugin (Cilium). DaemonSet đảm bảo 1 pod trên mỗi node.
Pattern 4: Job/CronJob — Batch processing
Job chạy task đến hoàn thành (một lần). CronJob lên lịch theo cron expression. Ví dụ:
apiVersion: batch/v1
kind: CronJob
metadata:
  name: daily-report
spec:
  schedule: "0 6 * * *"
  jobTemplate:
    spec:
      backoffLimit: 2
      template:
        spec:
          containers:
          - name: report
            image: registry.example.com/report-gen:latest
            resources:
              requests:
                cpu: 100m
                memory: 128Mi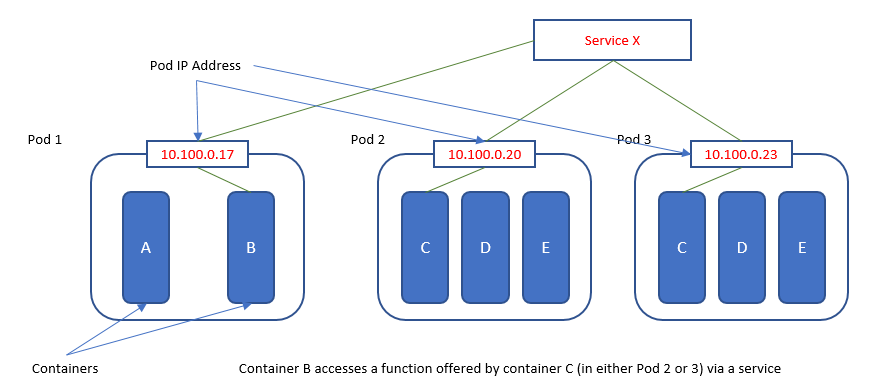
Resource Requests vs Limits: tối ưu cost cloud
Request = tài nguyên đảm bảo (scheduler dùng). Limit = trần (throttled nếu vượt). Sai lầm phổ biến: đặt request=limit → không có burst room, hoặc đặt limit quá cao → wasted cost.
| Scenario | Request | Limit | Kết quả |
|---|---|---|---|
| Conservative | 250m CPU | 500m CPU | Burst lên 2x khi cần |
| Guaranteed | 500m CPU | 500m CPU | Không throttle, nhưng cost cao |
| Burstable | 100m CPU | 1000m CPU | Throttled nhiều dưới load |
Công thức thực tế: request = P95 usage, limit = P99 + 20%. Theo dõi metrics từ Prometheus/CloudWatch → adjust sau 2 tuần vận hành.
Debugging pod gặp lỗi
kubectl describe pod <name>: xem event, lý do Failed/SchedulingFailure.kubectl logs <pod> --previous: log container trước lần restart gần nhất.kubectl exec -it <pod> -- /bin/sh: truy cập shell (nếu có).- Check Events trên node:
kubectl get events --sort-by=.metadata.creationTimestamp. - Common lỗi:
ImagePullBackOff(saio registry auth),CrashLoopBackOff(app error),Evicted(node resource đầy).
Kết luận
Pod management hiệu quả đòi hỏi hiểu sâu lifecycle, cấu hình probes đúng, và pattern triển khai phù hợp với tính chất ứng dụng. Bắt đầu với Deployment cho stateless, StatefulSet cho stateful, DaemonSet cho node-level — mỗi pattern có tài liệu chi tiết tại Kubernetes.io và Configure Pod Container.