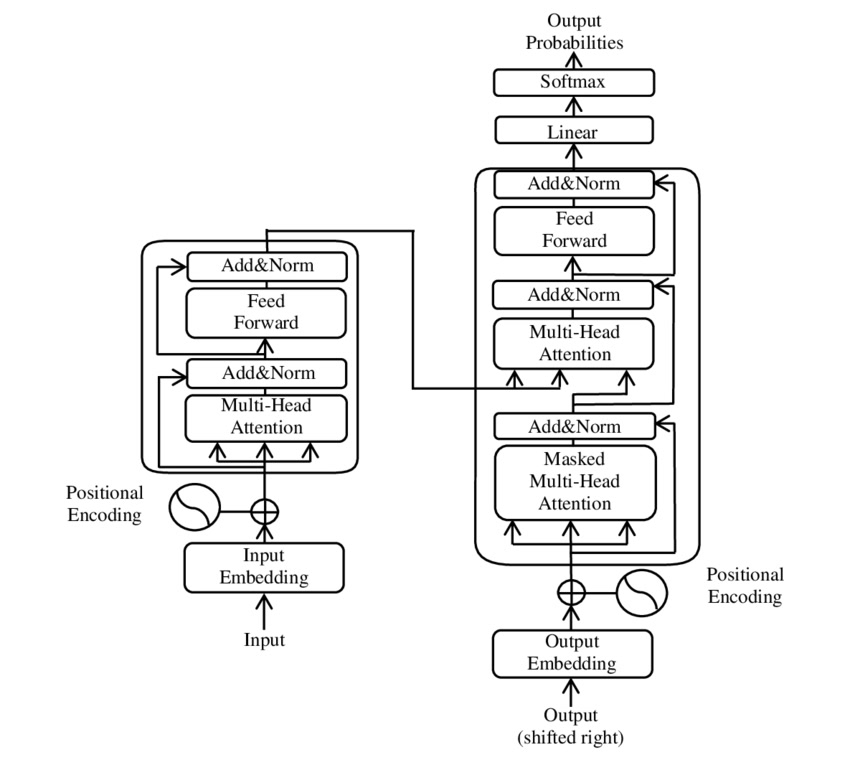
Mixture of Experts (MoE) là kiến trúc mô hình ngôn ngữ lớn chỉ kích hoạt một tập hợp con tham số mỗi token, giúp tăng hiệu năng suất tính toán mà không tăng tham số tuyến tính. Thay vì dense layer xử lý toàn bộ mô hình như Transformer truyền thống, MoE dùng router để định tuyến token đến expert phù hợp, chỉ tính toán trên sub-network.
Cơ chế cơ bản
MoE thay thế mỗi feed-forward (FFN) trong Transformer bởi Sparse Mixture of Experts. Mỗi token được gửi đến k expert được chọn bởi gating network (router). Trong Switch Transformer của Google, k=1 — mỗi token đến đúng 1 expert duy nhất. Điều này tạo sparsity thực tế.
So sánh Dense vs MoE
| Tiêu chí | Dense Transformer | MoE |
|---|---|---|
| Số tham số được tính | 100% mỗi forward pass | Chỉ ~10-20% expert được chọn |
| FLOPs mỗi token | CA * 4N (C=hidden, A=heads, N=params) | ~CA * 4N * (1/E) với E expert |
| Memory bandwidth | Load toàn bộ weight | Load subset weight |
| Batch size lớn | Tận dụng GPU tốt | Load balancing phức tạp |
| Hiệu quả training | Đơn giản, ổn định | Cần chiến lược load balancing, z-loss |

Switch Transformer
Google giới thiệu Switch Transformer (2021) với cải tiến đơn giản: mỗi token chọn duy nhất 1 expert thay vì top-k. Top-1 gating giảm chi phí compute và load balancing. Router dùng softmax trên expert output. Thêm auxiliary load balancing loss để đảm bảo expert phân bố đều token, tránh một số expert quá tải.
Mixtral of Experts (MoE hiện đại)
Mixtral 8x7B (Mistral AI, 2023) dùng 8 expert mỗi layer, mỗi expert là 7B dense. Mỗi token đến top-2 expert. Tổng tham số 47B nhưng mỗi inference chỉ active ~13B tham số — tốc độ nhanh gấp ~3.6 lần dense 7B với chất lượng vượt trội.
Phiên bản Mixtral 8x22B tăng scale hơn, cho thấy MoE hoạt động tốt ở quy mô lớn. Mixtral paper chứng minh expert đa dạng, mỗi expert chuyên biệt ngữ cảnh khác nhau.

Expert specializations
Nghiên cứu cho thấy expert tự động phân công nhiệm vụ:
- Expert A: xử lý code, syntax.
- Expert B: xử lý toán, logic.
- Expert C: dịch thuật đa ngữ.
- Expert D: factual knowledge retrieval.
Router học định tuyến token đến expert phù hợp mà không cần giám sát. Đây là emergence behavior đáng chú ý.
Khi nào dùng MoE
MoE phù hợp khi cần model lớn (trên 7B params) với budget inference hạn chế. Tuy nhiên:
- Training phức tạp: load balancing, expert dropout, z-loss tuning.
- Inference: cần dispatch expert động, không tận dụng batching tốt bằng dense nếu expert ít.
- Fine-tune: MoE adapter layer phức tạp hơn dense.
Kết luận
MoE đang trở thành kiến trúc mặc định cho LLM cỡ lớn (GPT-4, Mixtral, DeepSeek-V2, Gemini). Miễn là bạn cần model chất lượng cao với inference cost thấp, MoE là lựa chọn mạnh mẽ. Hiểu router mechanism, load balancing, expert specialization giúp triển khai và tối ưu MoE hiệu quả.
Nguồn: Switch Transformer paper, Mixtral 8x7B paper, HuggingFace – Mixtral