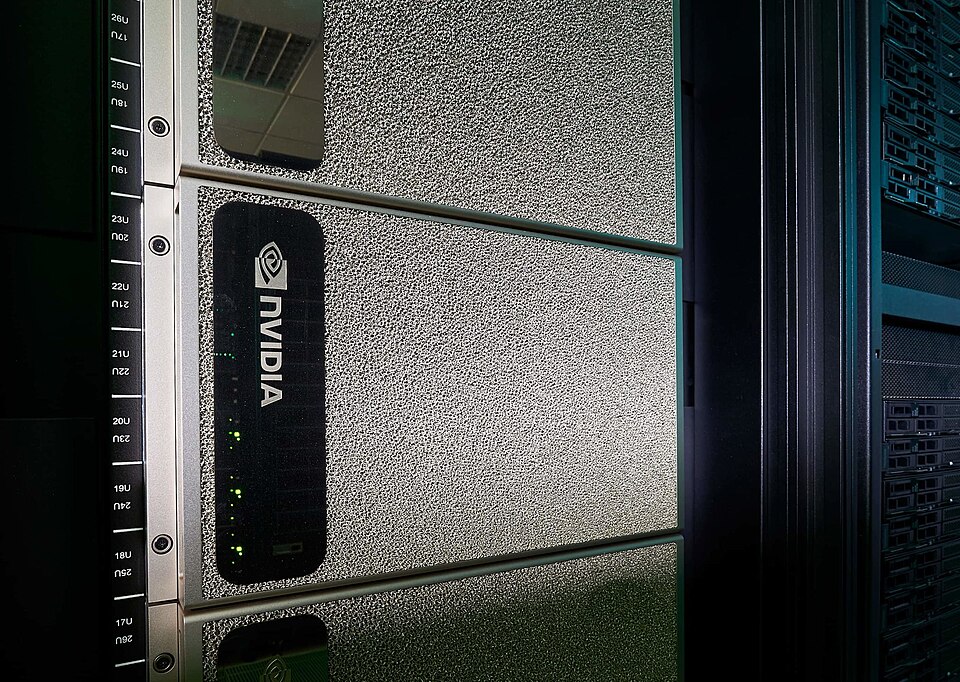
NVIDIA Blackwell là kiến trúc GPU thế hệ mới kế thừa Hopper, được NVIDIA công bố tháng 3 năm 2024 nhằm mục đích xử lý các mô hình AI khổng lồ lên đến trăm tỷ tham số. Cốt lõi của Blackwell là chip GB200 Grace Blackwell Superchip — kết hợp CPU Grace và GPU Blackwell trên một gói, mang lại hiệu năng bước nhảy vọt cho huấn luyện và suy luận AI quy mô lớn.
NVIDIA Blackwell là gì và tại sao quan trọng?
Blackwell không chỉ là một GPU đơn lẻ mà là một nền tảng tính toán tích hợp, thiết kế từ đầu cho thời đại AI tạo sinh (generative AI). Khác với Hopper tập trung vào FP8/FP16, Blackwell đưa độ chính xác FP4 vào sản xuất hàng loạt — cho phép mô hình chạy nhanh hơn gấp nhiều lần với dung lượng bộ nhớ giảm đáng kể.
- Transformer Engine thế hệ 2: Tự động chuyển đổi độ chính xác (FP8, FP6, FP4) theo từng layer, tối ưu tốc độ mà không mất độ chính xác mô hình.
- NVLink-C2C: Kết nối CPU-GPU với băng thông 900 GB/s, loại bỏ bottleneck truyền thống giữa host và accelerator.
- RAS Engine: Đảm bảo độ tin cậy cực cao cho cluster hàng nghìn GPU chạy liên tục nhiều tuần.
- Secure AI: Hỗ trợ confidential computing, bảo vệ trọng số mô hình và dữ liệu nhạy cảm ngay trong VRAM.
GB200: Superchip cho AI quy mô siêu lớn
GB200 là sản phẩm cờ của nền tảng Blackwell. Mỗi GB200 gồm 1 CPU Grace (72 nhân Arm Neoverse V2) và 2 GPU Blackwell, tổng cộng 208 tỷ transistor (tsmc 4NP). Tính toán dày đặc FP4 đạt 20 petaFLOPS — gấp 5 lần H100. Băng thông bộ nhớ HBM3E 384 GB với tốc độ 8 TB/s cho phép nạp toàn bộ trọng số GPT-4 (1.8T params) chỉ trong vài giây.
NVIDIA cũng cung cấp hệ thống rack-scale NVL72: 36 GB200 trong một rack mỏng, chia sẻ domain NVLink đơn nhất 72 GPU. Cấu hình này thay thế hàng trăm node truyền thống, giảm 25x chi phí năng lượng cho mỗi lần huấn luyện LLM 1.8T tham số.
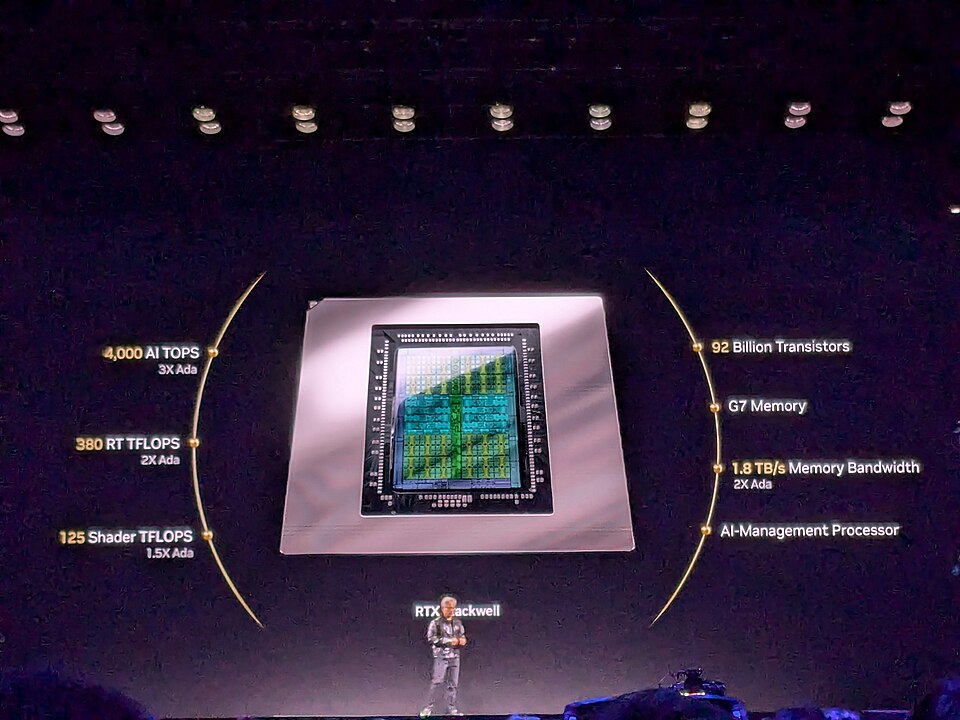
So sánh Blackwell vs Hopper (H100/H200)
| Đặc điểm | H100 (Hopper) | Blackwell GB200 |
|---|---|---|
| Kiến trúc transistor | TSMC 4N (80B) | TSMC 4NP (208B) |
| Độ chính xác AI | FP8, FP16, BF16 | FP4, FP6, FP8, FP16 |
| FP4 Tensor Core | Không hỗ trợ | 20 petaFLOPS |
| Bộ nhớ / GPU | 80 GB HBM3 | 192 GB HBM3E (x2 GPU) |
| Băng thông bộ nhớ | 3.35 TB/s | 8 TB/s |
| CPU-GPU Interconnect | PCIe 5.0 (128 GB/s) | NVLink-C2C (900 GB/s) |
| TDP | 700 W | 1200 W (toàn bộ GB200) |
Ứng dụng thực tế: LLM, HPC và khoa học
Blackwell nhắm vào ba workload chính:
- Huấn luyện LLM khổng lồ: GPT-4, Llama 3 400B, mixture-of-experts models. FP4 giảm 4x bộ nhớ so với FP16, cho phép batch size lớn hơn.
- Suy luận thời gian thực: Chatbot, code generation, RAG. Throughput tăng 30x so với H100 nhờ FP4 + speculative decoding.
- Mô phỏng khoa học & HPC: Khí động học chất lỏng, khí hậu, động lực học phân tử. Tensor Core FP64/FP32 nâng cấp cho double precision.
Hệ sinh thái phần mềm: CUDA, cuDNN, TensorRT-LLM
NVIDIA đảm bảo tương thích ngược hoàn toàn. Các framework PyTorch, JAX, TensorFlow đã hỗ trợ Blackwell qua CUDA 12.4+. TensorRT-LLM tối ưu hóa FP4 quantization tự động, speculative decoding, in-flight batching — không cần thay đổi code mô hình. NGC containers cung cấp sẵn môi trường production-ready.
Thách thức và triển vọng
Dù mạnh mẽ, Blackwell đối mặt với cung cấp HBM3E hạn hẹp, giá thành cao (ước tính $30k–$40k/GB200), và yêu cầu làm mỏng nước đối với NVL72. Các cloud provider lớn (AWS, Azure, GCP, Oracle) đã đặt hàng trước quy mô lớn. Năm 2025 sẽ thấy Blackwell thống trị Top500 và Green500.
Tóm lại: NVIDIA Blackwell định hình lại kinh tế học AI quy mô lớn. FP4, NVLink-C2C, và rack-scale NVL72 cùng đẩy chi phí huấn luyện LLM giảm theo quy mô Moore’s Law cho AI. Doanh nghiệp đầu tư sớm vào hạ tầng Blackwell sẽ có lợi thế thời gian-to-market quyết định.
Tham khảo thêm: NVIDIA Grace Blackwell Platform | NVIDIA Developer Blog: Blackwell