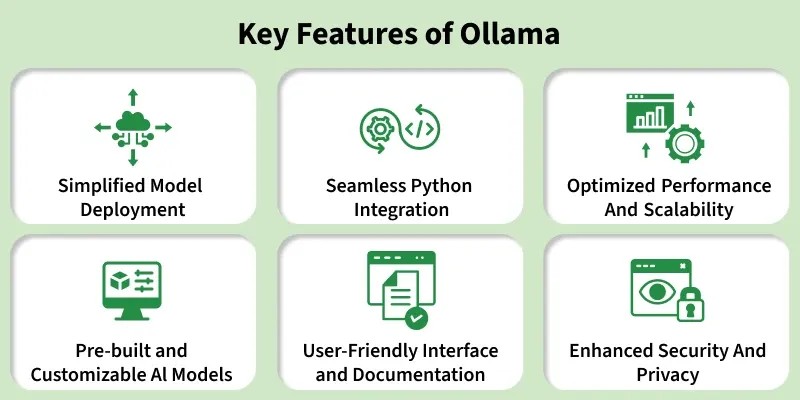
Ollama là nền tảng cho phép chạy các mô hình ngôn ngữ lớn (LLM) như Llama, Mistral, Gemma trực tiếp trên máy local mà không cần phụ thuộc vào dịch vụ đám mây. Điều này giúp bảo mật dữ liệu, giảm chi phí và cung cấp độ trễ thấp cho các ứng dụng AI cá nhân, phát triển viên và doanh nghiệp.
Tích hợp LLM trực tiếp trên thiết bị
Ollama cung cấp một môi trường đơn giản để tải xuống và chạy các mô hình LLM mã nguồn mở. Thay vì dựa vào API đám mây tốn kém theo token, người dùng có thể tải mô hình một lần và sử dụng vô hạn lần mà không lo phát sinh chi phí. Điều này đặc biệt hữu ích cho các doanh nghiệp nhạy cảm với dữ liệu như cơ quan tài chính, y tế hoặc nghiên cứu.
- Tải mô hình một lần và sử dụng vô hạn lần.
- Kiểm soát hoàn toàn dữ liệu nhập xuất, không rời khỏi máy chủ nội bộ.
- Tận dụng phần cứng local như CPU, GPU (NVIDIA CUDA, AMD ROCm) để tăng tốc inference.
- Hỗ trợ tùy biến và fine-tuning bằng Modelfile.
Hướng dẫn cài đặt Ollama trên Linux
Bước 1: Tải script cài đặt
Mở terminal và thực hiện lệnh sau để tải script cài đặt chính thức từ Ollama:
curl -fsSL https://ollama.com/install.sh | shScript này sẽ tự động phát hiện hệ điều hành và bản cài đặt phù hợp với kiến trúc (x86_64, ARM64). Đối với máy có GPU NVIDIA, Ollama cũng tự động cài thêm thành phần hỗ trợ CUDA.
Bước 2: Khởi động dịch vụ Ollama
Sau khi cài đặt, khởi động Ollama dưới dạng systemd service để tự động chạy khi khởi động hệ thống:
systemctl start ollama
systemctl enable ollama
Kiểm tra trạng thái dịch vụ để xác nhận Ollama đang hoạt động bình thường:
systemctl status ollamaBước 3: Tải mô hình Mistral tiếng Việt
Ollama cung cấp kho models phong phú. Để tải mô hình Mistral có khả năng xử lý tiếng Việt tốt:
ollama pull mistralNgoài Mistral, Ollama còn hỗ trợ các mô hình tối ưu cho tiếng Việt như:
- Vistral 7B: Mô hình LLM tiếng Việt được tinh chỉnh trên nền tảng Mistral.
- PhoGPT 7.5B: Mô hình tiếng Việt từ VinAI với khả năng hiểu ngữ cảnh dài.
- Ba Mì 1.3B (Bmzy): Mô hình nhẹ cho thiết bị có tài nguyên hạn chế.
- Llama 3, Gemma, Qwen: Các mô hình quốc tế hỗ trợ tiếng Việt qua prompt chuyển đổi.
Chạy và tương tác với mô hình LLM
Chạy mô hình qua dòng lệnh
Sau khi tải mô hình xong, bắt đầu tương tác ngay với lệnh ollama run:
ollama run mistral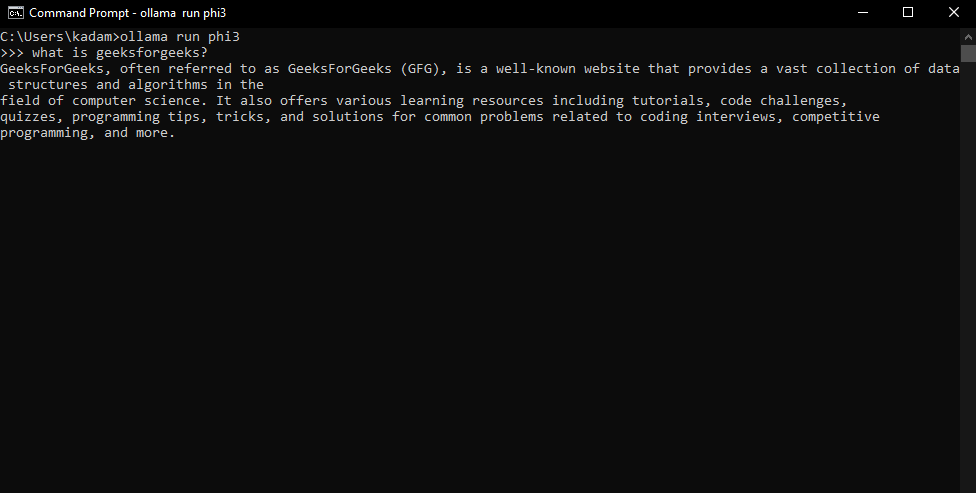
Ollama sẽ tải mô hình vào bộ nhớ và hiển thị prompt để người dùng bắt đầu trò chuyện. Ví dụ về một phiên trò chuyện:
>>> Tại sao bầu trời có màu xanh?
Bầu trời có màu xanh vì các photon trong ánh sáng trắng bị tán xạ bởi các phân tử và hạt nhỏ trong khí quyển theo hiện tượng Rayleigh scattering. Ánh sáng xanh có bước sóng ngắn nên bị tán xạ mạnh hơn, chiếm ưu thế trong mắt người vào ban ngày.
Sử dụng Ollama qua API
Ollama cung cấp API tương thích OpenAI để tích hợp vào ứng dụng python:
import ollama

response = ollama.chat(
    model='mistral',
    messages=[
        {'role': 'user', 'content': 'Liệt kê 5 ứng dụng của trí tuệ nhân tạo trong y tế'}
    ]
)
print(response['message']['content'])
Tối ưu hiệu suất trên phần cứng
Tận dụng GPU NVIDIA
Nếu có GPU NVIDIA, cài đặt driver CUDA và Ollama sẽ tự động dùng để tăng tốc inference:
# Cài đặt driver NVIDIA trên Ubuntu
sudo apt update
sudo apt install nvidia-driver-550
sudo reboot
Giới hạn và cấu hình tài nguyên
Trong file cấu hình ~/.ollama/config.json, bạn có thể thiết lập:
OLLAMA_NUM_PARALLEL: Số request xử lý đồng thời.OLLAMA_MAX_LOADED_MODELS: Số model tối đa giữ trong bộ nhớ.OLLAMA_KEEP_ALIVE: Thời gian giữ model trong RAM sau lần dùng cuối.OLLAMA_HOST: Địa chỉ bind để chấp nhận kết nối từ mạng nội bộ.
Một số lệnh quản lý model cần biết
Bảng tóm tắt các lệnh CLI phổ dụng của Ollama:
| Lệnh | Mô tả |
|---|---|
ollama pull |
Tải một model từ kho của Ollama. |
ollama run |
Chạy model và bắt đầu phiên trò chuyện. |
ollama create |
Tạo model tùy chỉnh từ Modelfile. |
ollama rm |
Xóa model đã tải khỏi ổ đĩa. |
ollama list |
Liệt kê các model hiện có trên thiết bị. |
ollama cp |
Sao chép model để tạo bản sao thử nghiệm. |
Ứng dụng thực tế của Ollama
Với Ollama, các nhà phát triển và doanh nghiệp có thể triển khai:
- Xây dựng chatbot hỗ trợ khách hàng nội bộ không cần kết nối internet.
- Tích hợp LLM vào IDE như VS Code thông qua các extensions hỗ trợ Ollama.
- Tạo công cụ tự động tóm tắt tài liệu nội bộ cho doanh nghiệp.
- Phát triển trợ lý ảo tiếng Việt chạy trên thiết bị di động hoặc server edge.
- Thử nghiệm fine-tuning mô hình trên tập dữ liệu doanh nghiệp riêng.
So sánh với dịch vụ LLM đám mây
So với việc sử dụng API của OpenAI, Anthropic hay Google, Ollama mang lại những lợi thế sau:
- Chi phí: Chỉ từng đầu tư phần cứng một lần, không tính phí theo token.
- Bảo mật: Dữ liệu không bao giờ rời khỏi môi trường nội bộ.
- Tùy chỉnh: Quyền truy cập hoàn toàn vào trọng số và cấu trúc mô hình.
- Độ trễ: Giao tiếp local nhanh hơn rất nhiều so với qua mạng internet.
- Nhãn quảng cáo: Không phụ thuộc vào chính sách của nhà cung cấp dịch vụ đám mây.
Kết luận
Ollama đơn giản hoá việc chạy LLM tiếng Việt trên Linux, mang lại quyền kiểm soát dữ liệu và giảm phụ thuộc vào dịch vụ bên ngoài. Với quá trình cài đặt chỉ bằng một lệnh và kho models phong phú hỗ trợ tiếng Việt, Ollama là công cụ lý tưởng cho developer, nhà nghiên cứu và người dùng cá nhân muốn khám phá AI tại địa phương.