Reinforcement Learning Là Gì?
Reinforcement Learning (RL) là nhánh học máy trong đó tác tử (agent) học cách ra quyết định bằng cách tương tác với môi trường, nhận phần thưởng hoặc hình phạt. Khác với supervised learning, RL không cần dữ liệu gán nhãn — nó tự khám phá chiến lược tối ưu qua trial and error.
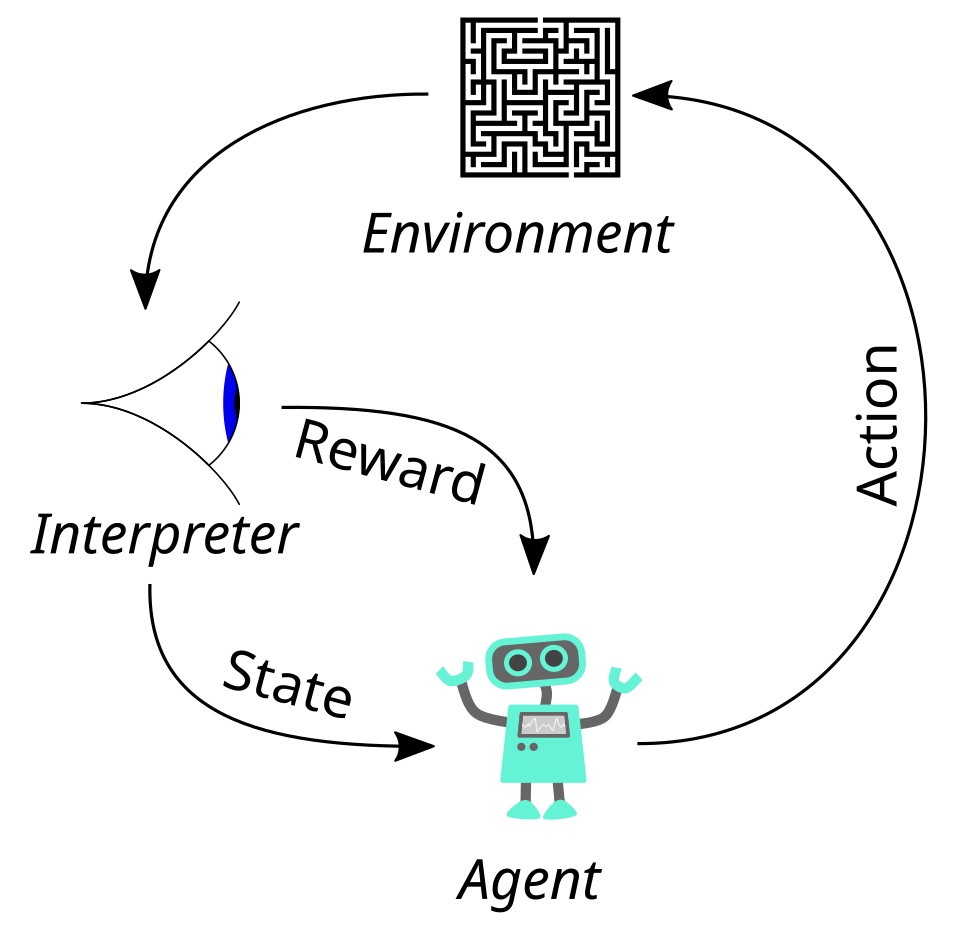
Kiến Trúc Cơ Bản
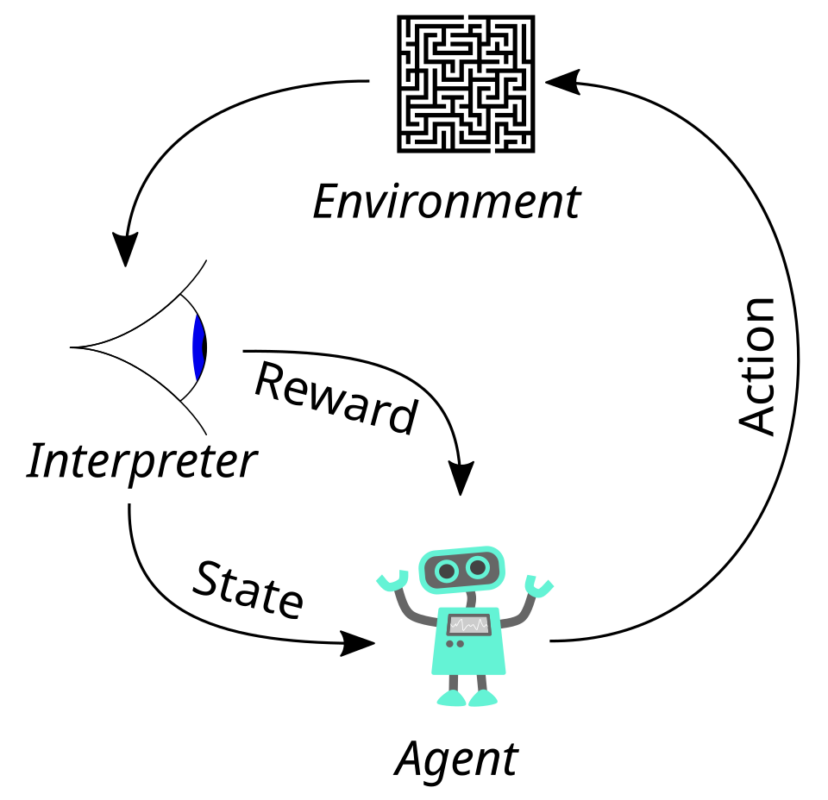
Vòng lặp RL gồm 5 thành phần cốt lõi:
- Agent: Tác tử ra quyết định (AI model)
- Environment: Thế giới mà agent tương tác
- State (S): Trạng thái hiện tại của môi trường
- Action (A): Hành động agent thực hiện
- Reward (R): Phản hồi định lượng từ môi trường
Ở mỗi bước thời gian t: agent quan sát state Sₜ, thực hiện action Aₜ, nhận reward Rₜ₊₁, chuyển sang state mới Sₜ₊₁. Mục tiêu: tối đa hóa tổng phần thưởng discounted Gₜ = Rₜ₊₁ + γRₜ₊₂ + γ²Rₜ₊₃ + … với γ là discount factor (0 ≤ γ ≤ 1).
Thuật Toán Q-Learning
Q-Learning là thuật toán RL không-model (model-free) phổ biến nhất. Nó học bảng Q-value ước lượng giá trị hành động tại mỗi state:
Q(Sₜ, Aₜ) ← Q(Sₜ, Aₜ) + α[Rₜ₊₁ + γ·max_a Q(Sₜ₊₁, a) − Q(Sₜ, Aₜ)]Trong đó: α là learning rate, γ discount factor. Thuật toán hội tụ đến chính sách tối ưu khi tất cả state-action được thăm đủ nhiều lần.
Deep Q-Network (DQN)
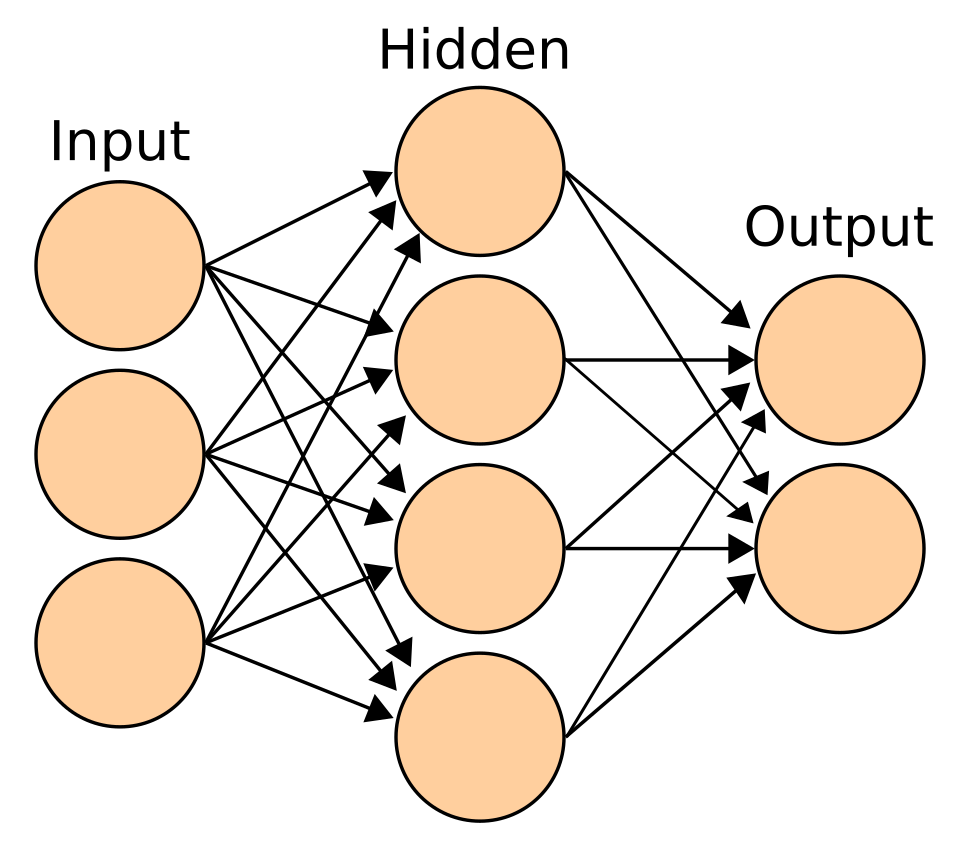
DQN thay thế bảng Q bằng neural network, cho phép RL hoạt động trên không gian state lớn (như hình ảnh). Đột phá này giúp DeepMind đánh bại nhà vô địch Go năm 2016.
- Experience Replay: Lưu các transition (S, A, R, S’) vào buffer, lấy mẫu ngẫu nhiên để huấn luyện — phá vỡ tương quan
- Target Network: Dùng bản sao network cố định để tính target, giảm instability
Ứng Dụng Thực Tế
RL đã tạo nhiều thành tựu đáng chú ý:
| Lĩnh vực | Ví dụ | Kết quả |
|---|---|---|
| Trò chơi | AlphaGo, Atari DQN | Đánh bại nhà vô địch thế giới |
| Robot | Điều khiển robot Boston Dynamics | Di chuyển tự nhiên |
| Giao dịch | Tối ưu portfolio | Vượt thị trường truyền thống |
| Y tế | Điều trị cá nhân hóa | Tối ưu phác đồ thuốc |
| Energy | Quản lý lưới điện Google DeepMind | Giảm 40% năng lượng làm mát |
Framework Hỗ Trợ RL
Bắt đầu với RL dễ dàng hơn bao giờ hết nhờ các framework sau:
- OpenAI Gymnasium: Thư viện môi trường chuẩn hóa (
pip install gymnasium) - Stable-Baselines3: Triển khai sẵn PPO, A2C, DQN (
pip install stable-baselines3) - Ray RLlib: RL phân tán quy mô lớn
import gymnasium as gym
from stable_baselines3 import PPO

env = gym.make("CartPole-v1")
model = PPO("MlpPolicy", env, verbose=1)
model.learn(total_timesteps=10000)
obs, info = env.reset()
for _ in range(1000):
    action, _ = model.predict(obs)
    obs, reward, terminated, truncated, info = env.step(action)
Thách Thức
RL không dễ triển khai. Các vấn đề chính:
- Sample efficiency: Cần hàng triệu lần tương tác
- Reward shaping: Thiết kế hàm thưởng phù hợp khó hơn tưởng
- Sparse reward: Nhiều môi trường chỉ thưởng cuối chuỗi
- Sim-to-real gap: Mô hình mô phỏng khác thực tế
Tham khảo: OpenAI Spinning Up, DeepMind Research
Policy Gradient Và Actor-Critic
Ngoài Q-Learning, Policy Gradient methods tối ưu trực tiếp chính sách:
- REINFORCE: Monte Carlo policy gradient, simple nhưng variance cao
- Actor-Critic (A2C/A3C): Kết hợp value function (critic) để giảm variance
A2C (Advantage Actor-Critic) là thuật toán phổ biến nhất cho production:
from stable_baselines3 import A2C
model = A2C("MlpPolicy", env,
            learning_rate=3e-4,
            n_steps=2048,
            gamma=0.99,
            ent_coef=0.01,  # Entropy bonus khuyến khích khám phá
Reward Shaping: Nghệ Thuật Thiết Kế Phần Thưởng
Reward shaping quyết định agent học hành vi gì. Nguyên tắc vàng:
- Dense reward: Càng nhiều signal càng tốt (tránh sparse reward)
- Shaped reward: Thưởng từng bước gần mục tiêu, không chỉ kết thúc
- Penalize bad behavior: Trừng phạt va chạm, lãng phí năng lượng
- Normalize reward: Giữ reward trong khoảng ổn định cho training
Ví dụ robot đi bộ: reward = distance_forward – 0.1*energy_used – 10*fall_detected
Sim-to-Real Transfer
Huấn luyện trong simulation rồi triển khai thực tế là thách thức lớn nhất:
- Domain Randomization: Thay đổi vật liệu, friction, camera góc mỗi episode
- System Identification: Học dynamics model từ thực tế, fine-tune policy
- Procedural Generation: Tự động tạo môi trường đa dạng
NVIDIA Isaac Gym cho phép huấn luyện hàng nghìn môi trường song song trên GPU — đột phá cho robotics RL.
Tương Lai Của Reinforcement Learning
RL đang phát triển nhanh chóng:
- RLHF: Reinforcement Learning from Human Feedback — nền tảng ChatGPT, Claude
- Offline RL: Học từ dữ liệu lịch sử, không tương tác live
- Multi-Agent RL: Nhiều agent học cùng nhau (hợp tác, cạnh tranh)
- Model-Based RL: Học model môi trường, lập kế hoạch trong tưởng tượng
Tham khảo thêm: RL Article Guide, RLCard Benchmark