Trong thời đại AI explosion, việc lưu trữ và truy vấn vector embeddings một cách hiệu quả đã trở thành yếu tố then chốt để xây dựng các ứng dụng AI mạnh mẽ. Vector database không chỉ là một công cụ lưu trữ đơn thuần mà còn là nền tảng cho retrieval-augmented generation (RAG), long-term memory cho AI agents, và semantic search ở quy mô lớn.
Vector database là gì?
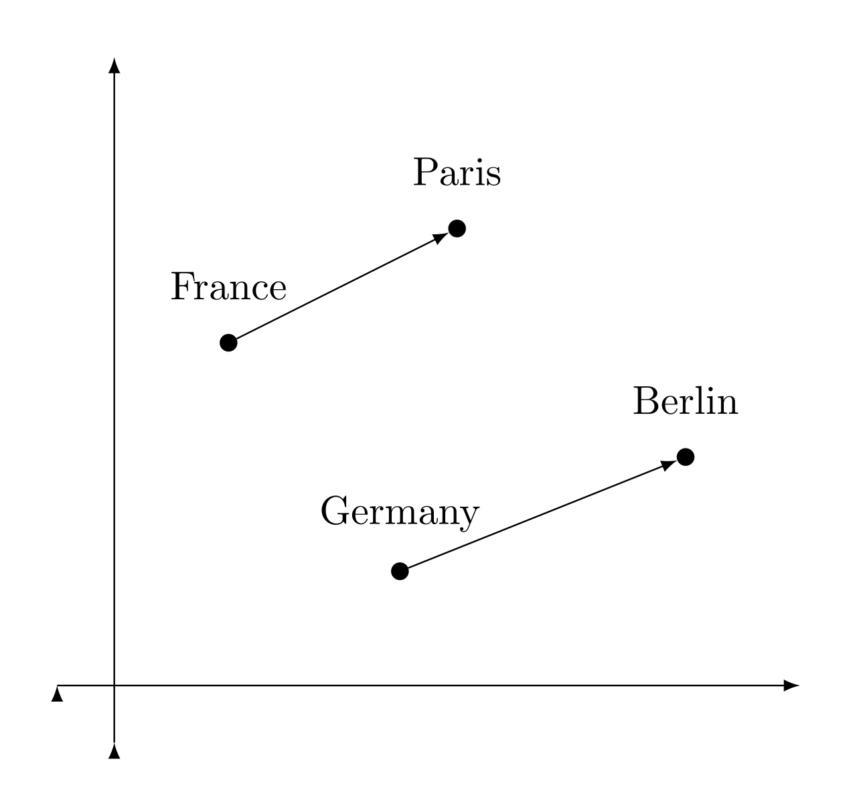
Vector database là một hệ thống cơ sở dữ liệu chuyên biệt được thiết kế để lưu trữ, chỉ mục và truy vấn vector embeddings – các biểu diễn số học của dữ liệu được tạo ra bởi mô hình AI như LLM, sentence transformers, hoặc các mô hình visão. Khác với cơ sở dữ liệu truyền thống hoạt động trên dữ liệu scala (số, chuỗi), vector database sử dụng các thuật toán Approximate Nearest Neighbor (ANN) như HNSW, IVF, PQ, hoặc LSH để tìm kiếm các vector tương tự trong mili giây.
Ba giải pháp hàng đầu: ChromaDB, Pinecone, Weaviate
Trong tập hợp các vector database hiện nay, ba giải pháp nổi bật nhất là ChromaDB (mã nguồn mở), Pinecone (đám mây managed), và Weaviate (open-source với khả năng mở rộng mạnh). Mỗi giải pháp mang lại những ưu điểm riêng phù hợp với các trường hợp sử dụng khác nhau.
ChromaDB: Simplicity for developers
ChromaDB là vector database mã nguồn mở được thiết kế để đơn giản hóa quá trình làm việc với embeddings. Với API trực quan và tích hợp sâu với Sentence Transformers, ChromaDB cho phép bạn bắt đầu lưu trữ và truy vấn vector chỉ trong vài dòng code.
- Ưu điểm: Dễ sử dụng, tích hợp tốt với Python/Rust/JS, miễn phí, thích hợp cho prototyping và ứng dụng vừa.
- Nhược điểm: Hạn chế về scalability khi so sánh với các giải pháp đám mâyEnterprise.
- Use case tốt nhất: Ứng dụng AI nội bộ, nghiên cứu, MVP, và các ứng dụng yêu cầu triển khai nhanh.
Pinecone: Managed service for production
Pinecone cung cấp một plataforma vector database hoàn toàn được quản lý trên đám mây, loại bỏ gánh nặng về vận hành, mở rộng và bảo trì. Với kiến trúc serverless và hỗ trợ multi-tenancy, Pinecone phù hợp cho các ứng dụng AI quy mô lớn yêu cầu tính sẵn sàng cao.
- Ưu điểm: Hoàn toàn quản lý, tự động mở rộng, hỗ trợ real-time updates, tích hợp dễ dàng với LangChain, LlamaIndex.
- Nhược điểm: Chi phí có thể cao hơn so với self-hosted khi 규모 lớn.
- Use case tốt nhất: Ứng dụng AI sản xuất, SaaS, và các hệ thống yêu cầu khả năng mở rộng linh hoạt.
Weaviate: Open-source with GraphQL and AI-native features
Weaviate kết hợp tính open-source với khả năng mở rộng mạnh mẽ, cùng với các tính năng AI-native như tích hợp trực tiếp với các mô hình LLM để thực hiện генеративный поиск và hỗ trợ GraphQL để truy vấn linh hoạt. Weaviate còn nổi bật với khả năng lưu trữ đối tượng (objects) kèm vector embeddings.
- Ưu điểm: Open-source, hỗ trợ GraphQL, tích hợp LLM, khả năng lưu trữ multimodal (text, hình ảnh, âm thanh).
- Nhược điểm: Hơi phức tạp hơn ChromaDB trong việc cài đặt ban đầu.
- Use case tốt nhất: Ứng dụng cần truy vấn linh hoạt, AI agents với memory장기, và các hệ thống multimodal.
Khi nào nên chọn giải pháp nào?
Lựa chọn vector database phụ thuộc vào yêu cầu cụ thể của dự án:
- Chọn ChromaDB nếu bạn đang bắt đầu, muốn giải pháp đơn giản và miễn phí để prototyping.
- Chọn Pinecone nếu bạn cần một giải pháp managed sản xuất với khả năng mở rộng tự động và không lo về vận hành.
- Chọn Weaviate nếu bạn muốn kiểm soát đầy đủ mã nguồn, cần tích hợp GraphQL, hoặc làm việc với dữ liệu multimodal phức tạp.
Tương lai của vector database
Xu hướng hiện nay thể hiện sự chuyển đổi sang kiến trúc serverless và tách riêng storage từ compute để tối ưu chi phí. Các tính năng như multitenancy namespaces, quantization nâng cao, và hybrid search (kết hợp vector và keyword) đang trở thành tiêu chuẩn. Đồng thời, sự ra đời của các mô hình embedding đa modal và đang đẩy vector database phát triển hướng hỗ trợ text, hình ảnh, video và âm thanh trong một không gian embedding thống nhất.


Nếu như ngày hôm nay chúng ta còn lo lắng về chi phí và sự phức tạp của việc triển khai vector database tại quy mô lớn, thì tương lai sẽ mang lại những giải pháp đơn giản hóa hơn nữa. Sự ra đời của các chip accelerators chuyên dụng cho vector search (như NPUs được tối ưu cho ANN search) và sự phát triển của các thuật toán learning-to-index có thể sẽ giảm thời gian cần thiết cho vector search xuống mức micro giây. Đồng thời, xu hướng bleeding-edge của việc kết hợp vector database với các hệ thống kiến thức (knowledge graphs) mở ra cánh cửa cho một thế hệ mới của AI hybrids, nơi khả năng truy vấn vector và suy luận logic tồn tại song song trong cùng một nền tảng thống nhất.
Ngoài ra, các nhà cung cấp dịch vụ đám mây đang tích hợp vector database trực tiếp vào nền tảng của họ, giúp người dùng không cần phải triển khai và vận hành riêng biệt. Điều này mở ra triển vọng cho một tương lai nơi mà mỗi ứng dụng AI đều có thể tiếp cận một vector database mạnh mẽ chỉ bằng vài dòng cấu hình, mà không cần lo lắng về khía cạnh của việc vận hành hệ thống.