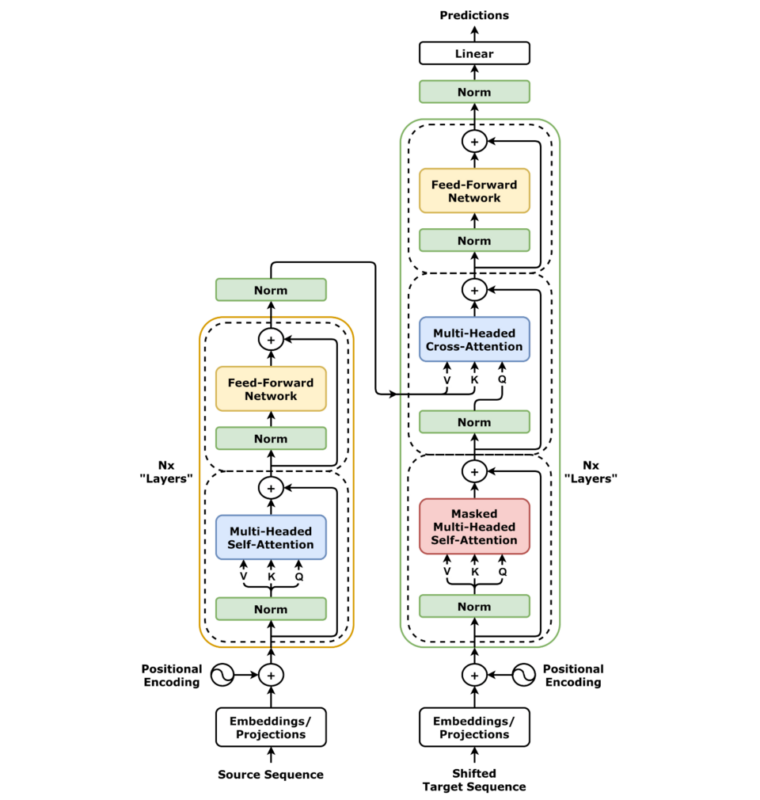
Multi-Query Attention: cách giảm 70% memory cho LLM lớn
Multi-Query Attention (MQA) là một kỹ thuật tối ưu kiến trúc Transformer giúp giảm đáng kể lượng bộ nhớ và thời gian suy diễn của các mô hình ngôn ngữ lớn. Khi các mô hình LLM ngày càng lớn với hàng trăm tỷ tham số, việc lưu trữ key-value (KV) cache cho attention mechanism trở thành rào cản lớn. MQA đưa ra giải pháp bằng cách chia sẻ các key và value vectors trên toàn bộ heads, thay vì mỗi head có bộ riêng. Kỹ thuật này được ứng dụng thành công trong các mô hình thương mại như Google Switch Transformer và sau này phát triển thành Grouped-Query Attention (GQA) trong các dự án Hugging Face.
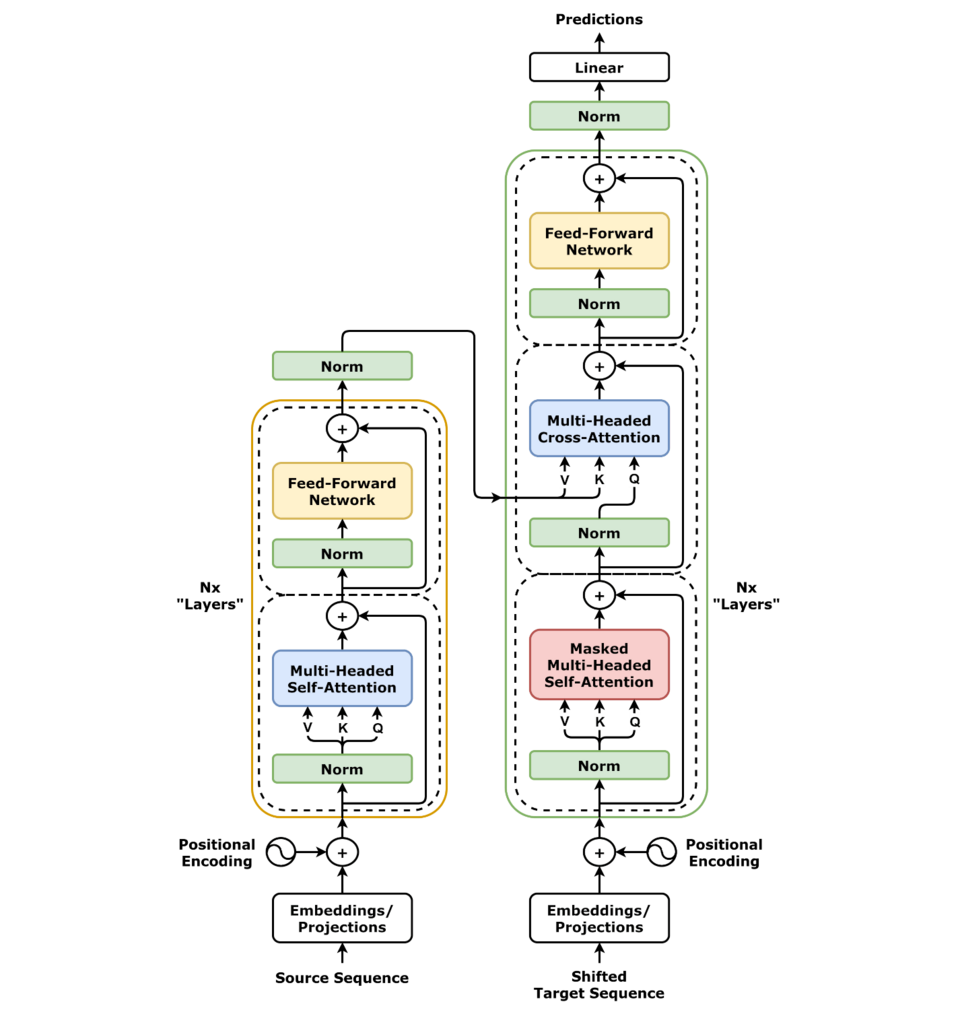
Cơ chế hoạt động của Multi-Query Attention
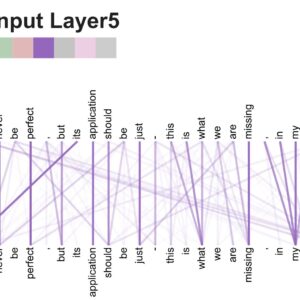
Trong kiến trúc Transformer truyền thống, Multi-Head Attention sử dụng n cặp head riêng biệt — mỗi head có một ma trận truy vấn (query), một ma trận khóa (key) và một ma trị (value). Khi sinh từng token trong quá trình suy diễn, toàn bộ KV cache phải được lưu trữ trong bộ nhớ, gây tỷ lệ tăng đường tính với số lượng heads. Với MQA, tất cả các query vectors được giữ riêng biệt (để duy tr hexColor ai), nhưng key và value vectors được chia sẻ chung cho toàn bộ heads. Điều này giảm kích thước KV cache từ n × head_dim xuống còn 1 × head_dim.
| Phương pháp | Số key/value riêng | Kích thước KV cache | Tác động |
|---|---|---|---|
| Multi-Head Attention | Hàng chục (n_heads) | Lớn, tăng tuyến tính | Chậm, tốn memory |
| Multi-Query Attention | 1 (chia sẻ) | Nhỏ, giảm ~n lần | Nhanh, tiết kiệm memory |
| Grouped-Query Attention | n_groups (thường 2-8) | Trung gian | Cân bằng tốc độ và độ chính xác |
Thành tích thực tế của MQA
Theo nghiên cứu của Google, Switch Transformer (sử dụng MQA) đạt tốc độ suy diễn nhanh hơn 3-7 lần so với MHA truyền thống với cùng độ chính xác. Tuy nhiên, việc chia s�ẻ toàn bộ key/value có thể gây mất độ chính xác ở một số tác vụ. Đây chính là lý do tại sao GQA (G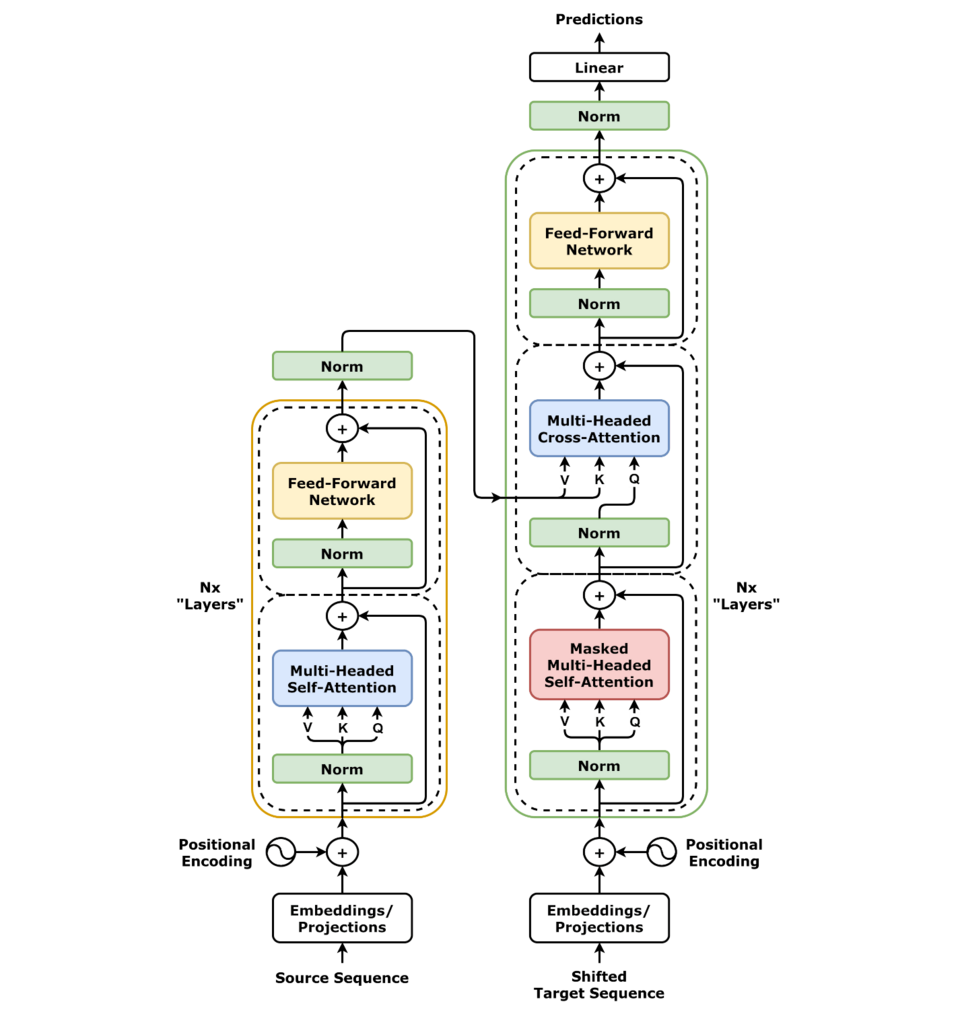
Grouped-Query Attention: phiên bản nâng cấp của MQA
GQA ra đời như một giải pháp trung gian giữa MHA và MQA. Thay vì chia sẻ toàn bộ key/value cho 1 head, GQA chia các key/value thành một số nhóm nhỏ (thường là 2-8 nhóm). Mỗi nhóm query vectors sẽ chia sẻ key/value của nhóm mình. Cơ chế này giữ được phần lớn lợi thế về memory của MQA nhưng giảm thiểu mất mát độ chính xác.
- GQA với 2 nhóm: giảm ~50% KV cache so với MHA, phù hợp cho mô hình 7B-13B
- GQA với 4-8
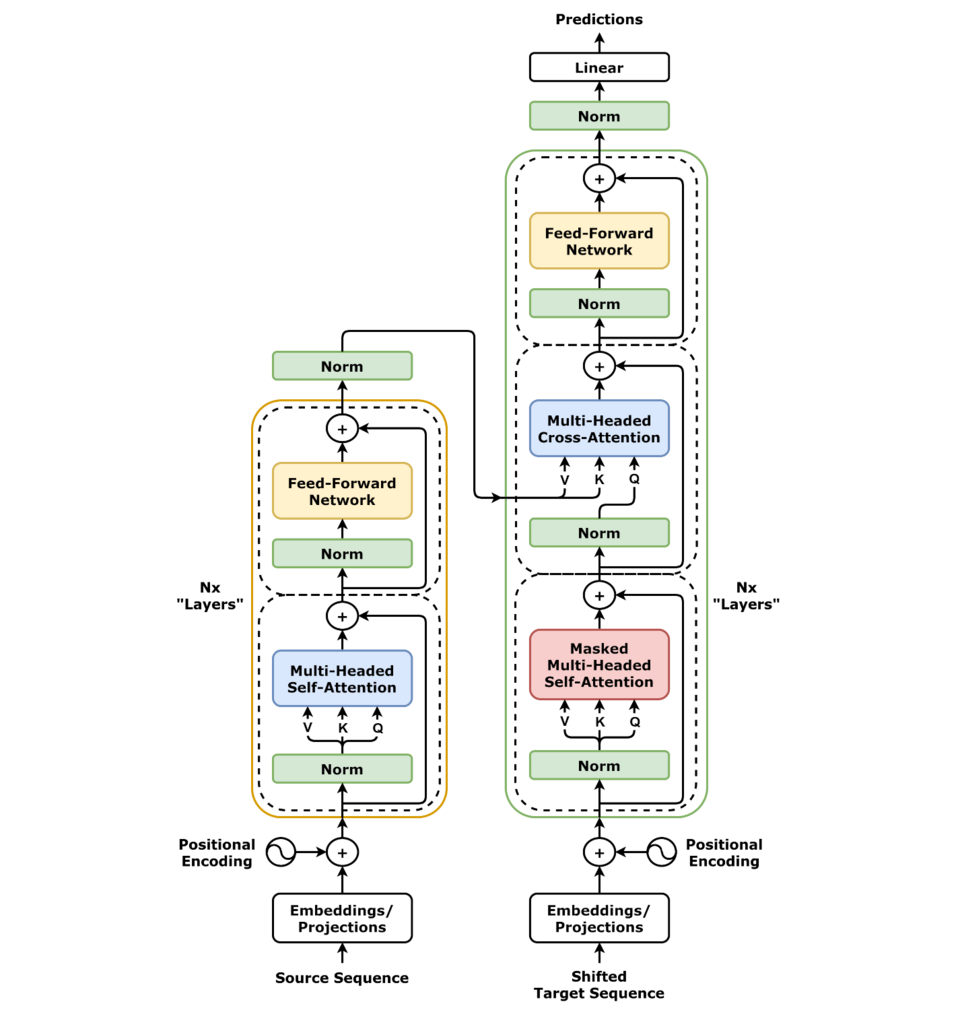 ng> (2026): kết hợp GQA với Mixture of Experts, giảm memory tới 85%
Ứng dụng thực tế trong các framework hiện đại
GQA đang được tích hợp vào hầu hết các framework phổ biến:
| Framework | Hỗ trợ GQA | Phiên bản |
|---|---|---|
| Transformers (Hugging Face) | Có | v4.30+ |
| LLaMA (Meta) | Mặc định | Llama 2, Llama 3 |
| JAX / Flax | Có | v0.4+ |
| TensorRT-LLM (NVIDIA) | Có | v0.8+ |
Với TensorRT-LLM, MQA/GQA có thể tăng tốc suy diễn lên đến 2x trên cùng phần cứng GPU so với MHA truyền thống.
MQA trong nền tảng Cloud và thiết bị biên
Bên cạnh lợi ích về memory, MQA/MQA giúp giảm chi phí triển khai LLM trên các nền tảng cloud và thiết bị biên (edge devices). Khi một mô hình được triển khai với MQA, kích thước bộ nhớ GPU cần thiết có thể giảm tới 60-70%, cho phép chạy các mô hình 10B+ trên thiết bị có 24GB VRAM như RTX 3090 hoặc A10.
- Giảm chi phí triển khai trên AWS/GCP/Azure: có thể dùng instance nhỏ hơn
- Tăng số lượng mô hình đồng thời trên cùng GPU (model parallelism)
- Lợi lợi thế khi áp dụng kv cache offloading sang CPU/CPU-pinning
Đối với các nhà cung cấp dịch vụ AI như OpenAI hay DeepMind, việc áp dụng MQA và GQA là chìa khóa để triển khai các mô hình tỷ tỷ tham số với chi phí vận hành tối ưu. Các công ty thường kết hợp MQA với kỹ thuật RoPE (Rotary Position Embedding) và FlashAttention để tối đa hóa tốc độ truyền thống.
Kết luận: MQA/GQA là tương lai của LLM inference
Multi-Query Attention và Grouped-Query Attention đã chứng tỏ là hai công nghệ tiết kiệm memory mang lại giá trị thiết thực cho việc triển khai LLM. MQA cung cấp tối đa hóa tốc độ nhưng có thể mất độ chính xác; GQA đưa ra sự cân bằng hoặc hợp lý. Khi hạ tầng GPU ngày càng trở nên phổ biến hơn (H100, B200, hoặc các chip AI tùm xung quanh), việc tối ưu memory thông qua MQA/GQA trở thành yếu tố then chất để triển khai LLM mở rộng. Các nghiên cứu tiếp theo đang tập trung vào Sparse Attention kết hợp MQA, nhằm đưa memory tiết kiệm tiếp đến vị trí tiếp theo.
Tham khảo: FlashAttention: Fast and Scalable Attention, GQA: Training Generalized Multi-Query Transformer.