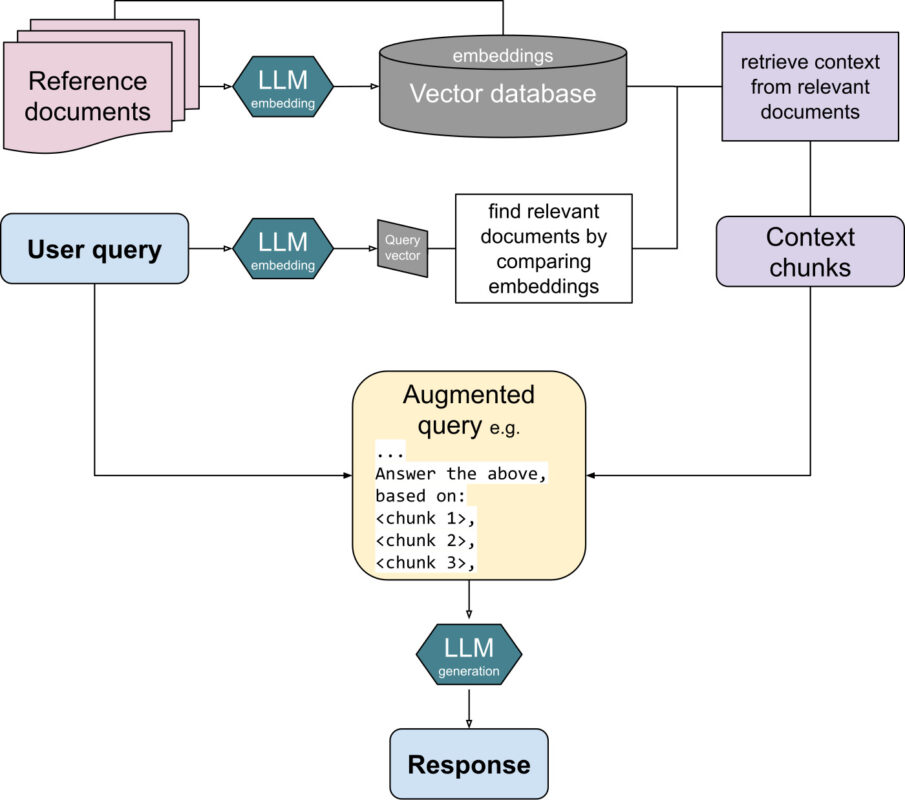
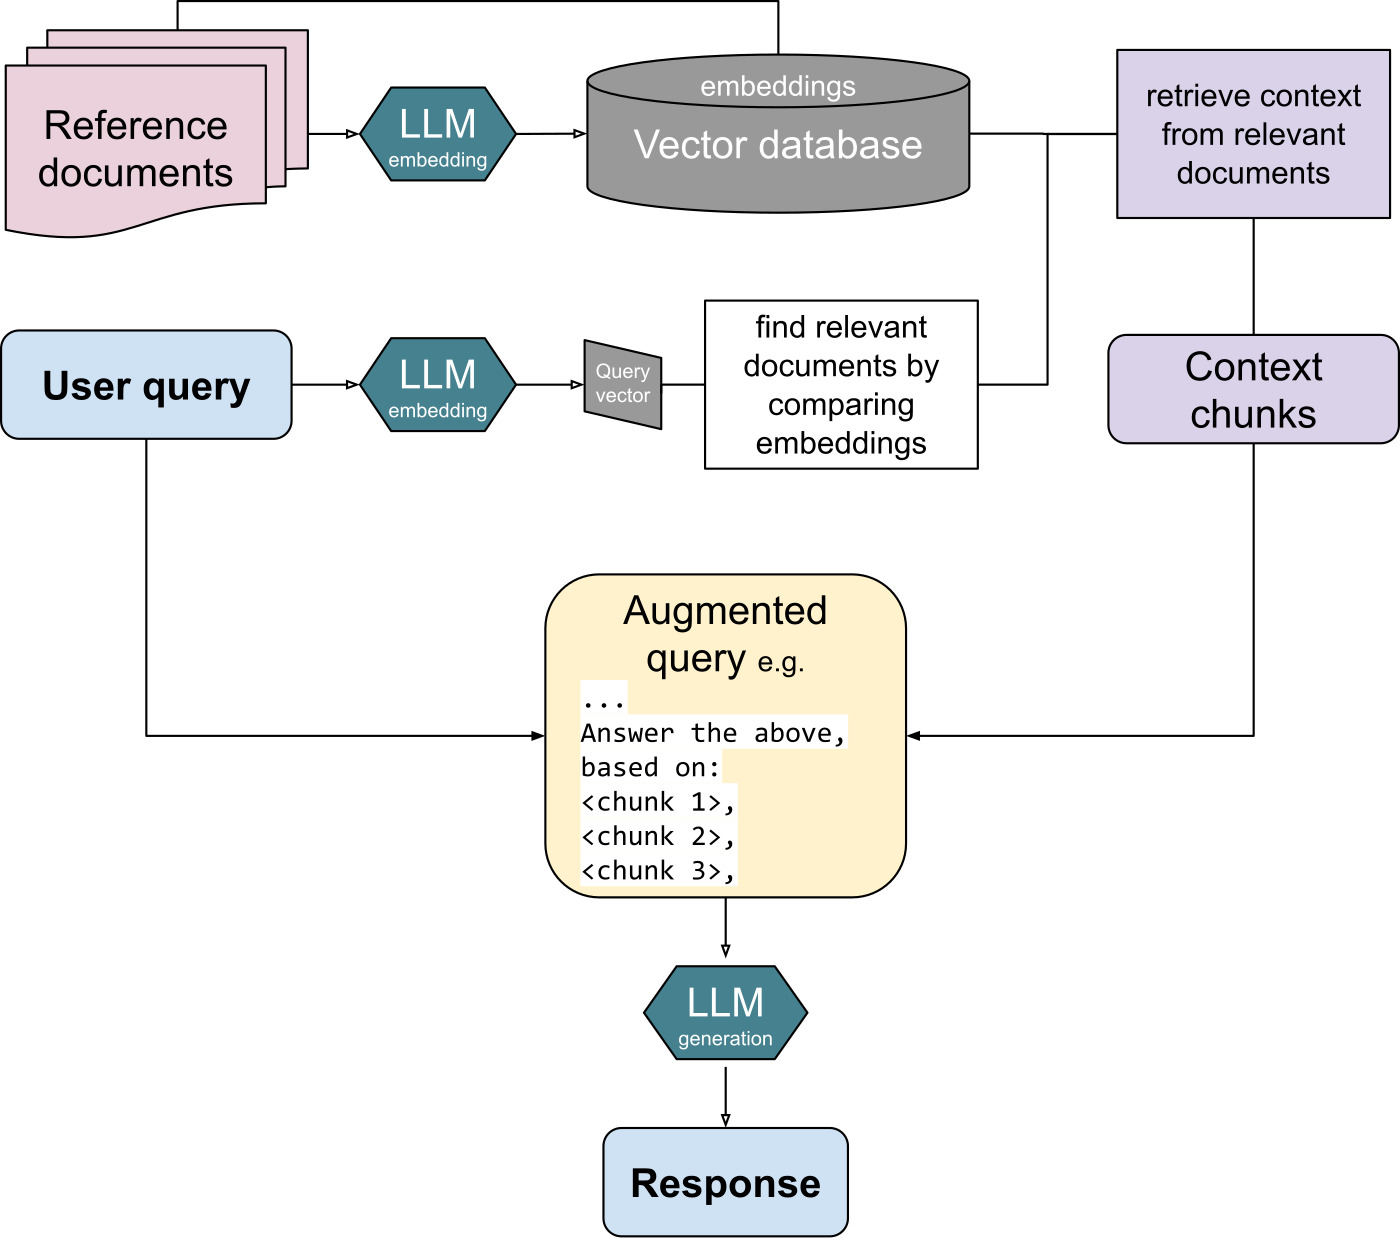
LlamaIndex là framework mã nguồn mở viết bằng Python (và TypeScript) giúp kết nối dữ liệu riêng tư của doanh nghiệp với các mô hình ngôn ngữ lớn. Nếu bạn đã nghe về RAG (Retrieval-Augmented Generation), LlamaIndex là một trong những thư viện phổ biến nhất để hiện thực hoá nó: thu thập tài liệu, chia nhỏ, tạo embedding, truy vấn ngữ nghĩa và đưa kết quả làm ngữ cảnh cho LLM trả lời.
Framework do Jerry Liu khởi tạo và phát triển từ năm 2022, hiện được duy trì tại kho run-llama/llama_index trên GitHub. Dự án nhận được nhiều sao trong cộng đồng khoa học dữ liệu và được dùng trong nhiều sản phẩm thương mại.
Vấn đề cần giải quyết
Mô hình ngôn ngữ lớn chỉ biết những gì được huấn luyện tới một thời điểm, và tuyệt đối không biết dữ liệu nội bộ của công ty bạn. Ba phương án phổ biến để giải quyết:
- Fine-tuning: tốn kém tính toán, cần dữ liệu lớn và không giải quyết được vấn đề dữ liệu thay đổi hằng ngày.
- Prompt dài: vượt giới hạn context và tốn token vô ích.
- RAG: lấy đúng đoạn tài liệu liên quan rồi đưa vào prompt. Rẻ hơn, cập nhật tức thì, và truy vết được nguồn.
LlamaIndex tập trung vào RAG và những kiến trúc nâng cao hơn: agent dùng tool, cây hỏi đáp nhiều bước, workflow điều phối nhiều tác vụ.
Pipeline cơ bản với vài dòng code
Ví dụ nạp thư mục PDF và hỏi dạng câu hỏi tự nhiên:
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader

documents = SimpleDirectoryReader("data").load_data()
index = VectorStoreIndex.from_documents(documents)

query_engine = index.as_query_engine()
response = query_engine.query("Quy trình nghỉ phép là gì?")
print(response)
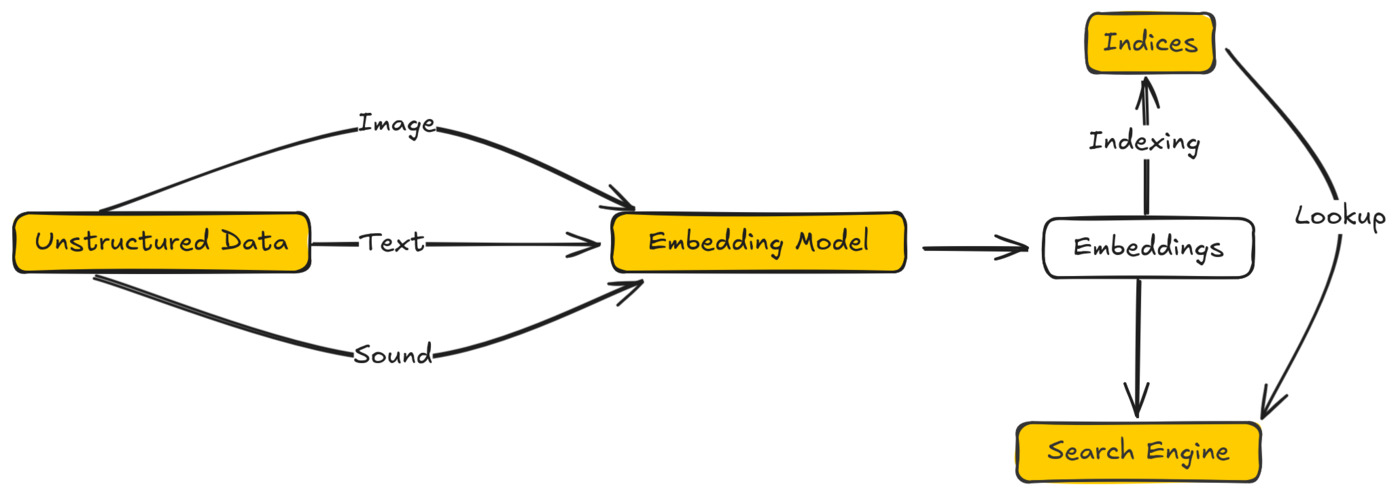
Ba dòng này tạo ra một chuỗi xử lý hoàn chỉnh. Bên trong VectorStoreIndex thực hiện: chunking văn bản, gọi embedding model để sinh vector, lưu vào vector store, rồi khi có câu hỏi thì nhúng câu hỏi, tìm các chunk gần nhất theo độ tương đồng cosine, ghép chúng thành ngữ cảnh và đưa cho LLM sinh câu trả lời.
Bốn lớp trừu tượng quan trọng
| Khái niệm | Vai trò |
|---|---|
| Document / Node | Đơn vị văn bản sau khi chia nhỏ; Node là mức tối thiểu được index |
| Index | Cấu trúc lưu trữ toàn bộ dữ liệu đã xử lý, có thể là vector store hoặc cây |
| Retriever | Đối tượng trả về các Node liên quan tới một truy vấn |
| Query Engine / Chat Engine | Đóng gói retriever + prompt + LLM thành một interface gọi được |
Tinh chỉnh truy vấn: có đáp án từng phần
Retriever mặc định dùng vector similarity, nhưng đây chưa phải lựa chọn tốt nhất cho mọi câu hỏi. LlamaIndex cung cấp nhiều chiến lược kết hợp:
- Hybrid search: kết hợp BM25 (từ khóa) với vector search (ngữ nghĩa), cho kết quả tốt hơn rõ rệt khi câu hỏi chứa mã số, tên riêng.
- Query decomposition: tách câu hỏi phức tạp thành các câu hỏi con rồi hợp nhất câu trả lời.
- Reranking: đưa top 20 candidate qua một mô hình chấm điểm mạnh hơn để chọn lại 5 chunk tốt nhất.
- Metadata filtering: lọc theo nguồn, ngày, phòng ban trước khi truy vấn.
Trích dẫn nguồn và chống bịa
Đây là yêu cầu thường gặp khi đưa RAG vào sản phẩm: người dùng phải biết câu trả lời dựa trên tài liệu nào. LlamaIndex hỗ trợ chế độ CitationQueryEngine gắn mã nguồn cho từng đoạn, đồng thời cho phép thiết lập chuỗi prompt bắt mô hình chỉ trả lời dựa trên ngữ cảnh và nói rõ khi không đủ thông tin.
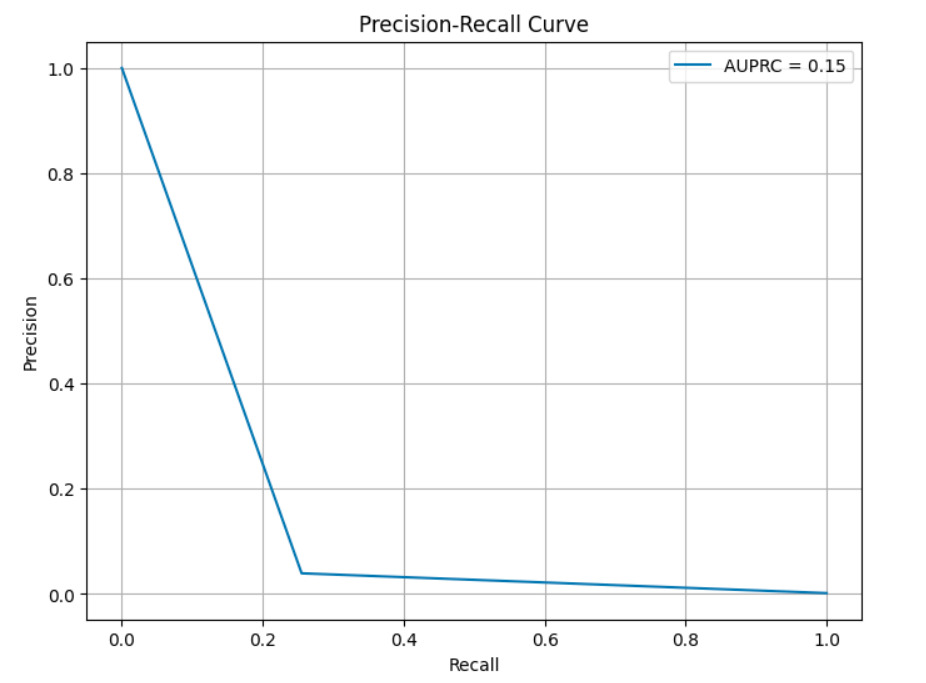
Chỉ số đánh giá quan trọng gồm recall@k (tỉ lệ đoạn đúng có trong top-k kết quả) và faithfulness (mức độ bám sát nội dung nguồn). Cần xây bộ câu hỏi kiểm thử với câu trả lời có sẵn rồi đo định kỳ sau mỗi lần đổi chunk size hay embedding model.
Tích hợp hệ sinh thái
- LLM: OpenAI, Anthropic, Gemini, Ollama, Hugging Face qua lớp trừu tượng chung.
- Vector store: Chroma, Qdrant, Milvus, Pinecone, Weaviate, pgvector.
- Nguồn dữ liệu: PDF, HTML, Markdown, Google Drive, Notion, SQL database, API.
- Framework web:
llama-indexcó sẵn adapter cho LlamaIndex Workflows và tích hợp được với LangChain khi cần.
Tài liệu chi tiết nằm tại docs.llamaindex.ai, còn các notebook mẫu chạy được có ở thư mục ví dụ trong kho mã nguồn.
Khi nào nên chọn LlamaIndex
LlamaIndex hợp lý khi dữ liệu của bạn là tài liệu văn bản phong phú cần truy vấn ngữ nghĩa và bạn muốn kiểm soát sâu từng bước của pipeline. Nếu bài toán chỉ là gọi API LLM đơn giản, framework sẽ là thừa. Với hệ thống agent phức tạp cần điều phối nhiều bước, vòng lặp gọi tool và quản lý trạng thái, cân nhắc framework chuyên agent như LangGraph. Dù sao, LlamaIndex vẫn là lớp truy xuất dữ liệu đáng tin cậy bên trong cả hai kiến trúc.