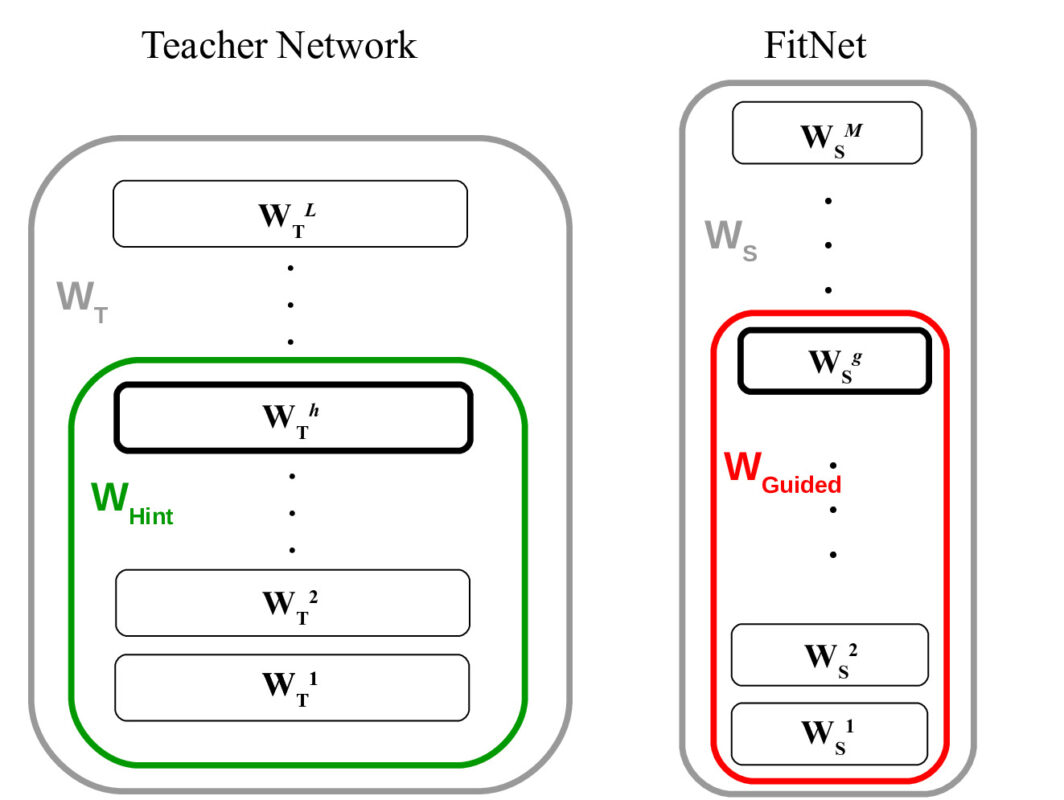
Knowledge Distillation (cất giữ tri thức) là quá trình chuyển kiến thức từ một mô hình lớn sang một mô hình nhỏ hơn. Bất ngờ thay, người học nhỏ không chỉ sao chép câu trả lời cuối cùng mà học được cả cách mô hình lớn phân bố xác suất giữa các lớp. Bài viết này giải thích nguyên lý, công thức toán học, vai trò của nhiệt độ và ứng dụng thực tế.
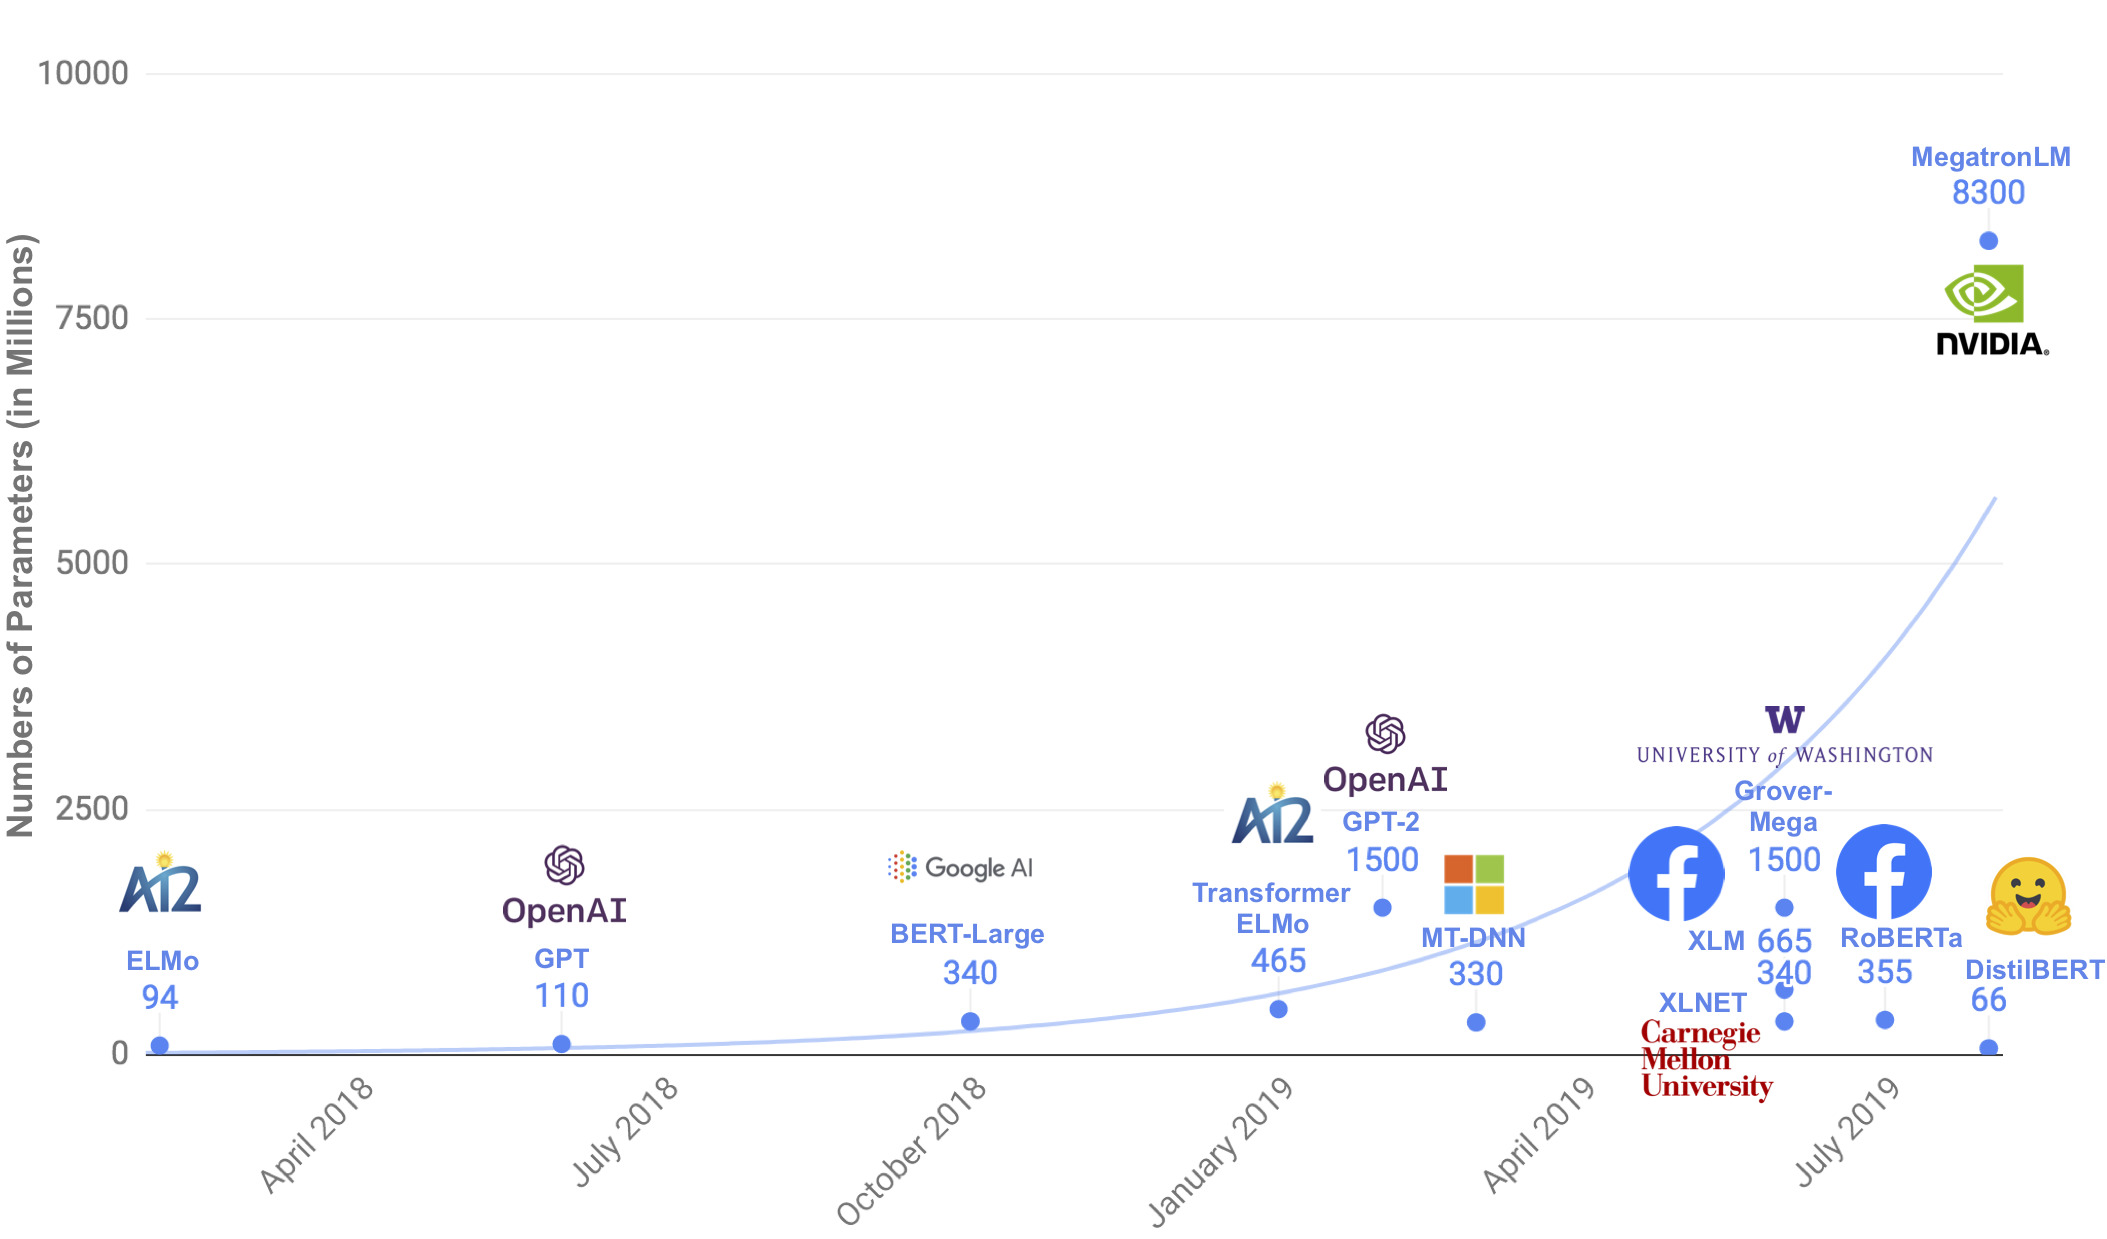
Đặt vấn đề từ áp lực triển khai. Một mô hình ngôn ngữ lớn có hàng trăm tỉ tham số cho kết quả xuất sắc, nhưng không thể chạy trên điện thoại di động hay trong một ứng dụng chạy hoàn toàn trên thiết bị. Trong khi đó, một mô hình nhỏ chạy nhanh và rẻ nhưng lại thiếu chuyên môn.
Ý tưởng của Hinton và cộng sự rất trực giác: thay vì chỉ dạy mô hình nhỏ bằng đáp án đúng hoặc sai, hãy dạy nó bằng cách mô hình lớn phân bố xác suất — một thông tin giàu cảm xúc hơn nhiều.
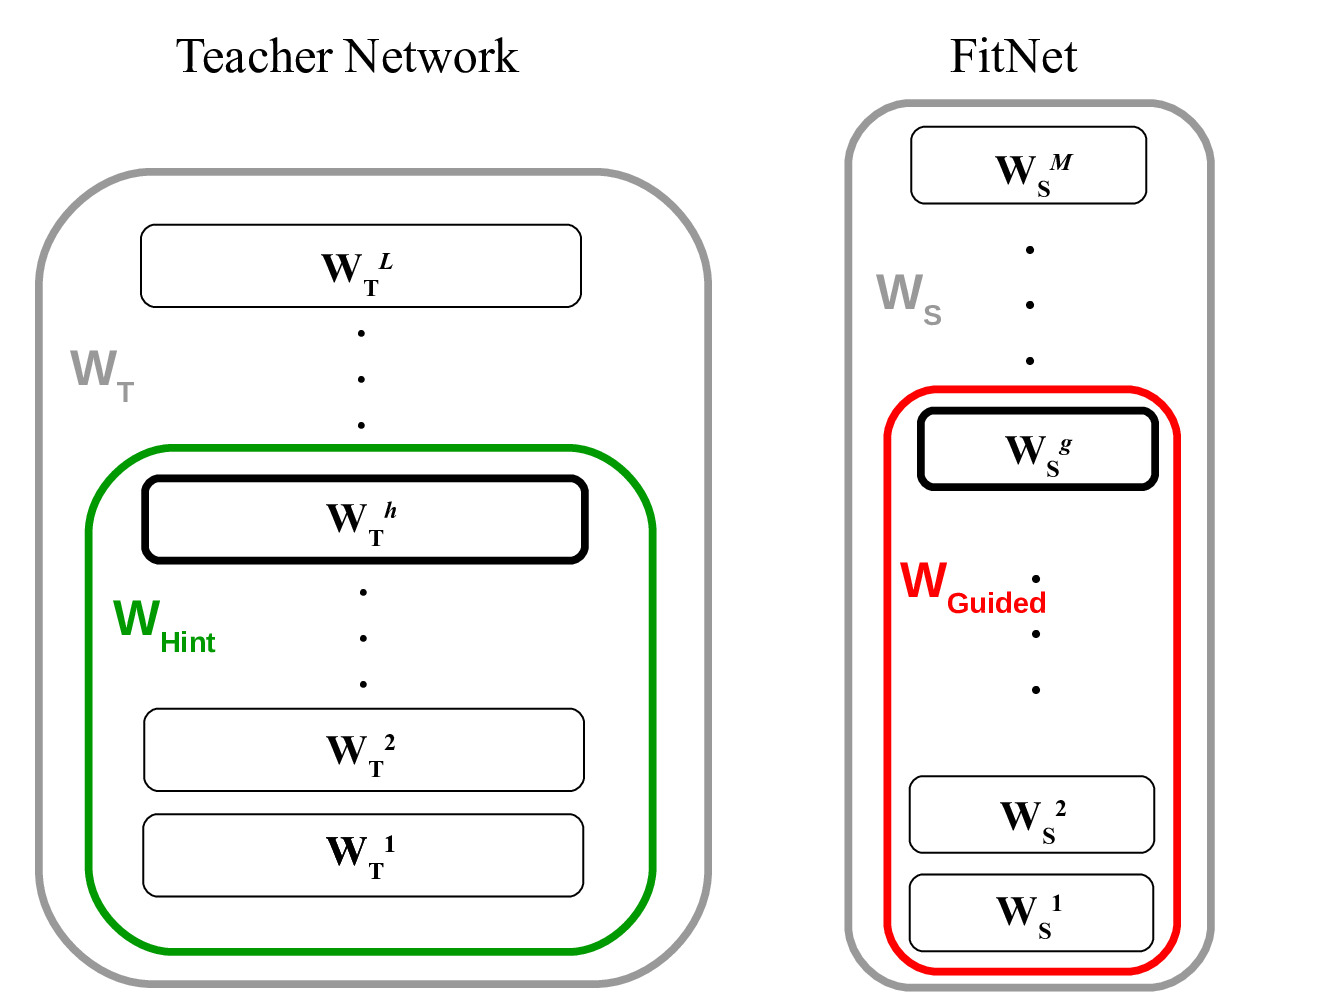
Tại sao mô hình nhỏ không học trực tiếp là đủ
Trực giác đầu tiên của nhiều người: dữ liệu thì đã có, mô hình nhỏ cũng có thể train trên chính dữ liệu đó, vậy cần chuyển gì?
Lý do nằm ở hiệu năng học, không phải dữ liệu. Khi cả hai mô hình đều train trên cùng tập dữ liệu với cùng nhãn cứng, mô hình nhỏ buộc phải tự suy luận toàn bộ cấu trúc phức tạp bên trong dữ liệu chỉ từ tín hiệu một phần nhị phân. Đây là bài toán vượt quá khả năng của mô hình nhỏ.
Mô hình lớn thì khác. Nó không chỉ cho biết lớp nào đúng, mà cho biết thứ hạng xác suất của tất cả các lớp còn lại. Giả sử một bức ảnh được phân loại là “mèo” với xác suất 0,9. Mô hình lớn có thể cho biết “fox” đứng thứ hai, “dog” thứ ba, còn “máy bay” gần như bằng không.
Thứ tự này chính là tri thức mà dữ liệu thô không chứa. Mô hình nhỏ học được từ đó một bản đồ về mức độ giống nhau giữa các lớp — thông tin này giúp nó học nhanh hơn và chính xác hơn nhiều so với chỉ dựa vào nhãn.
Cơ chế nhiệt độ softmax
Để truy xuất được phân bố mềm này, người ta dùng tham số nhiệt độ T trong hàm softmax:
y_i(x | t) = e^(z_i(x) / t) / SUM_j e^(z_j(x) / t)
Trong đó z_i(x) là logit thứ i. Với T bằng 1, đây chính là softmax tiêu chuẩn. Khi T lớn hơn 1, phân bố trở nên mềm hơn: xác suất của lớp đúng giảm xuống, trong khi các lớp còn lại được nâng lên. Chẳng hạn ở T bằng 4, xác suất 0,9 ban đầu có thể giảm xuống còn khoảng 0,5, phần còn lại được rải đều hơn.
Có một điểm tinh tế mà ít người chú ý: giá trị T dùng để tính cùng một hệ số tỷ lệ trong cả mô hình giáo viên và học viên. Vì vậy, các con số trong lập luận trên chỉ là minh hoạ — mô hình lớn và mô hình nhỏ luôn được so sánh ở cùng một nhiệt độ.
Hàm tổn thất
Mô hình học viên được huấn luyện để khớp với đầu ra của giáo viên bằng hàm tổn thất chéo entropy, với nhiệt độ cao cho cả hai bên:
E(x | t) = - SUM_i y_hat_i(x | t) * log( y_i(x | t) )
Trong đó y_hat là phân bố từ giáo viên và y là phân bố từ học viên. Nếu bạn có cả nhãn thật, bạn có thể cộng thêm một thành phần entropy chéo giữa đầu ra mô hình và nhãn, với trọng số alpha. Hàm tổn thất tổng thể trở thành:
E = t^2 * SUM_i y_hat_i(x|t) * log(y_i(x|t)) + alpha * SUM_i y_bar_i * log(y_i(x|1))
Hệ số t^2 ở thành phần đầu không phải chi tiết vụn vặt. Vì gradient của hàm tổn thất tỷ lệ nghịch với t, mà thành phần này lại tăng theo t, hai hiệu ứng triệt tiêu nhau và giữ cho thang độ lớn gradient ổn định. Bỏ qua hệ số này sẽ khiến tối ưu hoá trở nên bất ổn định khi nhiệt độ cao.
Vì sao nhiệt độ cao lại giúp ích
Có ba lý do kỹ thuật, tất cả đều liên quan đến thống kê:
- Tăng entropy đầu ra. Phân bố mềm mang lại nhiều thông tin hơn cho học viên so với nhãn cứng một điểm.
- Giảm phương sai gradient. Gradient giữa các bản ghi khác nhau thay đổi ít hơn, nên tín hiệu học ổn định hơn.
- Cho phép tốc độ học cao hơn. Chính nhờ giảm phương sai đó mà thuật toán chịu được learning rate lớn, rút ngắn đáng kể thời gian huấn luyện.
Nói cách khác, nhiệt độ cao không chỉ là kỹ thuật giữ ổn định — nó trực tiếp làm cho việc học dễ hơn.
Phân biệt với model compression
Đây là điểm gây nhầm lẫn nhiều nhất. Model compression (nén mô hình) giảm kích thước của chính mô hình lớn mà không huấn luyện mô hình mới, thường bằng cách lượng tử hoá trọng số: giữ nguyên kiến trúc và số tham số danh nghĩa, nhưng giảm số bit trên mỗi tham số.
Trên thực tế, ranh giới này mờ hơn vẻ ngoài. Giả sử các logit có trung bình bằng không, có thể chứng minh rằng model compression chỉ là một trường hợp đặc biệt của knowledge distillation. Gradient của hàm tổn thất KD theo logit của mô hình học viên có dạng:
(1/t) * ( y_i - y_hat_i )
Với các giá trị t lớn, ta xấp xỉ được rồi rút gọn về dạng (z_i - z_hat_i) / (N * t^2), và dưới giả định trung bình bằng không, biểu thức này trở thành (1/2) * (z_i - z_hat_i)^2 — chính là hàm tổn thất khớp logit mà model compression sử dụng.
Nói ngắn gọn: cùng một nguyên lý toán học, chỉ khác ở tầng hiện thực.
Ứng dụng thực tế nổi bật
DistilBERT
Ứng dụng nổi tiếng nhất là DistilBERT, phiên bản rút gọn của BERT do cùng nhóm Hugging Face phát triển. Nhờ cắt bớt một phần ba số tầng, DistilBERT giữ được khoảng 97% hiệu năng của BERT trên bộ dữ liệu GLUE, chạy nhanh hơn khoảng 60% và nhỏ hơn khoảng 40% — trong khi vẫn dùng cùng kiến trúc Transformer và chung một ngôn ngữ với mô hình giáo viên.
Ứng dụng khác
Kiến trúc này đã được áp dụng rộng rãi trong nhận dạng đối tượng, mô hình âm thanh và xử lý ngôn ngữ tự nhiên. Gần đây nó còn được đưa vào mạng nơ-ron đồ thị, cho dữ liệu không lưới. Biến thể Reverse Knowledge Distillation đảo chiều, truyền tri thức từ mô hình nhỏ sang mô hình lớn, cũng đã được nghiên cứu.
Lưu ý thực tế: thành công hay không phụ thuộc mạnh vào việc giáo viên và học viên dùng cùng họ không gian đầu vào và cùng hệ thống mã hoá. Nếu học viên dùng bộ tokenizer khác, bài toán trở nên khó hơn nhiều. Với các mô hình sinh văn bản, việc lựa chọn dữ liệu truyền tải (unlabeled data) và thiết kế hàm tổn thất là những quyết định then chốt, phức tạp hơn đáng kể so với phân loại ảnh.
Đánh giá
Knowledge distillation có những ưu điểm rõ ràng: không cần thay đổi kiến trúc triển khai, tận dụng được công sức đã bỏ ra huấn luyện mô hình lớn, và cho phép tùy biến mức độ nén bằng cách điều chỉnh nhiệt độ cũng như kích thước mô hình học.
Rủi ro lớn nhất nằm ở suy diễn sai: nếu mô hình giáo viên có thành kiến sai, học viên thừa hưởng luôn những thành kiến đó. Với dữ liệu thiếu chú ý hay nhãn sai, kỹ thuật này có thể khuếch đại lỗi thay vì sửa chữa. Chất lượng của mô hình giáo viên là trần trên của chất lượng mô hình học viên.
Một lưu ý về chi phí: toàn bộ quy trình bắt đầu từ việc huấn luyện mô hình lớn, nên tổng chi phí tính toán không hề rẻ hơn. Lợi ích nằm ở chi phí sau đó — triển khai và suy luận rẻ hơn hàng trăm lần trên phần cứng yếu.
Kết luận
Knowledge distillation cho thấy một điều thú vị: giá trị của dữ liệu huấn luyện không nằm ở nhãn đúng-sai, mà ở cấu trúc xác suất mà một mô hình đủ mạnh tạo ra. Một mô hình lớn biết không chỉ con mèo trông thế nào, mà còn biết nó khác con cáo bao xa, và khác máy bay ra sao. Chuyển toàn bộ phần tri thức đó — chứ không chỉ phần đáp án — cho mô hình nhỏ chính là ý nghĩa của kỹ thuật cất giữ tri thức.