Whisper là gì? Đây là mô hình nhận dạng giọng nói mã nguồn mở do OpenAI giới thiệu, nổi tiếng nhờ độ chính xác cao, hỗ trợ đa ngôn ngữ và khả năng chuyển tiếng trực tiếp, dịch thuật và nhận dạng giọng nói sang văn bản ngay trên máy tính của người dùng. Bài viết này đi từ lịch sử phát triển của bài toán nhận dạng giọng nói, giải thích kiến trúc của Whisper, và chỉ ra những điểm cần lưu ý khi đưa mô hình này vào sản phẩm thực tế.
Nhận dạng giọng nói đã đi được bao xa
Nghiên cứu nhận dạng giọng nói máy, hay ASR, là một lĩnh vực của ngôn ngữ học tính toán với mục tiêu chuyển lời nói thành văn bản hoặc các dạng có thể diễn giải. Ngày nay bài toán này xuất hiện ở hai dạng ứng dụng rất quen thuộc: giao diện điều khiển bằng giọng nói, nơi người dùng nói và thiết bị nghe rồi thực hiện, và các ứng dụng năng suất như tìm kiếm trong kho bản ghi âm, tạo bản chép lời hay gõ bằng giọng nói.
Hành trình đi lại khá dài. Năm 1952, nhóm nghiên cứu tại phòng thí nghiệm Bell xây dựng hệ thống Audrey nhận dạng chữ số cho một người nói duy nhất, với cách tiếp cận là định vị các formant trong phổ công suất của mỗi đoạn âm thanh. Năm 1962, máy Shoebox của IBM với 16 từ ra mắt tại Hội chợ Thế giới, và năm 1966, Fumitada Itakura và Shuzo Saito đề xuất kỹ thuật mã hóa tuyến tính dự đoán, vẫn là nền tảng của nhiều bộ mã hóa âm thanh ngày nay.
Cuối những năm 1960, Raj Reddy ở Đại học Stanford là người đầu tiên làm việc về nhận dạng giọng nói liên tục, khi các hệ thống trước đó bắt người dùng phải ngừng lại sau mỗi từ. Ông cũng là người phát minh thuật toán warping thời gian động, xử lý âm thanh bằng cách chia thành các khung ngắn khoảng 10 mili giây. Vấn đề lớn vào thời điểm đó là độc lập với người nói vẫn chưa được giải quyết.
Mô hình ẩn Markov thay đổi cách tiếp cận
Ở cuối những năm 1960, Leonard Baum xây dựng toán học cho chuỗi Markov tại Viện Phân tích Quốc phòng. Một thập kỷ sau đó, tại Carnegie Mellon, James Baker bắt đầu dùng mô hình ẩn Markov cho nhận dạng giọng nói. Mô hình ẩn Markov cho phép các nhà nghiên cứu kết hợp nhiều nguồn tri thức, như âm thanh học, ngôn ngữ và cú pháp, vào cùng một mô hình xác suất thống nhất.
Đến giữa những năm 1980, nhóm của Fred Jelinek tại IBM tạo ra máy đánh máy điều khiển bằng giọng nói tên Tangora, xử lý được từ vựng 20 nghìn từ. Cách tiếp cận thống kê của Jelinek không cố sao chép quá trình não bộ người sử dụng mà thay vào đó dồn trọng tâm vào mô hình hoá xác suất. Nhóm này cũng độc lập phát hiện ra việc dùng mô hình ẩn Markov cho bài toán này.
Cách tiếp cận này gây tranh cãi với các nhà ngôn ngữ học vì mô hình ẩn Markov quá đơn giản để nắm bắt nhiều đặc điểm của ngôn ngữ tự nhiên. Dù vậy, nó vẫn chứng minh là một cách cực kỳ hữu ích để gom nhiều nguồn thông tin lại. Sự bùng nổ của học sâu và dữ liệu lớn sau này đã thay đổi hoàn toàn bức tranh này.
Whisper dùng kiến trúc chuyển đổi toàn bộ âm thanh
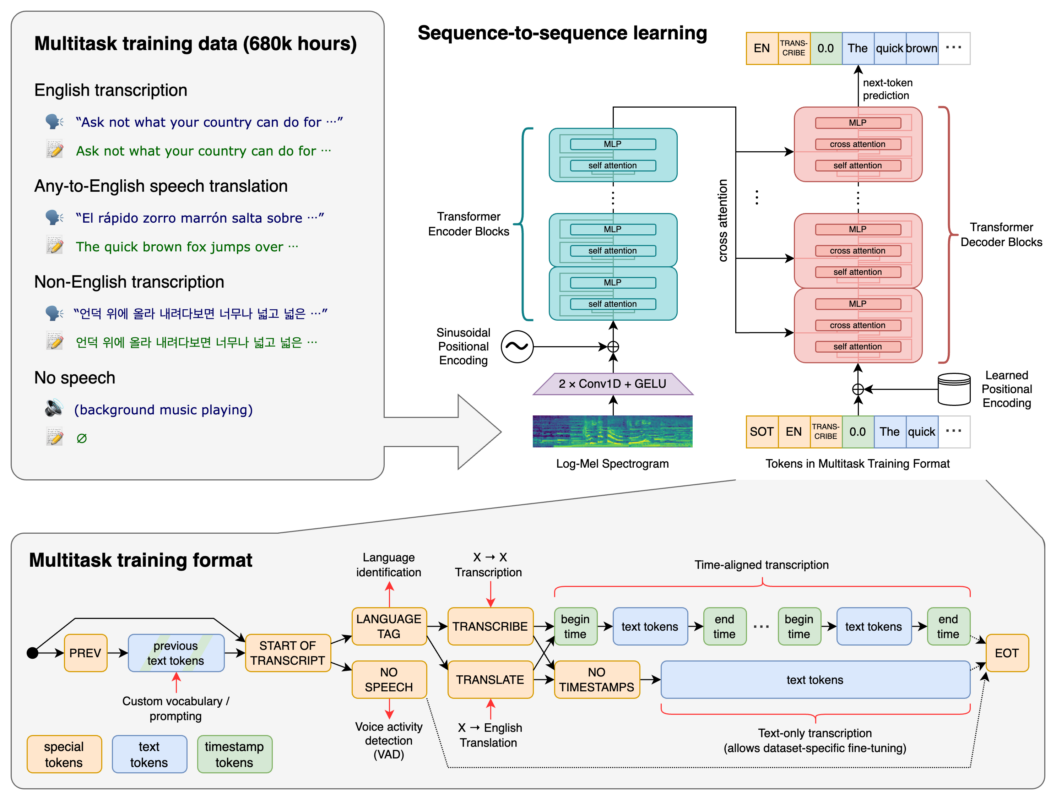
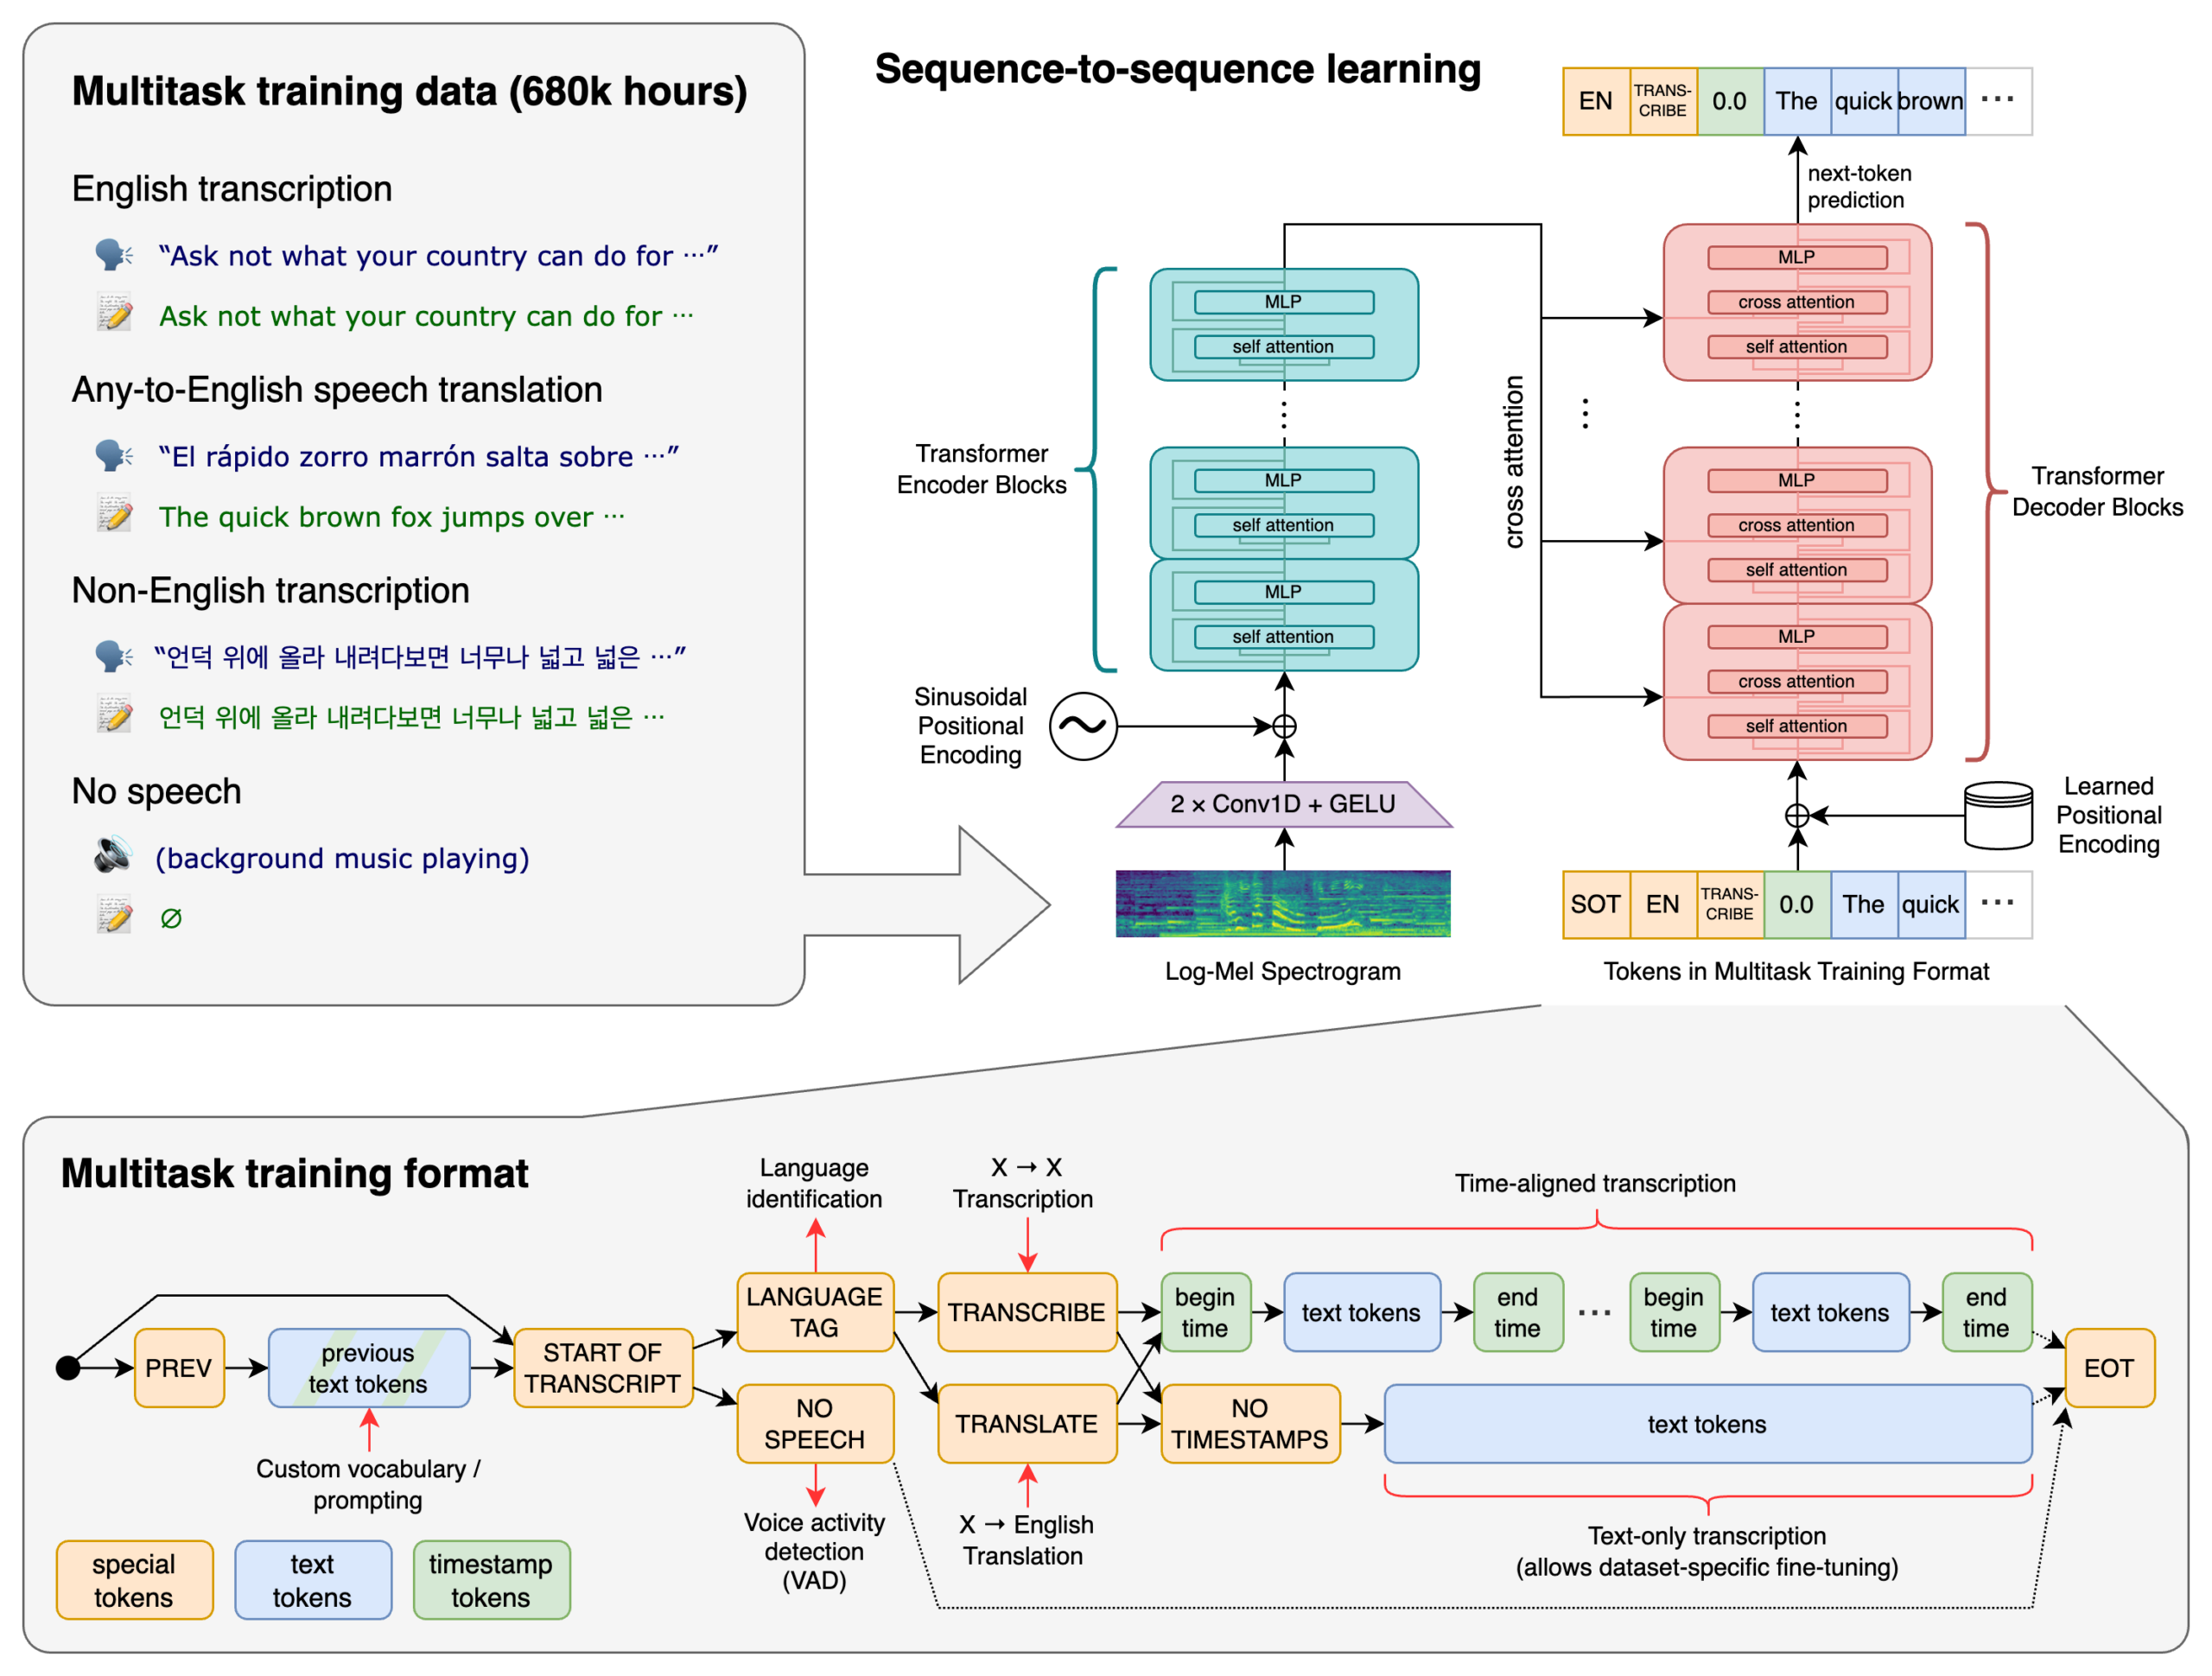
Khác với những hệ thống truyền thống xử lý từng khung âm thanh rồi ghép chuỗi từ, Whisper coi toàn bộ đoạn âm thanh là một đơn vị và chuyển đổi nó thành chuỗi văn bản trong một lần, tức là mô hình chuyển đổi trực tiếp từ âm thanh sang văn bản. Cách tiếp cận này khớp với mối quan hệ có thật giữa âm thanh và ngữ nghĩa, đồng thời loại bỏ được phần lớn độ phức tạp của giai đoạn sau nhận dạng.
Kiến trúc của mô hình được thể hiện rõ trong sơ đồ công bố: một bộ mã hóa tiêu biểu thụ âm thanh thành biểu diễn nén, bộ dự đoán ngôn ngữ ở đầu vào để tự nhận diện thứ tiếng nói, và bộ giải mã sinh ra văn bản. Nhờ đó cùng một mô hình xử lý được nhiều ngôn ngữ và nhiều giọng vùng miền mà không cần huấn luyện riêng cho từng trường hợp.
Điểm đáng chú ý về mặt kỹ thuật là mô hình học cả nhiệm vụ dò ngôn ngữ. Thay vì bắt người dùng khai báo trước họ đang nói tiếng gì, mô hình tự phát hiện điều đó từ âm thanh đầu vào. Đây là lý do một bản tải duy nhất chạy được cho hàng chục ngôn ngữ.
Ba triển khai phổ biến
Hệ sinh thái dự án mã nguồn mở quanh Whisper khá lớn. Whisper.cpp viết lại mô hình bằng C++, hỗ trợ chạy trên CPU và cả thiết bị nhúng, và là nền tảng cho phần lớn ứng dụng chạy cục bộ. Faster Whisper viết lại bằng Python dựa trên CTranslate2, tập trung vào tốc độ suy luận và tiết kiệm bộ nhớ. OpenAI cũng cung cấp dịch vụ chuyển giọng nói thành văn bản qua API với cùng bộ mô hình.
Việc chọn giữa chạy cục bộ hay gọi API là câu hỏi thực tế hàng ngày. Chạy cục bộ giữ dữ liệu không rời khỏi máy, hoạt động offline và không có chi phí theo lượt, nhưng đòi hỏi máy đủ mạnh. Gọi API cho kết quả ổn định hơn trên máy yếu và xử lý được âm thanh dài, đổi lại bạn gửi âm thanh ra ngoài và trả phí theo thời lượng.
Những giới hạn cần biết trước
Whisper mạnh nhưng không phải bài toán nào nó cũng giải quyết tốt. Chất lượng nhận dạng phụ thuộc nặng vào điều kiện thu âm: tiếng ồn nền, giọng vùng miền lạ, tiếng nói chồng lấn và thuật ngữ chuyên ngành đều có thể khiến văn bản đầu ra sai lệch. Với nội dung kỹ thuật, một thuật toán có thể bị chép thành một từ hoàn toàn khác mà người đọc không nhận ra.
Mô hình cũng có xu hướng bịa thêm nội dung ở các đoạn âm thanh gần như im lặng, và đôi khi tự thêm dấu câu, ngôn ngữ hoặc tên riêng mà người nói không hề đề cập. Với nội dung cần độ chính xác tuyệt đối như biên bản họp hay hồ sơ y tế, bước kiểm tra thủ công của con người vẫn là bước bắt buộc.
Nếu bạn cần tự động hoá quy trình chép lời hàng ngày, hãy bắt đầu bằng cách đo độ chính xác trên chính chất giọng của mình thay vì tin vào điểm số trên bảng xếp hạng. Chọn mô hình nhỏ hơn khi tốc độ là ưu tiên, chọn mô hình lớn hơn khi độ chính xác là ưu tiên, và luôn kiểm tra kết quả trên dữ liệu thật của mình trước khi đưa vào sản phẩm.
Tham khảo thêm: bài tổng quan về Speech recognition trên Wikipedia và kho mã nguồn chính thức của mô hình tại OpenAI Whisper trên GitHub.