HyperLogLog là gì? Cấu trúc dữ liệu xác suất để ước lượng unique
HyperLogLog (HLL) là một cấu trúc dữ liệu xác suất được thiết kế để ước lượng số phần tử khác nhau (cardinality) trong một luồng dữ liệu với sử dụng bộ nhớ rất thấp. Thay vì lưu trữ từng giá trị duy nhất như một Set thông thường, HLL chỉ cần khoảng log log N bit để đạt được độ chuẩn bị khoảng 2%, phù hợp cho việc đếm truy cập_unique, số địa chỉ IP phân biệt, hoặc số hành vi người dùng trên hệ thống lớn.
Điểm mạnh của HLL nằm ở tính chất mergeable: hai bản giură HLL có thể được hợp nhất mà không mất tính chính xác, cho phép tính toán cardinality phân tán trên nhiều shard hoặc nút trong hệ thống phân tán. Nhờ vậy HLL được tích hợp rộng rãi trong hệ thống lưu trữ phân tán như Redis, Apache Cassandra, và các engine streaming như Apache Flink hoặc Kafka Streams.
Nguyên lý hoạt động của HyperLogLog
Thuật toán HyperLogLog làm việc qua ba bước chính: băm, quan sát, và trung bình cộng điều chỉnh. Đầu vào (một giá trị như userID, địa chỉ IP) được băm bằng một hàm băm chất lượng (ví dụ MurmurHash hoặc xxHash) để tạo ra một chuỗi bit phân bố đều. Từ chuỗi hash này, ta lấy ra vài bit đầu tiên để xác định bucket (thùng) mà giá trị sẽ được xếp vào, và phần bit còn lại được dùng để đếm số lượng leading zeros (số bit 0 liên tiếp tính từ vị trí đó).
Giá trị ước lượng cardinality cho mỗi bucket được tính bằng 2^ρ trong đó ρ là số lượng leading zeros lớn nhất ghi nhận được trong bucket đó. Tuy nhiên, trung bình cộng trực tiếp của các giá trị 2^ρ sẽ tạo ra sai lệch lớn do phân bố không đều. HyperLogLog sửa lỗi này bằng cách sử dụng trung bình điều hòa thay cho trung bình cộng, cùng với các hệ số hiệu chỉnh sai lệch dựa trên số bucket (m). Công thức cuối cùng là:
E = α_m * m^2 * (Σ 2^-M[j])^-1
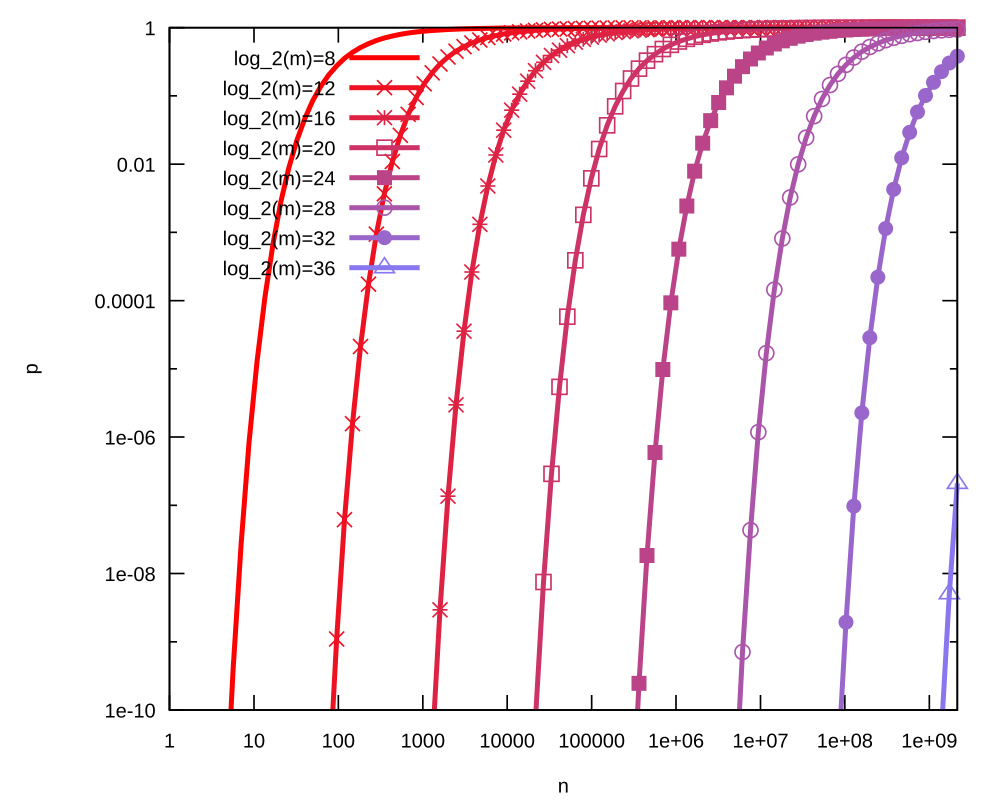
trong đó M[j] là giá trị lớn nhất của leading zeros trong bucket j, m là số bucket, và α_m là hằng số sửa bias phụ thuộc vào m (được tính toán từ một bảng tra giá trị). Với m đủ lớn (thường là 2^10 đến 2^14), sai số chuẩn của HLL < 1.04/√m.
Ưu điểm và ứng dụng thực tế
So với các phương pháp tối giản như lưu trữ Set trong bộ nhớ hoặc sử dụng bitmap, HyperLogLog giảm đáng kể lượng tài nguyên cần dùng đồng thời vẫn cho kết quả ước lượng chấp nhận được. Ví dụ, để đếm cardinality với sai số 1% ở mức một triệu giá trị khác nhau, HLL chỉ tốn khoảng 1,5KB bộ nhớ, trong khi một Set chính xác có thể tốn hàng chục megabyte.
Ứng dụng phổ biến của HLL bao gồm:
- Đếm truy cập_unique trang web hoặc API trong hệ thống thời gian thực.
- Ướt lượng số địa chỉ IP độc đáo trong lưu lượng mạng để phát hiện DDoS hoặc quét cổng.
- Tính chỉ số retention cohort trong sản phẩm digital: số người dùng quay lại sau ngày 1, 7, 30.
- Đếm số lượng транзакций hoặc đối tượng riêng biệt trong chuỗi khối (blockchain) mà không cần lưu trữ toàn bộ địa chỉ.
- Ướt lượng trong các hệ thống OLAP để tăng tốc truy vấn GROUP BY COUNT(DISTINCT …).
Trong hệ thống mã nguồn mở, Redis cung cấp các lệnh PFADD, PFCOUNT, và PFMERGE để thao tác với cấu trúc HyperLogLog trực tiếp. Các nhà phát triển có thể tạo một HLL mới bằng PFADD hll_key element1 element2 ... và truy vấn ước lượng cardinality bằng PFCOUNT hll_key. Nhờ tính chất mergeable, PFMERGE dest_hll src1_hll src2_hll cho phép hợp nhất nhiều HLL từ các shard khác nhau mà không mất độ chính xác.
Giới hạn và điểm cần lưu ý
Mặc dù hiệu quả, HyperLogLog không phù hợp cho các trường hợp cần đếm chính xác tuyệt đối hoặc khi cardinality rất thấp (dưới một vài trăm phần tử). Khi cardinality nhỏ, sai số tính theo phần trăm có thể lớn vì thuật toán được thiết kế tối ưu cho phạm vi số lượng rộng. Trong trường hợp này, các kỹ thuật đơn giản như bitmap kích thước nhỏ hoặc Set thông thường vẫn là lựa chọn tốt hơn.
Điểm lưu ý nữa là độ chính xác phụ thuộc vào chất lượng hàm băm: nếu hàm băm tạo ra phân bố bit không đều, kết quả ước lượng sẽ bị lệch. Do đó, trong triển khai thực tế nên dùng các hàm băm chuẩn, đã kiểm định như MurmurHash3, xxHash hoặc FarmHash, và tránh các hàm băm yếu có độ phân bố kém.
Cuối cùng, HLL chỉ cung cấp ước lượng, không thể liệt kê các phần tử duy nhất. Nếu ứng dụng cần biết chính xác ai là những người dùng duy nhất hoặc địa chỉ IP cụ thể nào, cần kết hợp với một kho lưu chi tiết khác, chẳng hạn ghi log theo thời gian thực vào một hệ thống như Cassandra hoặc Elasticsearch.
Nguồn tham khảo: