Speculative decoding (giải mã suy đoán) là kỹ thuật tăng tốc sinh văn bản cho Large Language Model (LLM) mà không làm thay đổi phân phối đầu ra. Ý tưởng cốt lõi: một draft model nhỏ đề xuất nhiều token cùng lúc, sau đó target model lớn kiểm tra và chấp nhận token hợp lệ trong một forward pass duy nhất — giảm độ trễ do bộ nhớ (memory-bandwidth bound) vốn là nút thắt cổ chai của autoregressive decoding.
Cơ chế hoạt động
Autoregressive decoding truyền thống sinh token lần lượt: mỗi bước phải nạp toàn bộ tham số mô hình từ HBM vào cache GPU — quá trình bị giới hạn bởi băng thông bộ nhớ chứ không phải sức tính toán. Speculative decoding khai thách quan sát: chấm điểm song song nhiều token từ draft model tốn khoảng bằng độ trễ sinh 1 token từ target model (Chen et al., DeepMind 2023, arXiv:2302.01318).
Quy trình:
- Draft model đề xuất K token tiếp theo (K thường là 4–8).
- Target model chạy một lần forward để tính xác suất cho cả K vị trí đó.
- Áp dụng modified rejection sampling: so sánh phân phối draft và target, chấp nhận token nếu xác suất target ≥ draft, ngược lại sample lại từ phân phối hiệu chỉnh.
- Kết quả: lossless — phân phối đầu ra y hệt target model độc lập.
Các biến thể chính và kết quả đo được
| Phương pháp | Paper / Năm | Speedup báo cáo | Điểm đặc trưng |
|---|---|---|---|
| Speculative Decoding gốc | Leviathan et al. 2022 (arXiv:2211.17192) | 2×–3× trên T5-XXL | Cần draft model riêng; identical outputs |
| Speculative Sampling (DeepMind) | Chen et al. 2023 (arXiv:2302.01318) | 2×–2.5× Chinchilla 70B | Chứng minh độ trễ song song ≈ 1 token target |
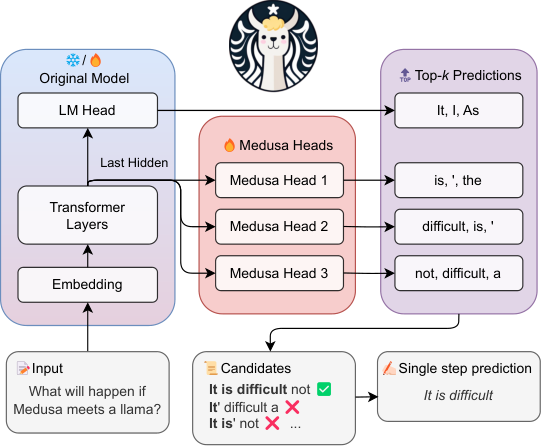
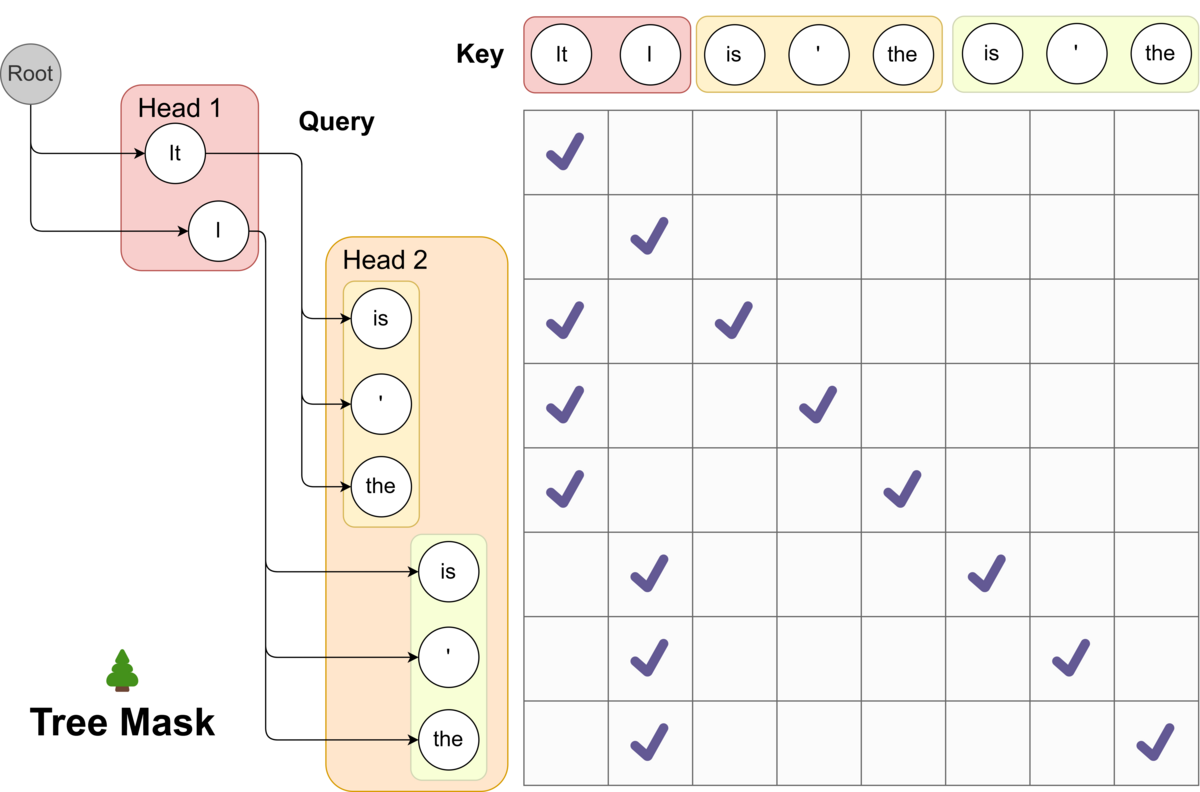
| Medusa | Cai et al. 2024 (arXiv:2401.10774) | 2.2×–2.8× | Thêm decoding head, tree attention; không cần draft model riêng |
| EAGLE | Li et al. 2024 (arXiv:2401.15077) | 2.7×–3.5× | Dự đoán ở feature level (second-to-top layer) |
| EAGLE-2 | Li et al. 2024 (arXiv:2406.16858) | 3.05×–4.26× | Context-aware dynamic draft tree; nhanh hơn EAGLE 20–40% |
| Lookahead Decoding | Fu et al. 2024 (arXiv:2402.02057) | 1.8× MT-bench, 4× multi-GPU | Không cần draft model, không data store, kiểu Jacobi n-gram |
| MTP (Multi-Token Prediction) | DeepSeek-V3 2024 (arXiv:2412.19437) | 1.8× TPS | Dự đoán 2 token; acceptance rate token 2 đạt 85–90% |
Nguồn so sánh: Leviathan 2022, Chen 2023, Medusa, EAGLE, EAGLE-2, Lookahead, DeepSeek-V3.
Hỗ trợ trong inference engine phổ biến
Ba engine chính đã tích hợp sẵn, cho phép bật chỉ qua cờ cấu hình:
- vLLM:
--speculative-model,--num-speculative-tokens, hỗ trợ EAGLE, MTP, Draft Model, PARD, N-Gram, Suffix Decoding, MLP. Metric per-request:--per-request-spec-decode-metrics. Xem tài liệu vLLM. - SGLang:
--speculative-algorithm EAGLE3|EAGLE|MTP|NGRAM|STANDALONE|UNO|DFLASH. Xem tài liệu SGLang. - TensorRT-LLM: Draft-target, NGram, Medusa Tree, ReDrafter, EAGLE, Lookahead. Xem hướng dẫn NVIDIA.
- llama.cpp: PoC speculative sampling (PR #2926), tree-based sampling (PR #3624), stochastic speculative sampling (PR #5625), cờ
--n-gpu-layers-draftcho draft model trên GPU riêng. Xem PR #2926.
Khi nào nên dùng
- Batch nhỏ / QPS thấp (serving thực tế): decoding bị memory-bound → speculative decoding hiệu quả nhất.
- Batch lớn / throughput cao: target model đã compute-bound → speedup giảm, thậm chí overhead draft model làm chậm.
- Không muốn train draft model: chọn Lookahead Decoding hoặc MTP (DeepSeek-V3) — không cần mô hình phụ, vẫn đạt 1.8×–3.5×.
- Yêu cầu lossless chặt chẽ: tất cả phương pháp trên đều đảm bảo phân phối đầu ra không đổi so với target model gốc.
Bật speculative decoding trong llama.cpp
llama.cpp là dự án C++ phổ biến nhất để chạy LLM cục bộ, và đã hỗ trợ speculative sampling từ năm 2023. Cách dùng cơ bản cần hai model: một model nhỏ làm draft, một model lớn làm target.
./llama-cli \
  -m model-large.gguf \
  -md model-small.gguf \
  -np 4 \
  --temp 0.8
Các tham số quan trọng:
-md / --model-draft: đường dẫn model draft.-np / --n-predict: số token tối đa sinh ra.--n-gpu-layers-draft: số layer draft model được đưa lên GPU — đặt cao để draft chạy nhanh, vì tốc độ draft quyết định acceptance rate.--temp: nhiệt độ lấy mẫu. Với speculative decoding lossless, đổi nhiệt độ ở phía target vẫn cho phân phối đầu ra đúng.
Lưu ý về mô hình lựa chọn draft: nên chọn draft nhỏ hơn target khoảng 10–20 lần về số tham số, ví dụ target 70B đi kèm draft 1B–3B. Draft quá lớn thì tốn VRAM mà không tăng tỷ lệ chấp nhận đáng kể; draft quá nhỏ thì đề xuất sai nhiều, mất lợi ích.
Đo acceptance rate và điều chỉnh
Các engine hiện đại expose số đo để bạn biết có nên bật hay tắt:
# vLLM: thống kê theo từng request
vllm serve model --speculative-model draft --per-request-spec-decode-metrics detailed
Sau khi đo, tinh chỉnh hai tham số theo thứ tự: (1) tăng num_speculative_tokens nếu acceptance rate trung bình thấp hơn 0.6, nhưng đừng vượt quá 8 — token dự đoán thừa chỉ tăng chi phí verify; (2) giảm K nếu VRAM bị hụt vì KV cache phình to. Nếu throughput đã cao và latency không quan trọng, tắt hẳn speculative decoding lại hợp lý hơn.
Thách thức còn lại
- Acceptance rate phụ thuộc ngữ cảnh: EAGLE-2 khám phá acceptance rate thay đổi theo context, không chỉ vị trí token — dẫn đến dynamic draft tree.
- Overhead memory: Draft model thêm VRAM; tree-based attention (Medusa, EAGLE) tăng KV cache.
- Hardware utilization: Trên H100/A100 với batch lớn, speculative decoding có thể không mang lại lợi ích do GPU đã bão hòa compute.
Kết luận
Speculative decoding đã từ ý tưởng paper (2022) trở thành tính năng production-ready trong vLLM, SGLang, TensorRT-LLM, llama.cpp. Với speedup 2×–4× lossless, đây là kỹ thuật “bắt buộc bật” cho serving LLM latency-sensitive (chat, code completion, RAG). Lựa chọn hiện nay: EAGLE-2 cho chất lượng cao nhất, Lookahead cho đơn giản không cần draft model, MTP nếu dùng DeepSeek-V3.
Từ khóa chính: speculative decoding, giải mã suy đoán, draft model, target model, acceptance rate, speedup LLM, vLLM, llama.cpp, EAGLE, Medusa, Lookahead decoding.