GAN là mô hình học máy độc đáo: hai mạng neural được huấn luyện cùng lúc, một bên tạo ra ảnh giả, bên kia cố gắng phân biệt ảnh thật từ ảnh giả. Nhờ chơi trò này qua vô số vòng lặp, mạng tạo ảnh giả dần học cách tạo ra ảnh thực tế đến mức người thường phân biệt không ra. Mạng GAN do Ian Goodfellow đề xuất năm 2014 là nền tảng của nhiều công nghệ sinh ảnh hiện đại từ StyleGAN cho tới diffusion models.
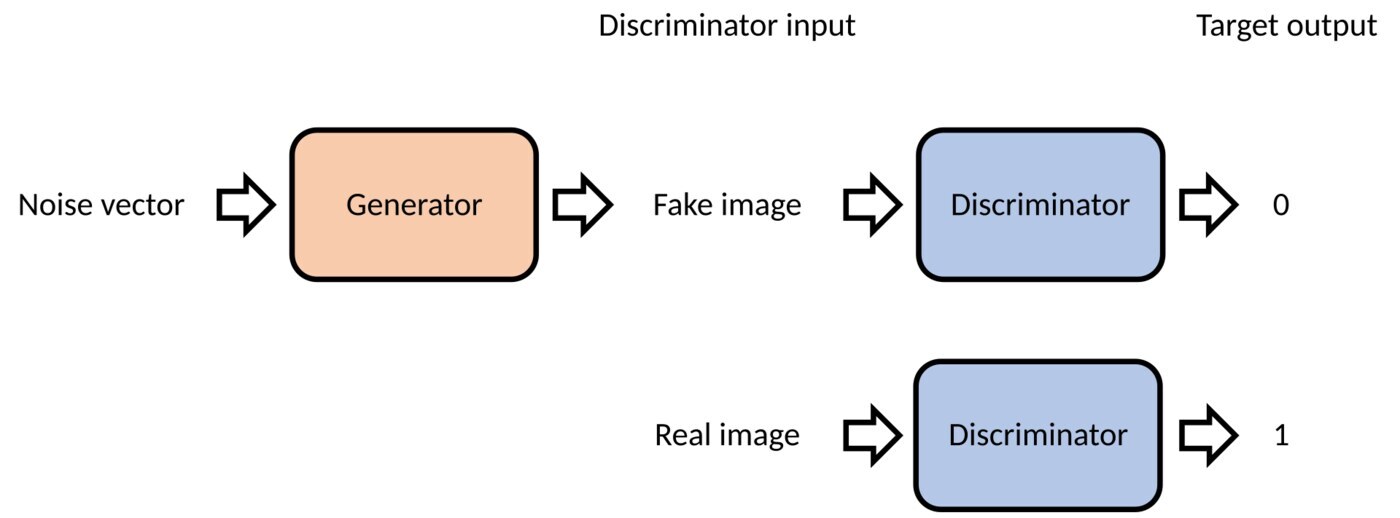
GAN hoạt động như thế nào
Hai mạng trong GAN được gọi là Generator (G) và Discriminator (D). Generator nhận một vector nhiễu ngaussian z và tạo ra một ảnh giả. Discriminator nhận một ảnh (có thể thật từ dataset hoặc giả từ Generator) và ra xác suất ảnh đó là thật. Hai mạng cùng được huấn luyện để tối ưu hàm mục tiêu minmax:
min_G max_D V(D,G) = E_x~pdata[log D(x)] + E_z~pz[log(1 − D(G(z)))]
Ở optimum lý tưởng (giả sử đủ điều kiện và mạng đủ mạnh), Generator sẽ phân phối giống hoàn toàn dữ liệu thực tế, và Discriminator sẽ luôn ra 0.5 cho mọi đầu vào — nghĩa là nó không thể phân biệt thật giả nữa.
Quy trình huấn luyện thực tế gồm các bước lặp lại:
- Lấy một batch ảnh thật từ dataset.
- Tạo batch ảnh giả bằng Generator với vector z ngẫu nhiên.
- Cập nhật Discriminator để tăng log D(x) trên ảnh thật và giảm log(1−D(G(z))) trên ảnh giả (tương đương tối ưu V(D,G) theo D).
- Cập nhật Generator để giảm log(1−D(G(z))) trên ảnh giả (tăng log D(G(z)) – gọi là loss non-saturating).
- Lặp lại từ bước 1 với batch mới.
Trong thực tế nhằm ổn định, thường dùng hai hàm mất mát khác nhau: cho Discriminator giữ nguyên, thay cho Generator bằng hàm loss non-saturating – tăng log D(G(z)) – khi D(G(z)) quá nhỏ thì log(1−D(G(z))) sẽ near 0 (saturate) khiến gradient biến mất.
Hai hàm mất mát và vấn đề mode collapse
Loss GAN nguyên bản có thể gặp vấn đề khi Discriminator trở nên quá tốt sớm: Generator nhận gradient gần zero và dừng học. Hai cải tiến quan trọng là:
- Loss non-saturating: thay vì cố giảm log(1−D(G(z))), ta tăng trực tiếp log D(G(z)) cho Generator. Đánh dấu vị trí bắt đầu các cải tiến ổn định.
- Wasserstein GAN (WGAN): thay vì dùng JS-divergence gần trực tiếp, thay bằng khoảng cách Earth-Mover (Wasserstein-1). Điều này loại bỏ mode collapse và cung cấp loss có ý nghĩa mà dùng để debug và chọn siêu tham.
Mode collapse là hiện tượng Generator chỉ tạo ra một số ít mẫu (thậm chí một mẫu) lặp lại thay vì bao phủ toàn bộ phân phối dữ liệu. WGAN fix phần này, nhưng vì dùng weight clipping để buộc Lipschitz còn gây ra gradient tiêu thụ. Sau đó WGAN-GP thay weight clipping bằng gradient penalty – mềm enforced Lipschitz – cho phép huấn luyện ổn định lên tới các kiến trúc sâu như ResNet-101.
Các chỉ số sau WGAN giúp đánh giá chất lượng mà không phụ thuộc vào tỉ lệ lỗi khi người dùng nhìn:
- Two Time-Scale Update Rule (TTUR): dùng learning rate riêng cho Generator và Discriminator để đạt cân bằng.
- Frechet Inception Distance (FID): so sánh trung bình và hiệp phương sai của đặc trưng Inception giữa ảnh thật và ảnh tạo, thấp là tốt hơn.
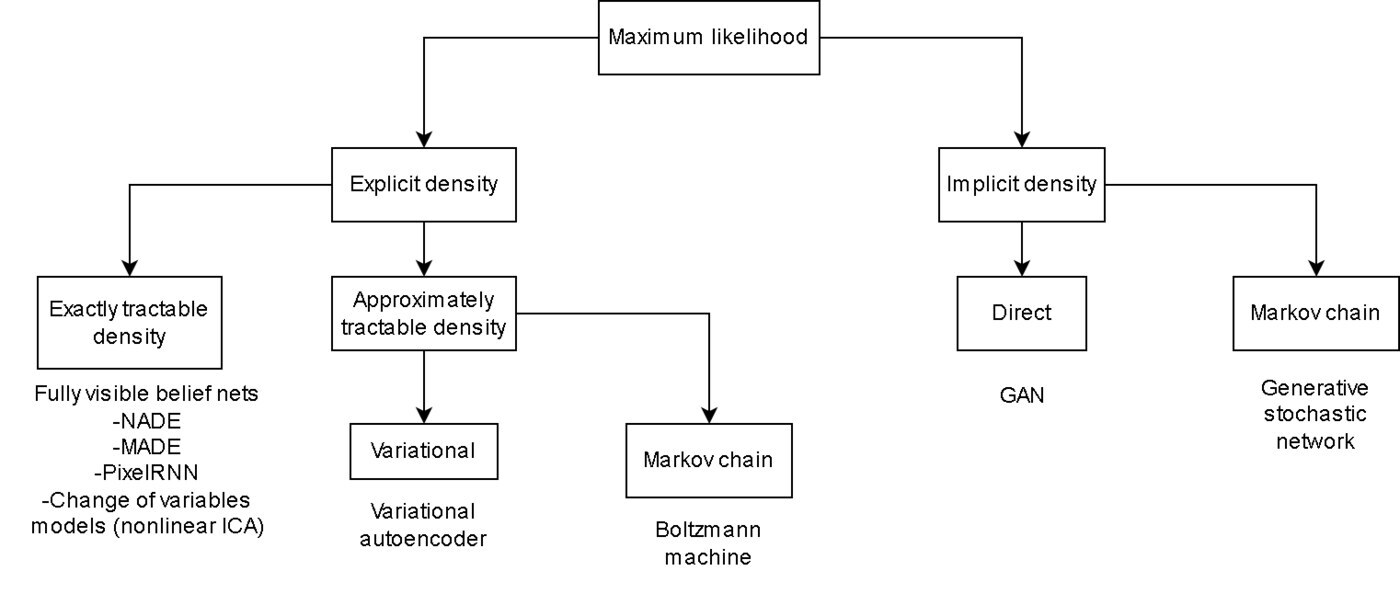
So sánh GAN với các mô hình sinh khác
| Thuộc tính | GAN | Variational Autoencoder (VAE) | Diffusion Model |
|---|---|---|---|
| Mục tiêu | Minimax game giữa G và D | Tái tạo + KL divergence | Học khử nhiễu dần dần |
| Tạo mẫu | Một bước qua Generator | Giải mã từ latent z | Nhiều bước khử nhiễu từ Gaussian |
| Chất lượng ảnh | Rất sắc nét, chi tiết cao | Mượt mà nhưng đôi khi mờ | Rất cao, nhất hiện tại |
| Độ đa dạng | Có thể bị mode collapse | Thường tốt | Rất tốt, bao phủ phân phối |
| Tính ổn định | Cần cân bằng hàm loss giữa G và D | Rất ổn định | Rất ổn định |
| Ví dụ tiêu biểu | DCGAN, StyleGAN, BigGAN | VAE, β-VAE | DDPM, DDIM, Stable Diffusion |
Nhìn vào bảng, ta thấy GAN cho ảnh sắc nét nhất nhưng cần cân bằng hàm loss giữa G và D. VAE ổn định nhưng ảnh thường thiếu chi tiết. Diffusion Model cho chất lượng tốt nhất hiện tại và rất ổn định, nhưng cần nhiều bước để tạo một ảnh (từ 25 tới 1000 bước).
Các thế hệ GAN tiêu biểu
- DCGAN (2015): thay fully-connected layers bằng convolutional layers với một vài ràng buộc kiến trúc (không dùng full-connected, không dùng maxpool, sử dụng batchnorm). Kết quả học được hierarchy từ parts tới whole objects.
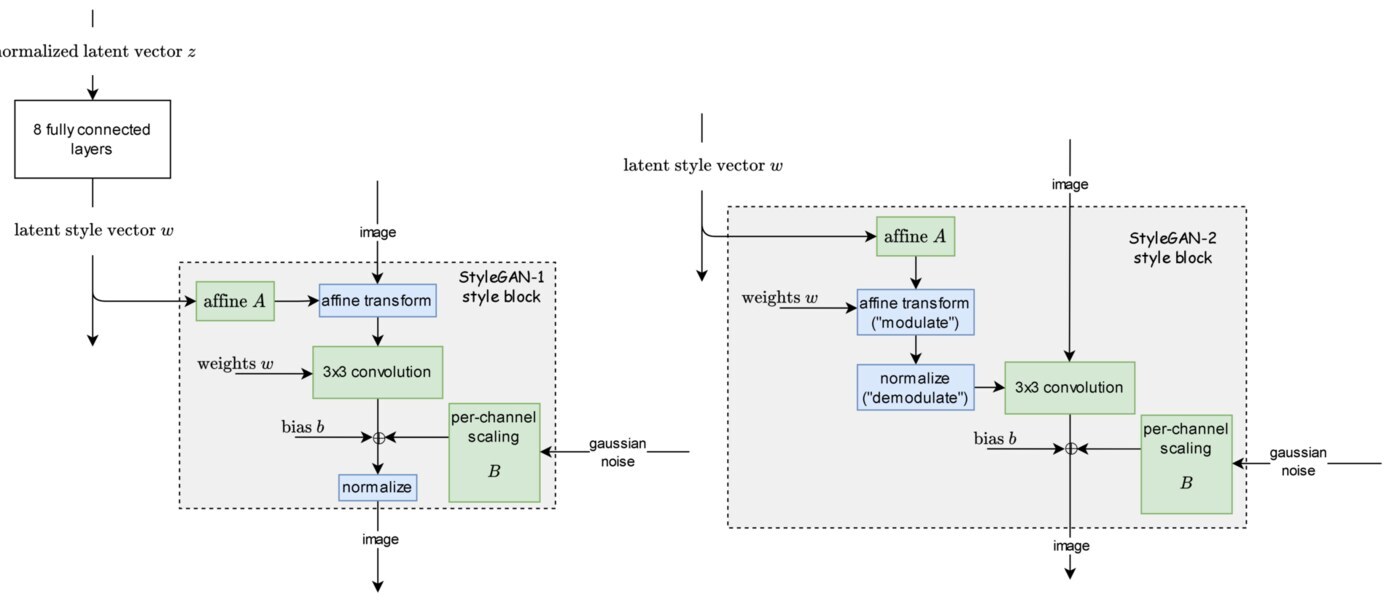
- StyleGAN (2018): thay vector z trực tiếp bằng một mapping network 8 lớp -> latent style w, sau đó dùng AdaIN (adaptive instance normalization) tại mỗi lớp convolution trong synthesis network 18 lớp. Cho phép tách pose, identity khỏi chi tiết stochastic như vết nám, tóc.
- StyleGAN-2 (2019): loại bỏ các artifact của StyleGAN bằng redesigned normalization và thêm path length regularizer.
- BigGAN (2018): mở rộng tới ImageNet với orthogonal regularization trên Generator và dùng truncation trick để cân bằng fidelity-variety.
Khi nào vẫn nên dùng GAN
Mặc dù diffusion model chiếm ưu thế trong text-to-image, GAN vẫn có vị trí trong một số trường hợp:
- Tạo ảnh thực thời: vì chỉ cần một qua forward pass của Generator, GAN có thể chạy tới hơn 100 fps trên GPU hiện đại, thích hợp cho ứng dụng tương tác.
- Tập dữ liệu nhỏ: StyleGAN2-ADA cho phép huấn luyện chất lượng cao với chỉ vài chục nghìn hình nhờ adaptive discriminator augmentation.
- Các ứng dụng cần kiểm soát chi tiết: StyleGAN cho phép chỉnh sửa phong cách (tóc, pose, nền) qua vector style riêng cho từng lớp.
- Nhiệm vụ super-resolution hoặc inpainting: GAN có thể được điều chỉnh để bảo vệ biên và tạo texture mượt.
Tóm tắt
GAN là bước ngoặt quan trọng trong học máy sinh, đưa ra framework đối kháng tạo ra ảnh cực kỳ sắc nét. Mặc dù diffusion models vượt mặt trong nhiều bài chuẩn để đo chất lượng ảnh và ổn định hơn, GAN vẫn là lựa chọn hàng đầu khi cần tạo ảnh thực thời, kiểm soát phong cách hoặc làm việc với dữ liệu nhỏ. Các cải tiến như WGAN-GP, StyleGAN-2 và StyleGAN2-ADA đã làm cho việc huấn luyện GAN trở nên ổn định và có thể mở rộng tới phân giải cao như 1024×1024 trên consumer GPU.
Nguồn: arXiv:1406.2661, arXiv:1511.06434, arXiv:1701.07875, arXiv:1704.00028, arXiv:1710.10196, arXiv:1809.11096, arXiv:1812.04948, arXiv:1912.04958, arXiv:2006.11239, arXiv:2105.05233, arXiv:2112.10752, github.com/NVlabs/stylegan2-ada-pytorch, en.wikipedia.org/wiki/Generative_adversarial_network