Object detection là gì? Cách AI nhận diện vật thể trong ảnh
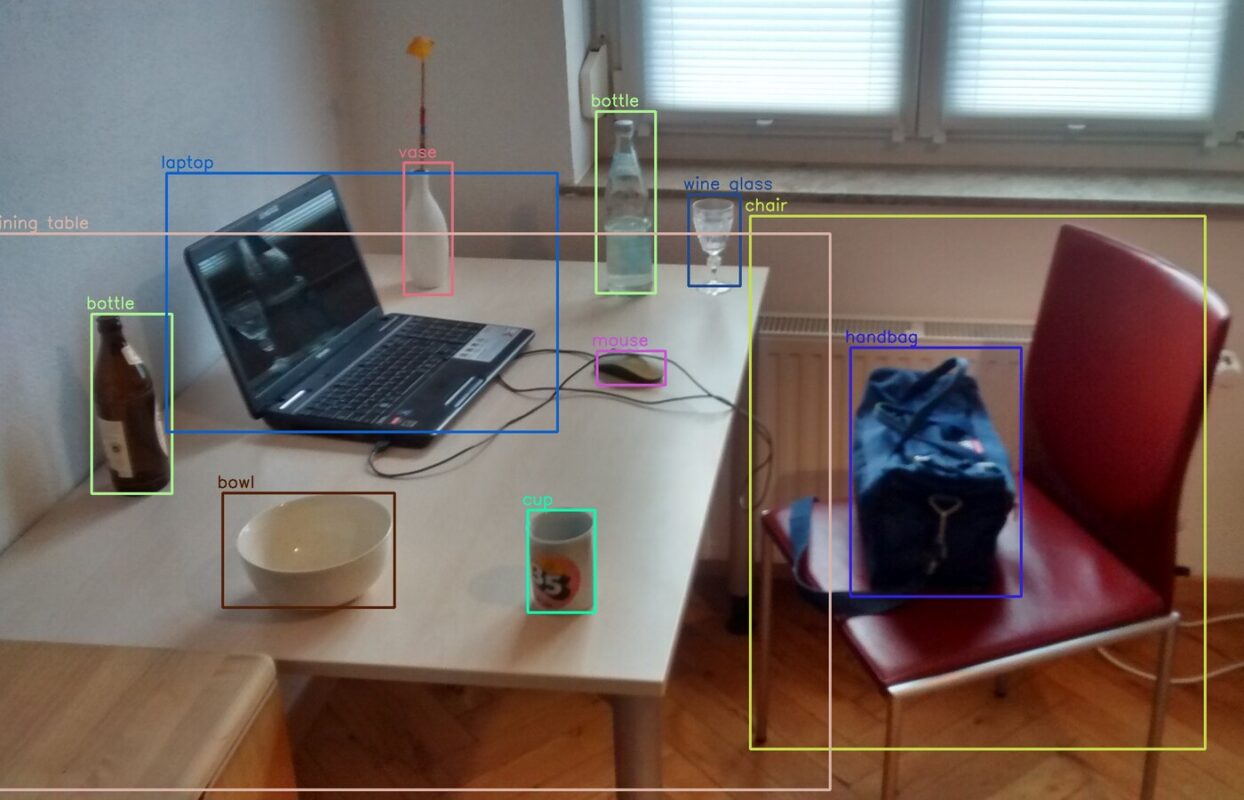
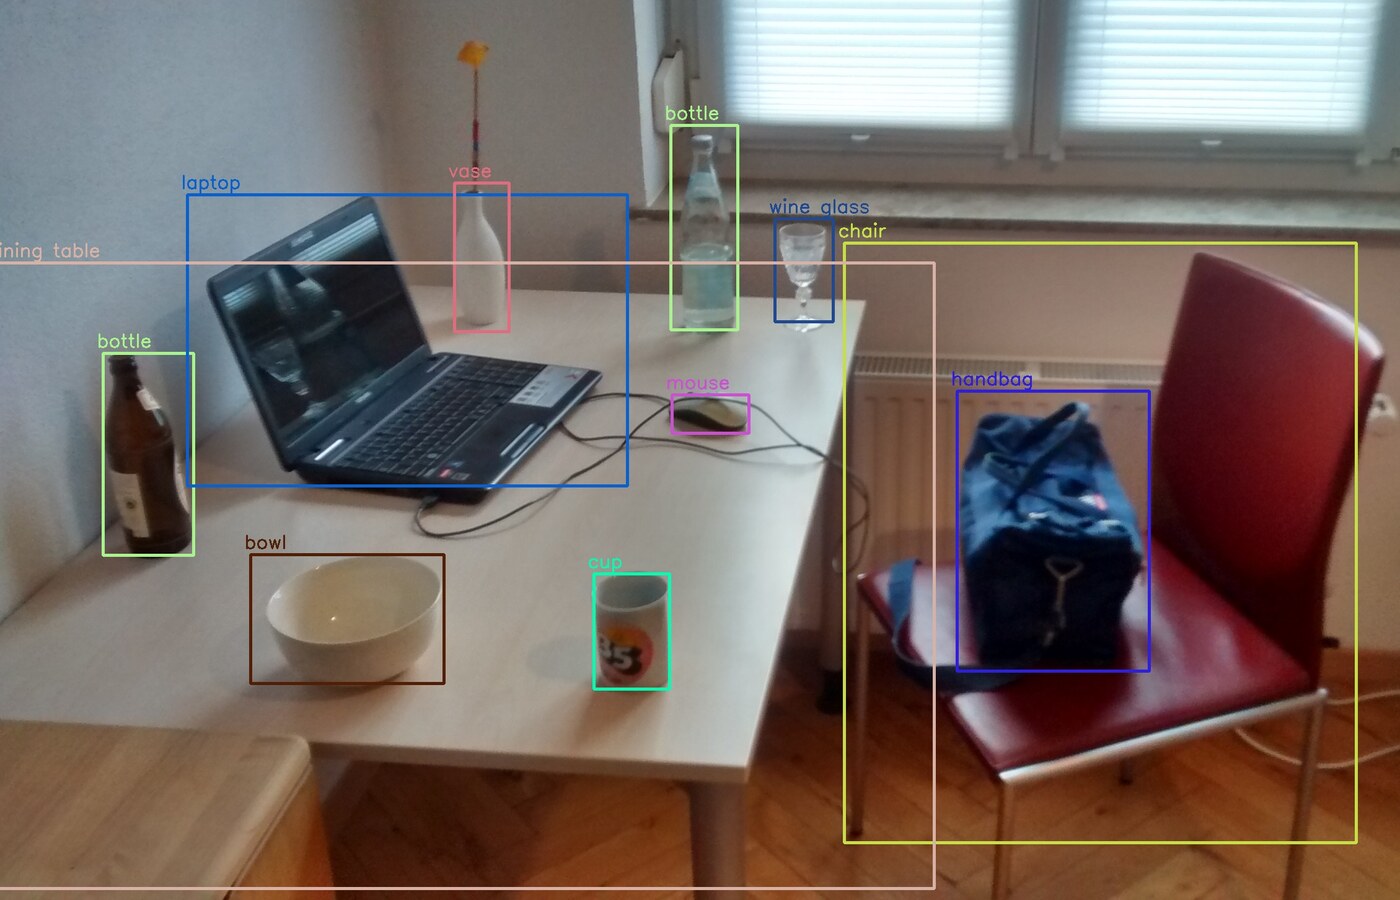
Object detection (phát hiện đối tượng) là bài toán thị giác máy tính, trong đó mô hình AI vừa phân loại vừa định vị vật thể trong ảnh bằng cách gán nhãn kèm khung bao (bounding box) cho từng đối tượng. Đây là nền tảng của xe tự lái, camera giám sát, robot công nghiệp và các hệ thống đếm người.
Phân biệt với phân loại ảnh
Phân loại ảnh (image classification) chỉ trả lời câu hỏi “trong ảnh này có con mèo hay không”. Object detection trả lời câu hỏi khó hơn nhiều: có bao nhiêu con mèo, chúng nằm ở vị trí nào, kích thước ra sao, và chúng có đang che khuất nhau không. Mô hình phải dự đoán đồng thời tọa độ bốn góc (x_min, y_min, x_max, y_max), lớp vật thể và độ tin cậy cho từng mục.
Chính vì vậy, một bản ảnh chụp cảnh bàn làm việc sẽ cho ra nhiều kết quả cùng lúc: màn hình, bàn phím, cốc cà phê, chiếc chai, mỗi vật một khung riêng. Đây là lý do object detection trở thành kỹ năng nền tảng mà mọi kỹ sư thị giác máy tính đều cần nắm.
Các hướng tiếp cận chính
Hai giai đoạn — two-stage
Mô hình dò đề xuất vùng ứng viên trước, rồi phân loại từng vùng. R-CNN là phiên bản đầu tiên, sau đó Faster R-CNN thay thế quy trình đề xuất chậm bằng mạng RPN chạy chung với mạng phân loại. Ưu điểm là độ chính xác cao khi vật thể nhỏ hoặc chồng lấn, nhược điểm là chậm và nặng, không phù hợp triển khai thời gian thực.
Một giai đoạn — one-stage
YOLO (You Only Look Once) dự đoán khung và lớp trong một lượt duyệt mạng. Bản đầu tiên dùng 24 lớp tích chấp, các bản sau đó đổi hoàn toàn kiến trúc và tăng vọt độ chính xác. Nhờ tốc độ cao, YOLO là lựa chọn phổ biến cho camera giám sát, robot và thiết bị biên. SSD cũng thuộc nhóm này, gặp giữa giữa YOLO và R-CNN.
Dựa trên Transformer
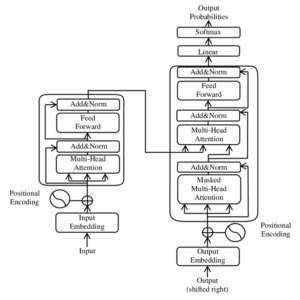
DETR đưa kiến trúc Transformer vào bài toán này, xem các khung quan tâm như các token trong câu, loại bỏ hoàn toàn anchor và bước lọc NMS rườm rà. RT-DETR sau đó cải thiện tốc độ hội tụ để đạt chất lượng ứng dụng thời gian thực.
Đánh giá mô hình bằng IoU
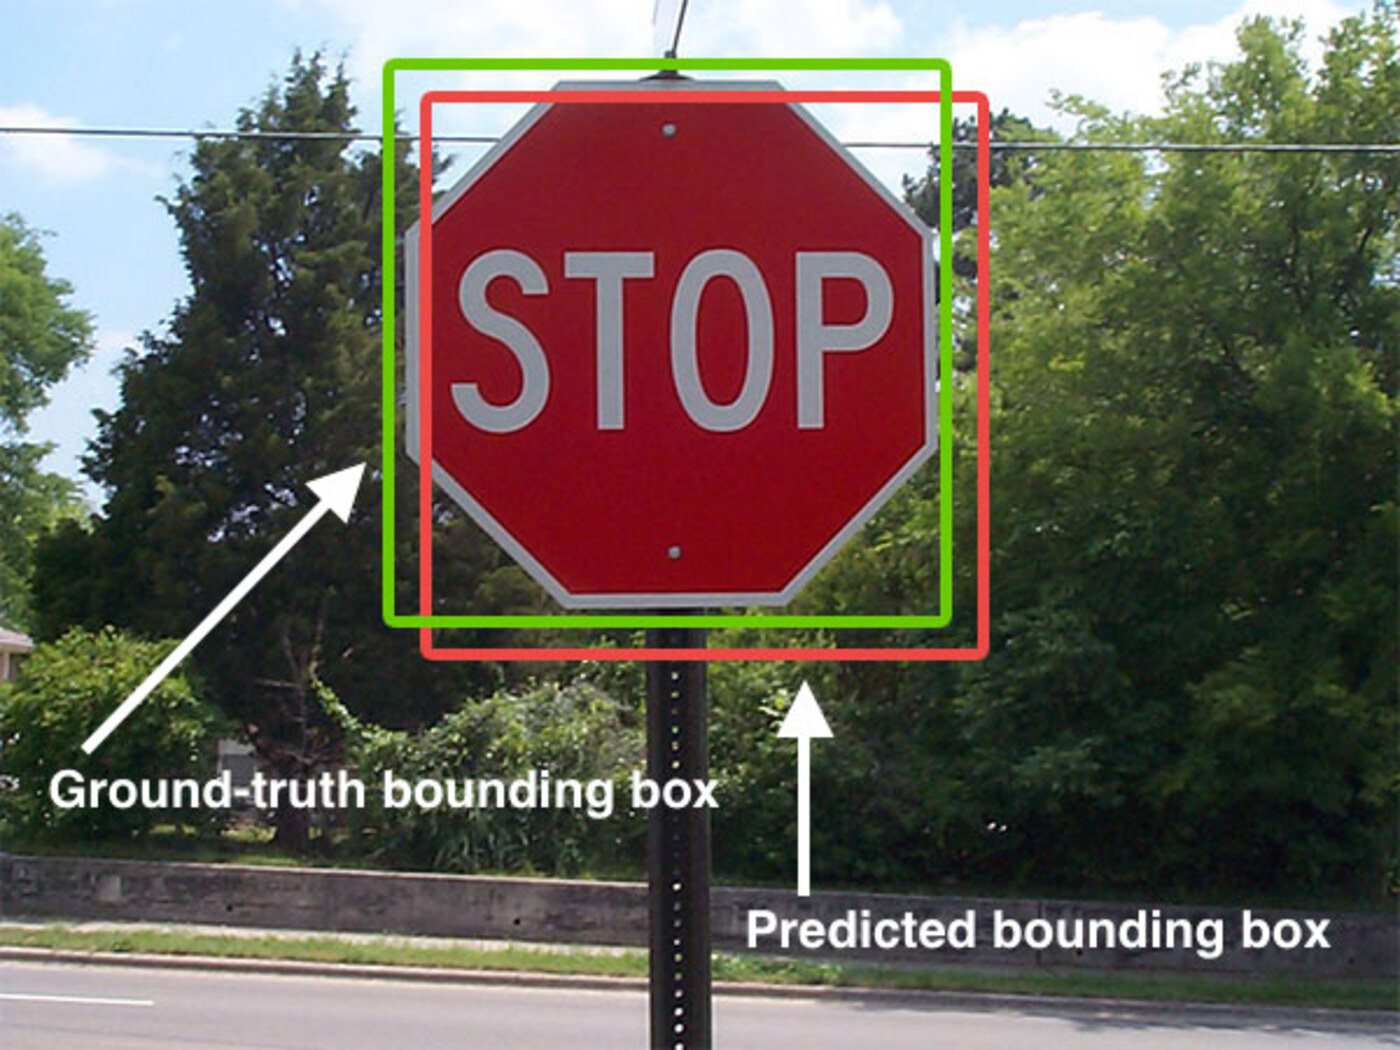
Chỉ số Intersection over Union (IoU) đo phần diện tích chồng lấn giữa khung dự đoán và khung thực tế, chia cho tổng diện tích của cả hai khung. Giá trị 0 nghĩa là hai khung không giao nhau, giá trị 1 nghĩa là trùng khít. Trong thực tế, IoU trên 0.5 thường được coi là kết quả đúng.
IoU cũng là nền tảng của quy trình khớp dự đoán với nhãn thật: mô hình dự đoán hàng trăm khung, bộ dữ liệu chỉ có vài chung, thuật toán khớp theo IoU rồi mới tính độ chính xác. Hai chỉ số tổng hợp phổ biến là [email protected] — trung bình độ chính xác tại ngưỡng IoU 0.5, và [email protected]:0.95 — trung bình trên dải ngưỡng, phản ánh chất lượng định vị chặt chẽ hơn.
| Phương pháp | Tốc độ | Độ chính xác | Phù hợp với |
|---|---|---|---|
| R-CNN / Faster R-CNN | Chậm | Cao | Nghiên cứu, ảnh độ phân giải Cao |
| YOLO (một giai đoạn) | Rất nhanh | Tốt | Thời gian thực, thiết bị biên |
| SSD | Nhanh | Trung bình | Ứng dụng nhúng, mô hình nhỏ |
| DETR / RT-DETR | Trung bình | Khá Cao | Cần GPU mạnh, hội tụ chậm |
| Dạng phân đoạn (segmentation) | Chậm | Rất cao về hình dạng | Y tế, xử lý ảnh y khoa |
Quy trình huấn luyện một mô hình
Hầu hết mô hình hiện đại được huấn luyện trên tập dữ liệu có sẵn như COCO với hàng trăm nghìn ảnh đã gán nhãn, hoặc mở rộng từ bản pretrained rồi tinh chỉnh trên dữ liệu riêng. Bốn bước cơ bản:
- Chuẩn bị dữ liệu. Gán khung bao cho mỗi vật thể, chia tập huấn luyện, tập kiểm định và tập kiểm tra.
- Chọn kiến trúc. Quyết định dùng YOLO hay Faster R-CNN dựa trên yêu cầu tốc độ và tài nguyên phần cứu.
- Huấn luyện. Tối ưu hàm mất mát kết hợp sai lệch vị trí khung và sai lệch phân loại, thường bằng SGD hoặc AdamW kèm learning rate giảm dần.
- Đánh giá và tinh chỉnh. Đo mAP trên tập kiểm chứng, phân tích các trường hợp sai để cải thiện dữ liệu hoặc siêu tham số.
Trong quá trình huấn luyện có thể dùng kỹ thuật tăng cường dữ liệu: lật ngang, thay đổi độ sáng, cắt ngẫu nhiên, hay chèn vật thể giả. Nhờ đó mô hình không bị quá thích nghi với điều kiện chụp ảnh cố định và tổng quát tốt hơn trên dữ liệu mới.
Ứng dụng thực tế
- Phương tiện tự lái phát hiện người đi bộ, phương tiện khác, làn đường và biển báo trong thời gian thực.
- Camera giám sát đếm lưu lượng người, phát hiện hành vi bất thường, nhận diện vật thể bị bỏ quên.
- Robotics trong kho xác định chính xác vị trí món hàng để gắp, tối ưu đường đi của robot.
- Kiểm soát chất lượng phát hiện linh kiện khuyết, sai kích thước trong dây chuyền sản xuất.
- Y tế hỗ trợ chẩn đoán bằng cách khoanh vùng tổn thương trên ảnh X-quang, CT và MRI.
Những thách thức thường gặp
- Vật thể nhỏ hoặc bị che khuất khiến IoU thấp dù mô hình vẫn nhìn thấy vật thể.
- Ánh sáng yếu, mưa, sương mù làm giảm độ tin cậy dự đoán ngoài dữ liệu huấn luyện.
- Dữ liệu gán nhãm thiếu hoặc lệch phân bố theo vùng miền khiến mô hình không tổng quát.
- Yêu cầu dịch mô hình sang thiết bị biên như Raspberry Pi cần nén và tối ưu kiến trúc.
Liên kết tham khảo: Object detection — Wikipedia, Intersection over union — Wikipedia, bài báo You Only Look Once: Unified, Real-Time Object Detection và tài liệu triển khai Ultralytics Docs.