Mạng nơ-ron tích chập (Convolutional Neural Network, viết tắt CNN) là kiến trúc mạng nơ-ron được thiết kế riêng cho dữ liệu có cấu trúc không gian như ảnh, video và âm thanh. Thay vì nối toàn bộ mọi điểm ảnh với nhau như mạng nơ-ron thông thường, CNN quét ảnh bằng những cửa sổ nhỏ gọi là kernel, nhờ đó mạng học được các đặc trưng cục bộ trước rồi ghép chúng lại thành khái niệm lớn hơn.
Đây là nền tảng của mọi hệ thống nhận dạng ảnh hiện đại: phân loại ảnh, phát hiện vật thể, nhận dạng khuôn mặt, chẩn đoán y tế và cả trò chơi điện tử. Bài viết này đi từ phép tích chập đơn giản nhất đến các kiến trúc CNN nổi tiếng, kèm những lỗi thường gặp khi tự xây mô hình.
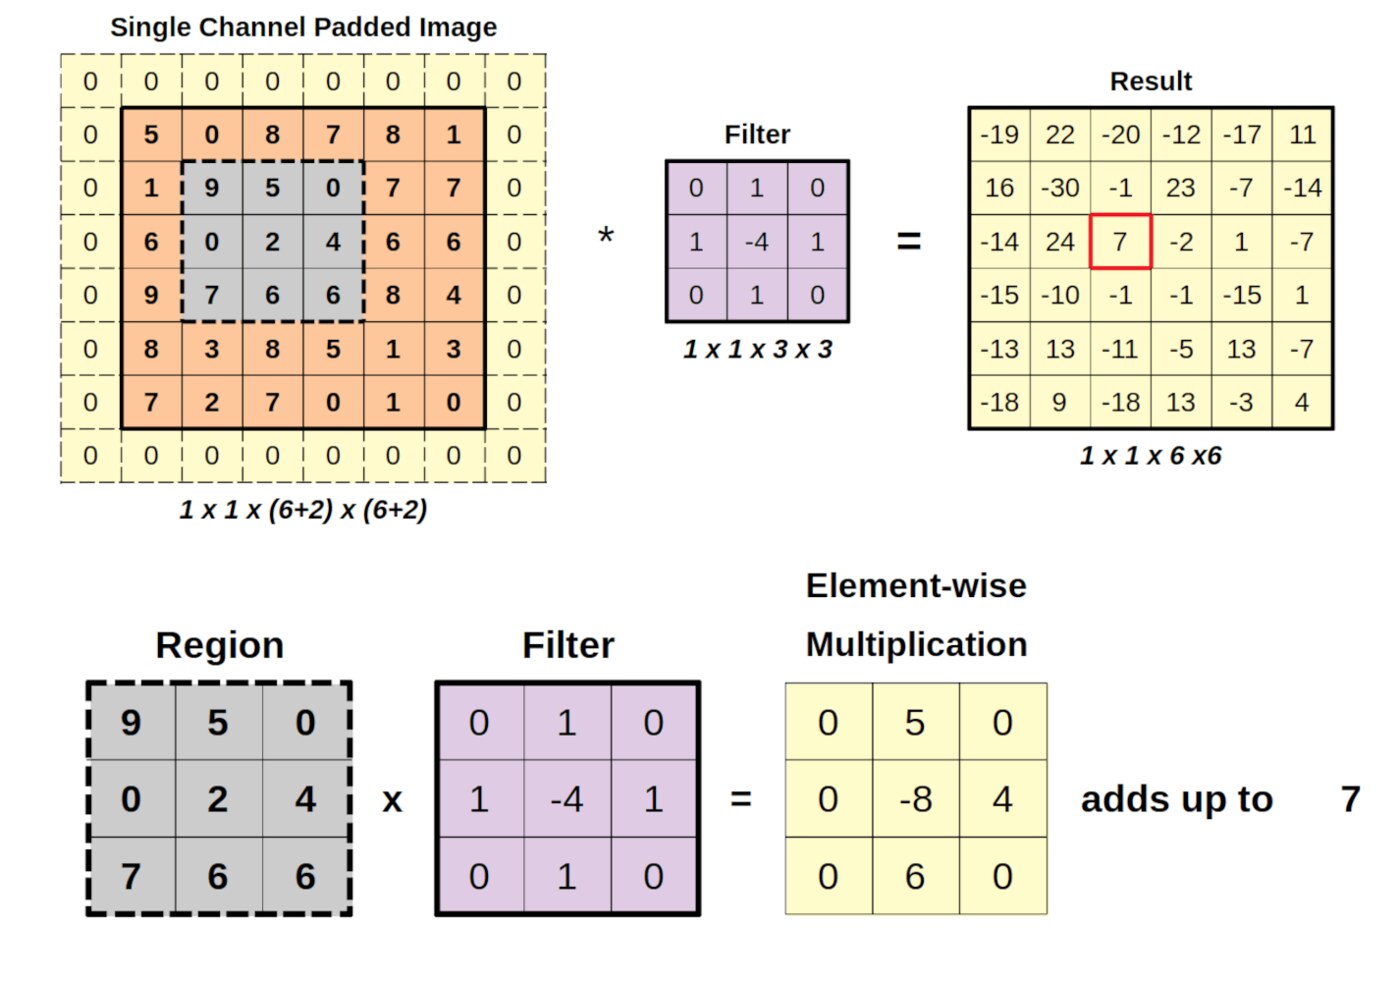
Phép tích chập hoạt động như thế nào
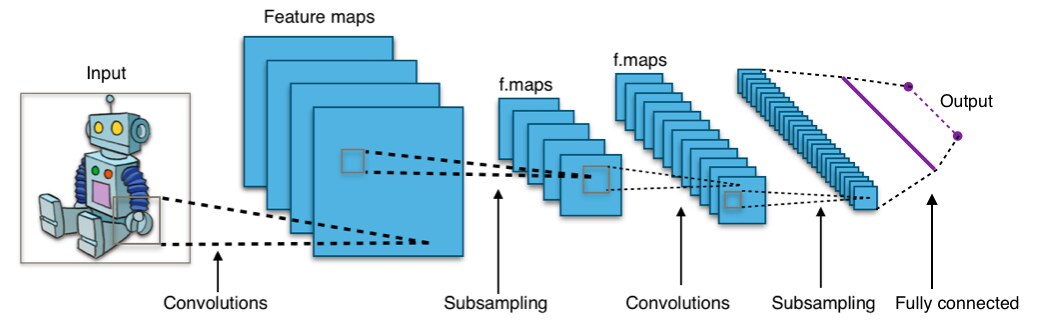
Phép tích chập (convolution) là phép nhân từng phần tử giữa một ma trận nhỏ và một vùng của ảnh, rồi cộng tổng lại. Bộ lọc đó gọi là kernel. Ví dụ một kernel 3×3 trượt trên ảnh đầu vào tạo ra một ảnh kết quả nhỏ hơn, gọi là feature map, nơi mỗi điểm ảnh tương ứng với một đặc trưng mà kernel phát hiện được.
Hai tham số quan trọng nhất đi kèm là:
- Stride — bước nhảy của kernel mỗi lần trượt. Dùng stride 2 thì kích thước chiều cao và chiều rộng giảm một nửa, vừa giảm tính toán vừa tăng mức trừu tượng của đặc trưng.
- Padding — số lớp đệm viền thêm vào biên ảnh. Padding cùng kích thước với kernel giữ nguyên kích thước đầu ra, tránh việc mỗi lớp tích chập làm ảnh nhỏ đi.
Ví dụ với ảnh 224x224x3 của ba kênh màu và kernel 11×11 dùng stride 4, kích thước đầu ra là (224 – 11) chia 4 lấy phần nguyên cộng 1, tức 54×54. Đó chính xác là lớp tích chập đầu tiên của AlexNet, mô hình đưa kỹ thuật này lên đỉnh vào năm 2012.
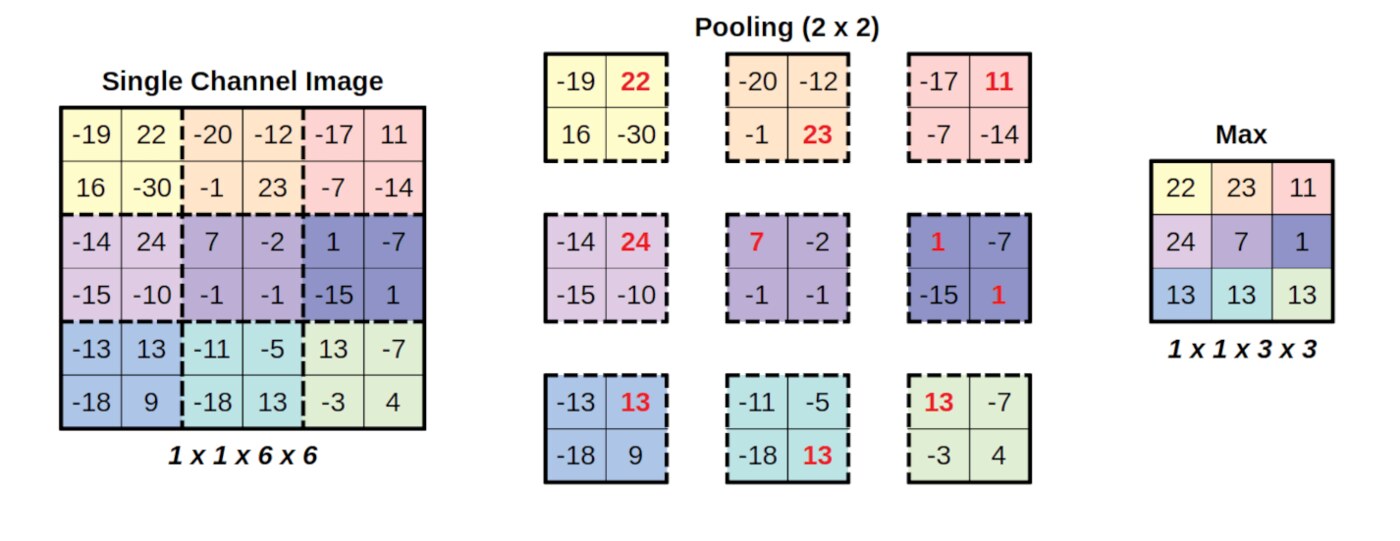
Ba tầng quan trọng: tích chập, gộp và kích hoạt
Một khối CNN điển hình ghép ba thành phần lại với nhau:
- Lớp tích chập trích xuất đặc trưng cục bộ. Lớp đầu nhận diện cạnh, góc và vết màu; các lớp sau ghép chúng thành texture rồi thành vật thể.
- Lớp gộp (pooling) giảm kích thước không gian. Với max pooling cửa sổ 2×2 và stride 2, chỉ 25% giá trị kích hoạt còn lại nằm trong đầu ra, tức loại bỏ tới 75% thông tin không gian. Lợi ích kép là giảm tham số và tạo khả năng bất biến với tịnh tiến nhỏ.
- Hàm kích hoạt ReLU với công thức f(x) = max(0, x) đưa mạng bỏ tính tuyến tính, cho phép học các quan hệ phi tuyến phức tạp. ReLU rẻ hơn hàm sigmoid cũ và huấn luyện nhanh hơn hẳn.
Sau vài khối như vậy, feature map được làm phẳng thành vector rồi đưa vào các lớp kết nối đầy đủ phía cuối để phân loại. Lớp tích chập dùng chung trọng số giữa mọi vị trí trong ảnh, nên một mạn hình chỉ tốn số tham số bằng kích thước kernel, không nhân lên theo diện tích ảnh. Đó là lý do CNN nhẹ hơn hẳn mạng nơ-ron kết nối đầy đủ ở cùng bài toán.
Các kiến trúc CNN đã định hình lịch sử
| Mô hình | Đặc điểm chính | Kết quả nổi bật |
|---|---|---|
| LeNet-5 | 7 lớp, dùng tích chập và gộp xen kẽ | Nền tảng nhận dạng chữ viết tay trên bưu thiếp |
| AlexNet | 5 lớp tích chập + 3 lớp kết nối, khoảng 60 triệu tham số | Sai số top-5 15,3% trên cuộc thi ImageNet, giảm mạnh so với phương pháp truyền thống |
| VGG | 16 đến 19 lớp, toàn bộ tích chập 3×3 và gộp tối đa 2×2 | Chứng minh tăng chiều sâu vẫn cải thiện độ chính xác |
| ResNet | Thêm kết nối bỏ qua, tới 152 lớp | Sai số top-5 3,57%, giải quyết hiện tượng mất gradient khi mạng quá sâu |
Nguyên lý cốt lõi của ResNet là cộng thêm kết nối nhận dạng, nghĩa là đầu vào của khối được cộng thẳng vào đầu ra. Nhờ vậy gradient có đường đi tắt, mạng có thể sâu hàng trăm lớp mà vẫn huấn luyện được. Hướng dẫn chi tiết về cơ chế truyền ngược qua mạng tích chập nằm trong tài liệu môn CS231n của Đại học Stanford.
Ứng dụng thực tế và nơi CNN còn yếu
Ngoài phân loại ảnh, CNN còn là xương sống của phát hiện vật thể và phân vùng ảnh y tế. Lịch sử ứng dụng y tế của kiến trúc này khá sớm: từ năm 1991 các nghiên cứu đã dùng mạng tích chập để phân đoạn ảnh, và đến năm 1994 kỹ thuật này đã được dùng để dò ung thư vú trên ảnh chụp. Với dữ liệu phi truyền thống, bước phổ biến là transfer learning: lấy một CNN đã huấn luyện trên tập ảnh rất lớn, thay lớp cuối cùng rồi tinh chỉnh trên tập nhỏ của bạn. Cách làm này tiết kiệm dữ liệu và thời gian tính toán đáng kể.
Có ba lỗi thường gặp khi người mới tự xây CNN:
- Ảnh không đồng nhất về kích thước. Lớp kết nối đầy đủ cần kích thước cố định, nên phải resize trước khi huấn luyện và suy luận.
- Quá nhiều lớp gộp quá sớm. Gộp liên tiếp làm mất chi tiết ở ảnh y tế hoặc ảnh chữ viết tay, nơi cạnh nhỏ lại mang thông tin quan trọng.
- Chỉ dựa vào độ chính xác tập kiểm tra. Tập kiểm tra bị rò rỉ dữ liệu sẽ cho kết quả đẹp giả. Cần tách riêng tập kiểm định và theo dõi độ chính xác trên tập kiểm tra trong suốt quá trình.
Tóm lại, CNN thắng được mọi kiến trúc trước đó nhờ ba ý tưởng tái sử dụng: các trọng số được chia sẻ giữa mọi vị trí, trường tiếp nhận cục bộ nên đòi hỏi ít tham số, và việc gộp tầng tạo ra tính bất biến với tịnh tiến. Nắm ba cơ chế này là nền tảng để hiểu mọi mô hình thị giác máy tính hiện đại.
Nguồn tham khảo: Wikipedia — Convolutional neural network, Wikipedia — AlexNet, Wikipedia — ResNet, bài báo AlexNet trên arXiv, bài báo ResNet trên arXiv, Wikipedia — Receptive field.