Mô hình khuếch tán là gì? Cách AI tạo ảnh chất lượng cao từ nhiễu
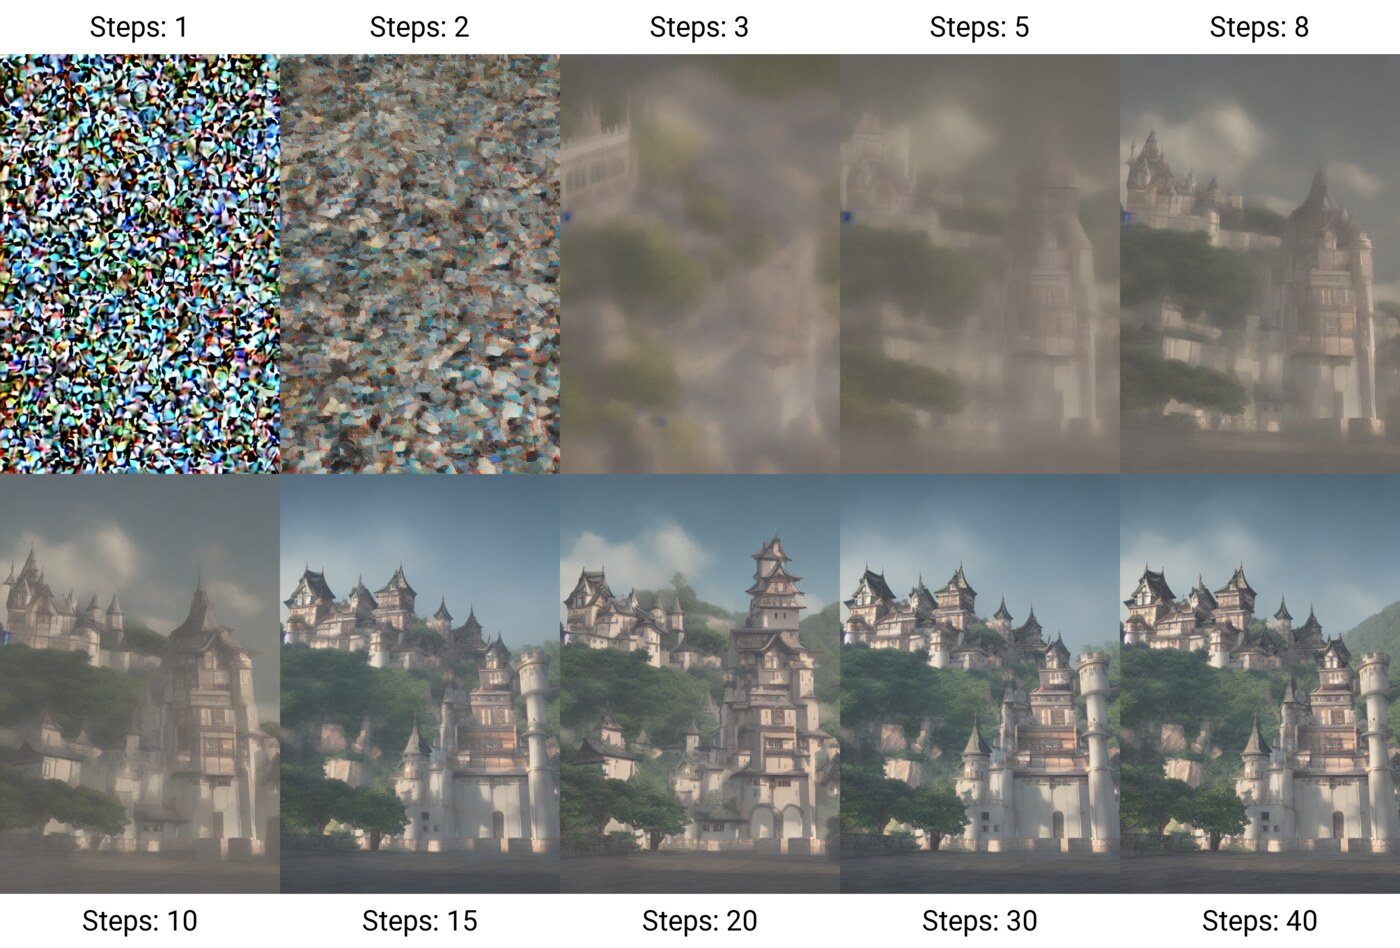
Mô hình khuếch tán (diffusion model) là một lớp mô hình sinh tạo dữ liệu bằng cách học quá trình làm nhiễu dần dần và quá trình khôi phục ngược lại. Nó lấy dữ liệu thật (ảnh, âm thanh), thêm nhiễu từng bước cho tới khi dữ liệu trở thành nhiễu thuần tuý, rồi học cách đi ngược lại để dựng lại dữ liệu gốc. Quá trình đi ngược đó gọi là khuếch tán ngược (reverse diffusion).
Cơ chế của một mô hình khuếch tán gồm hai giai đoạn rõ ràng: quá trình tiến (forward diffusion) và quá trình ngược (reverse diffusion).
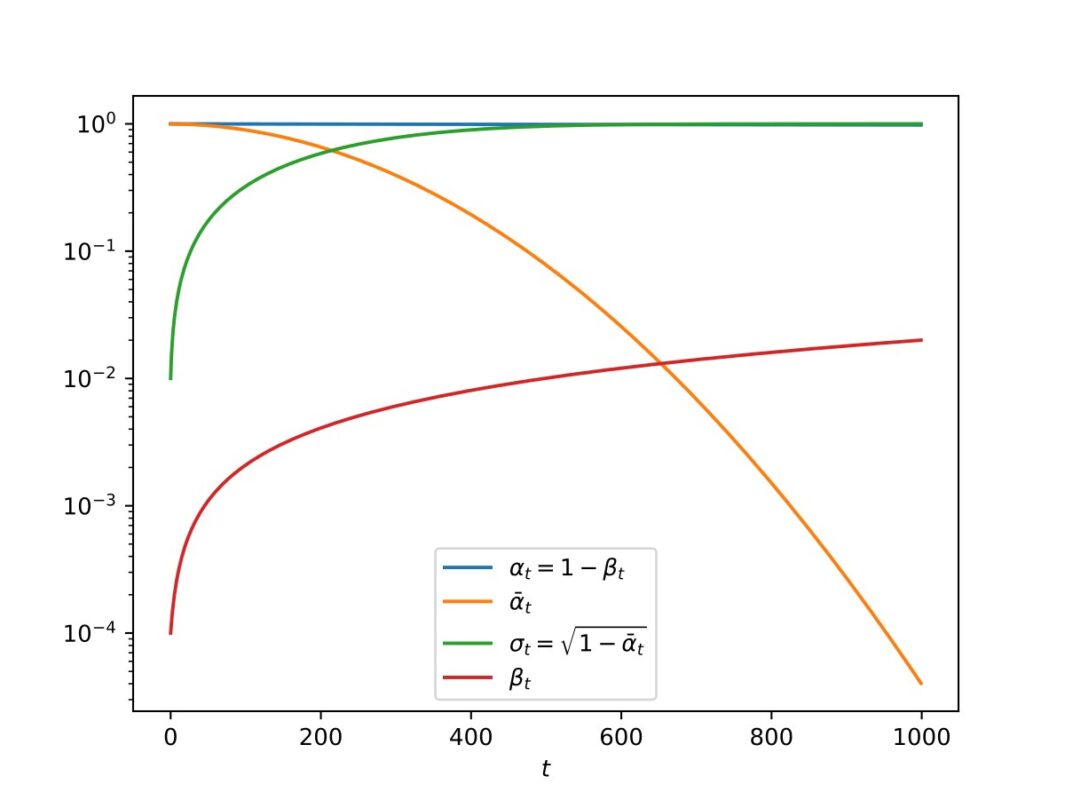
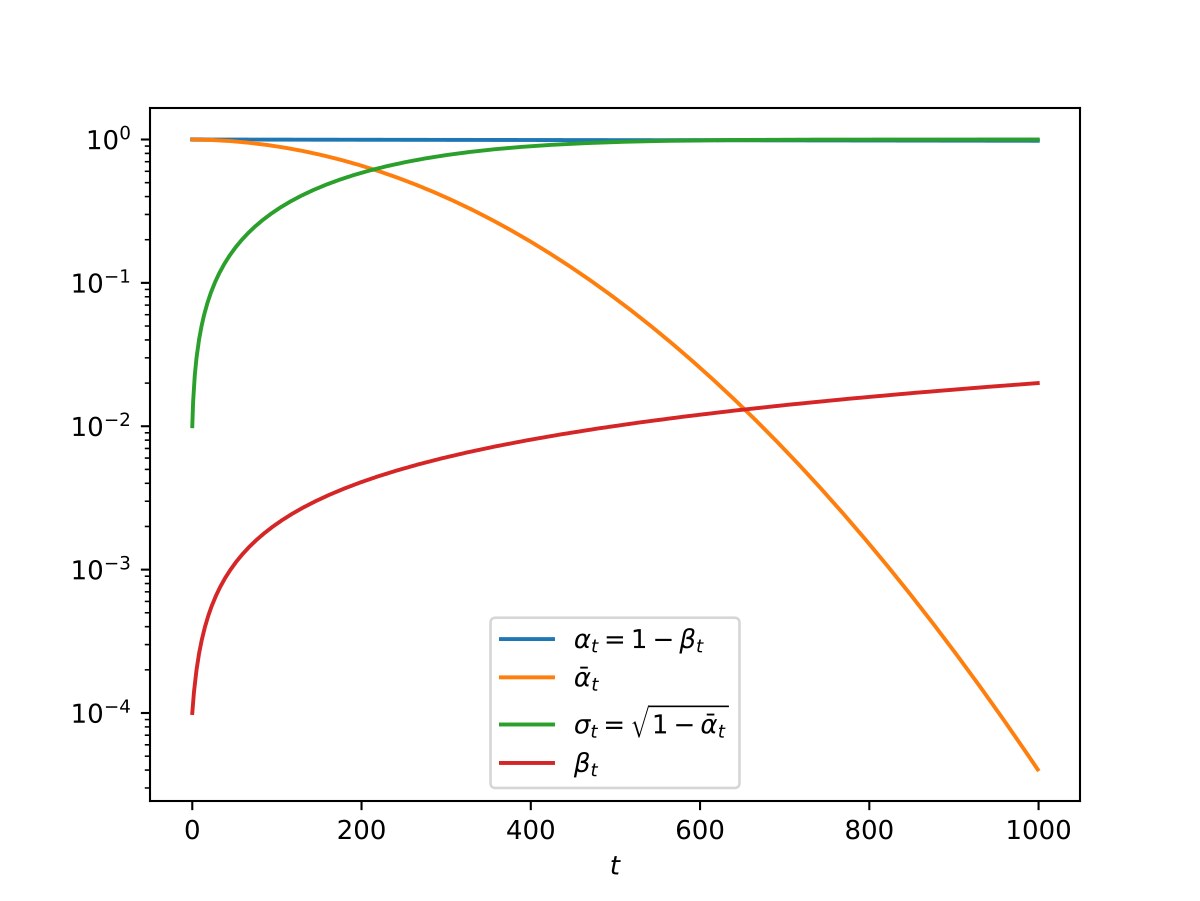
- Trong quá trình tiến, mỗi bước thêm một lượng nhiễu Gaussian nhỏ vào dữ liệu theo phương sai định trước (β₁, β₂, …, β_T). Sau T bước, dữ liệu gần như mất hết cấu trúc.
- Trong quá trình ngược, mô hình học dự đoán lại phần nhiễu đã bị thêm ở mỗi bước để khôi phục dữ liệu. Phần dự đoán này thường do một mạng nơ-ron hình chữ U (U-Net) đảm nhiệm, nhận đầu vào là ảnh đã nhiễu ở bước t và trả về nhiễu ước lượng.
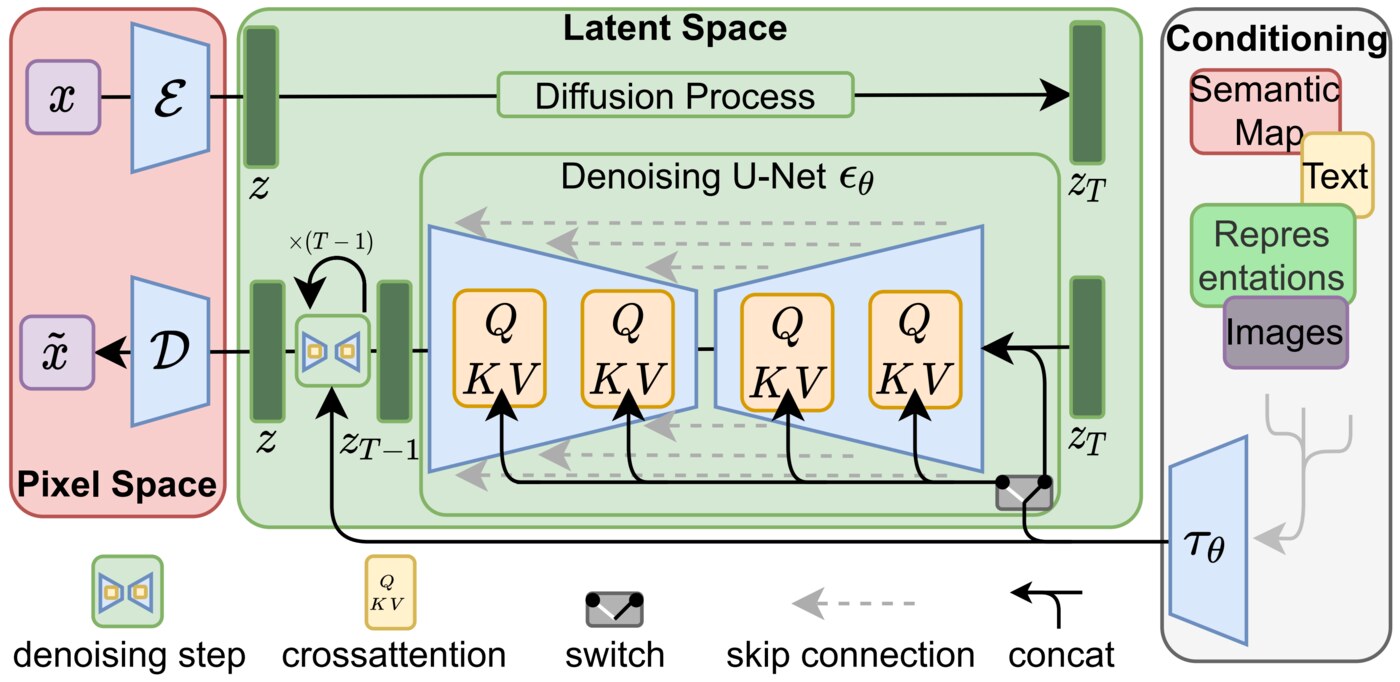
Các biến thể kiến trúc quan trọng gồm:
- Denoising Diffusion Probabilistic Models (DDPM): mô hình nền tảng, dùng chuỗi Markov và học phương sai của quá trình ngược. [Ho et al. 2020]
- Latent Diffusion Models (LDM): chạy diffusion trong không gian tiềm ẩn của một bộ mã hoá tự động có sẵn, giúp giảm chi phí tính toán rất nhiều so với chạy trực tiếp trên pixel. [Rombach et al. 2021]
- Denoising Diffusion Implicit Models (DDIM): bỏ giả định Markov, cho phép lấy mẫu nhanh hơn DDPM khoảng 10 đến 50 lần mà chất lượng gần như giữ nguyên. [Song et al. 2020]
Điểm mạnh nổi bật của họ mô hình này:
- Chất lượng sinh tạo cao, vượt GAN trên các bộ đo ảnh tự nhiên như ImageNet khi dùng hướng dẫn có phân loại. [Dhariwal và Nichol 2021]
- Độ đa dạng cao nhờ tính ngẫu nhiên của quá trình ngược, mỗi lần chạy cho kết quả khác nhau.
- Dễ định hướng đầu ra mà không cần huấn luyện lại, nhờ kỹ thuật hướng dẫn không phân loại. [Ho và Salimans 2022]
Ứng dụng thực tế rất rộng: sinh ảnh từ văn bản, tô mào ảnh (inpainting), siêu phân giải, tạo video và tạo âm thanh. Thư viện Hugging Face Diffusers gói sẵn các đường dẫn suy luận cho mô hình phổ biến, kèm tuỳ chọn biên dịch và lượng tử hoá khi thiết bị yếu. [Tài liệu Diffusers]
Đánh đổi và giới hạn: chất lượng cao đi kèm chi phí tính toán lớn, vì mỗi ảnh phải đi qua hàng chục tới hàng trăm bước khử nhiễu. Huấn luyện cũng tốn tài nguyên hơn mô hình tự hồi quy, do phải mô phỏng cả hai chiều trên toàn bộ chuỗi bước nhiễu. Ngoài ra, triển khai mô hình lớn như Stable Diffusion XL cần khoảng vài gigabyte VRAM nếu chạy ở độ phân giải cao.
Những lỗi thường gặp: người mới dễ chọn sai hàm mất mát (dự đoán nhiễu hay dự đoán ảnh sạch), không cân đối giữa tốc độ học và kích thước lô khiến quá trình học mất ổn định, hoặc dùng bộ lập lịch nhiễu không hợp với khoảng nhiễu huấn luyện làm ảnh đầu ra bị lệch màu. Với ứng dụng chạy thật, nên giảm số bước lấy mẫu bằng DDIM hoặc chuyển sang kiến trúc dựa trên Transformer.
Để so sánh rõ hơn giữa các hướng tiếp cận, bảng dưới đây tóm tắt những khác biệt chính:
| Tiêu chí | Mạng đối kháng (GAN) | Mô hình khuếch tán |
|---|---|---|
| Cách sinh dữ liệu | Hai mạng đấu nhau: bộ tạo và bộ phân biệt | Lặp lại nhiều bước khử nhiễu từ nhiễu thuần tuý |
| Số bước lấy mẫu | Một lần, rất nhanh | Hàng chục tới hàng trăm bước |
| Chất lượng ảnh chân thực | Khá tốt, dễ tạo hiện tượng lặp mẫu | Thường tốt hơn, đa dạng hơn |
| Kiểm soát đầu ra | Khó, phải huấn luyện lại từ đầu | Linh hoạt qua hướng dẫn và bộ điều khiển |
| Dùng chung bộ nhớ | Nhạy cảm, cần cân bằng hai mạng | Ổn định hơn, huấn luyện dễ chịu hơn |
Bảng trên cho thấy vì sao mô hình khuếch tán thắng thế ở các bài toán tạo ảnh chất lượng cao, đổi lại là chi phí suy luận lớn hơn hẳn. Với bài toán cần độ trễ thấp trên thiết bị yếu, nhiều nhóm vẫn chọn GAN hoặc mô hình tự hồi quy thay vì diffusion.
Xu hướng phát triển: từ năm 2022, hướng thay thế U-Net bằng Transformer cho tầng khử nhiễu đã cho thấy khả năng mở rộng quy mô tốt hơn, nhờ cơ chế chú ý xử lý quan hệ giữa các vị trí theo thứ tự. Bản Stable Diffusion XL dùng tầng khử nhiễu lớn hơn gấp ba, hai bộ mã hoá văn bản song song và một tầng tinh chế riêng để xử lý tỉ lệ khung hình. [Podell et al. 2023] Bên cạnh đó, các bộ chuyển hướng nhẹ cho phép khoá mô hình nền đã huấn luyện rồi chỉ huấn luyện phần phụ, nhờ đó tăng khả năng điều khiển tư thế hay nét vẽ mà không tốn chi phí huấn luyện lại toàn bộ. [Mou et al. 2023]
Kết luận: mô hình khuếch tán đã trở thành nền tảng của phần lớn hệ thống tạo ảnh ngày nay. Hướng nghiên cứu hiện tại tập trung vào việc lấy mẫu nhanh hơn, điều khiển chính xác hơn và đưa mô hình chạy được trên thiết bị nhỏ.
Nguồn tham khảo: