Knowledge distillation (KD) là một kỹ thuật nén mô hình trí tuệ nhân tạo cho phép chuyển giao kiến thức từ một mô hình lớn, phức tạp (gọi là teacher – thầy) sang một mô hình nhỏ gọn, nhanh hơn (gọi là student – học sinh) để có thể triển khai trên các thiết bị có tài nguyên hạn chế hoặc tăng tốc suy luận trong môi trường sản xuất. Khác với việc đơn giản cắt giảm tham số (pruning) hay giảm độ chính xác trọng số (quantization), KD tận dụng thông tin phong phú chứa trong phân phối xác suất đầu ra của mô hình teacher để hướng dẫn quá trình huấn luyện của mô hình student.
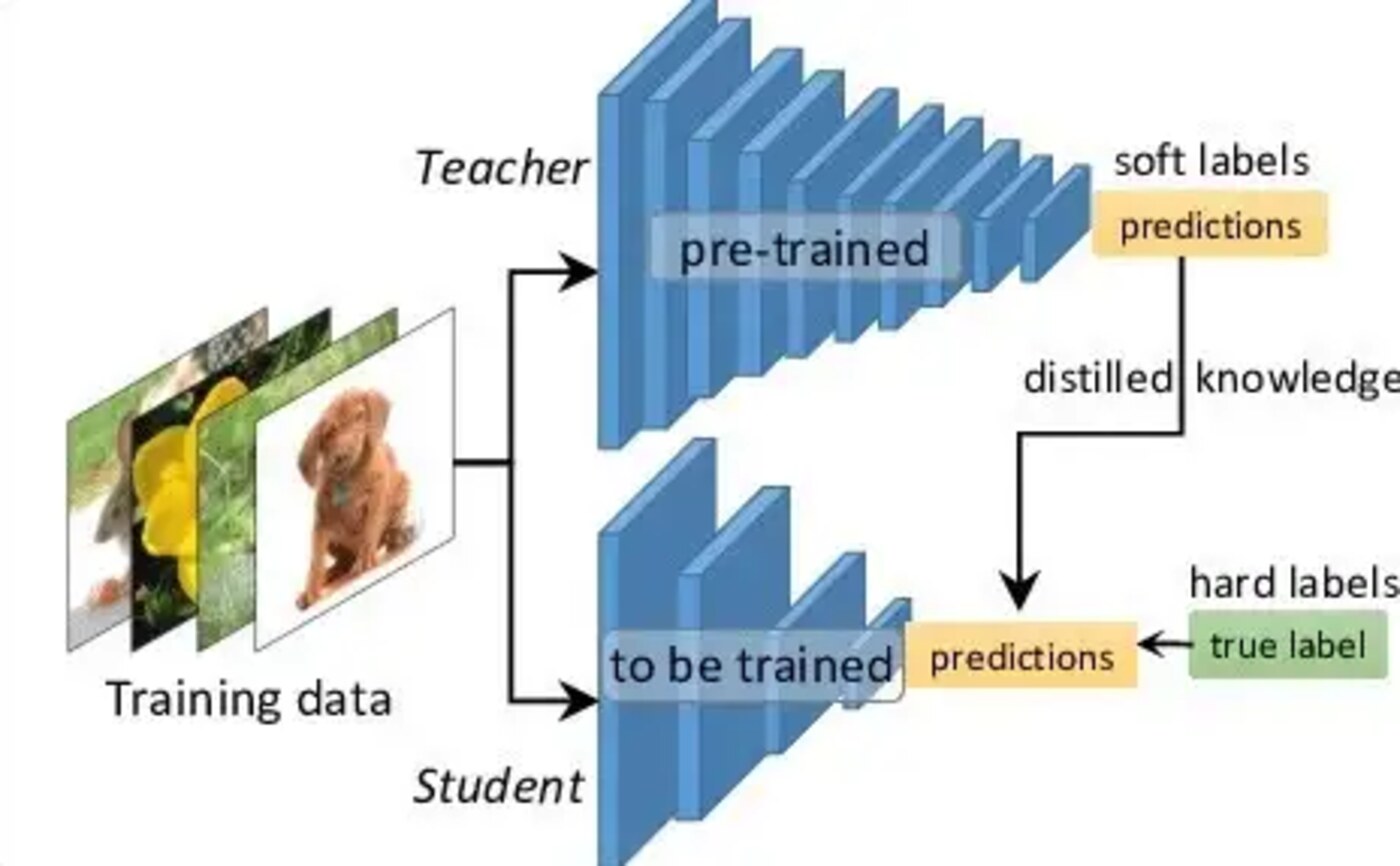
Nguyên lý teacher‑student: soft targets và KL divergence
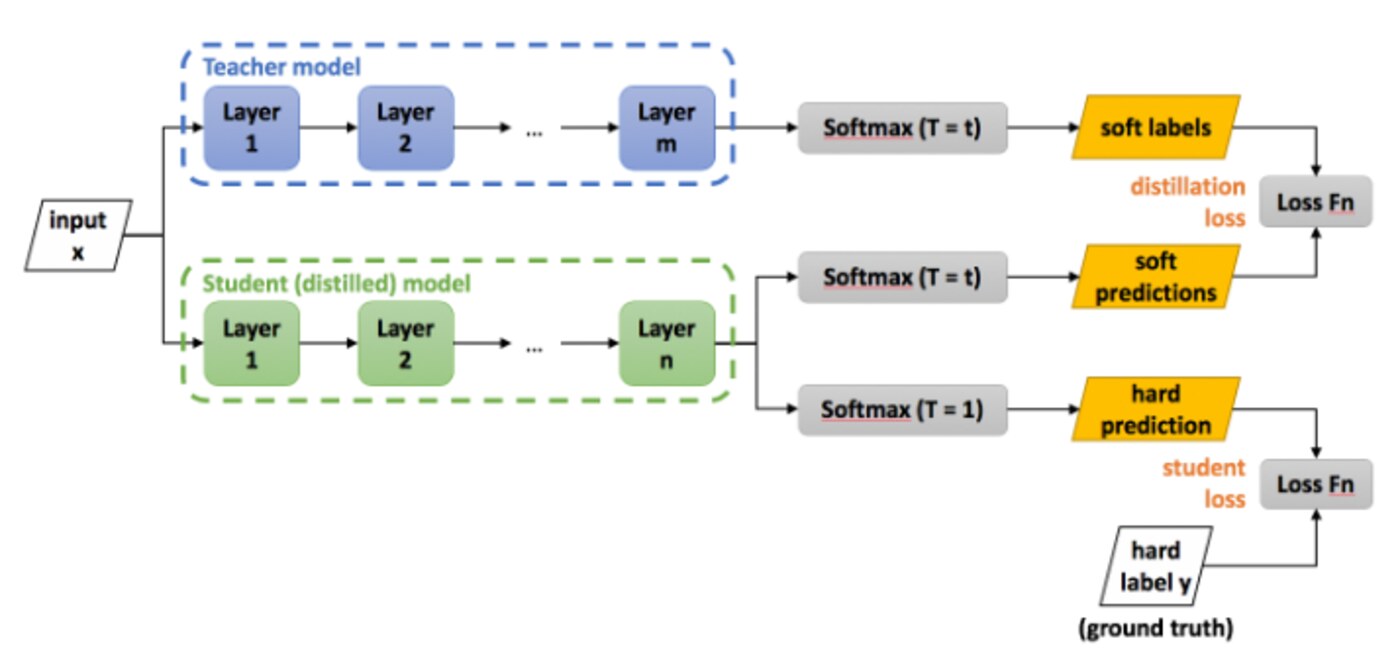
Mô hình teacher thường là một mạng nơ‑ron sâu (ví dụ: BERT, GPT‑3, ResNet‑152) đã được huấn luyện kỹ lưỡng trên một bộ dữ liệu lớn và đạt độ chính xác cao. Khi suy luận, teacher tạo ra các logits qua hàm softmax. Thay vì sử dụng nhãn cứng (hard labels – one‑hot encoding) như trong huấn luyện thông thường, KD cho phép student học từ các nhãn mềm (soft labels) là phân phối xác suất đầy đủ của teacher. Để làm mềm phân phối này, người ta áp dụng một tham số nhiệt độ T > 1 trong hàm softmax: khi T tăng, phân phối xác suất trở nên đều hơn, tiết lộ thêm thông tin về mối quan hệ giữa các lớp (ví dụ: một hình ảnh có thể giống vừa là chó vừa là mèo thay vì chỉ là một nhãn duy nhất). Hàm mất mát thông thường cho KD là KL divergence giữa softmax của student và teacher, được mở rộng bởi T² để giữ độ lớn gradient ổn định. Khi T → 1, học sinh chuyển về học từ nhãn cứng; khi T > 1, học sinh học từ phân phối mềm chứa thông tin tương quan phong phú mà nhãn cứng không thể biểu diễn được.
Kết hợp KD với các kỹ thuật nén khác
Một lợi thế lớn của KD là khả năng hoạt động hiệu quả cùng với các kỹ thuật nén khác như pruning (cắt kết nối neuron không quan trọng) và quantization (giảm bit trọng số). Nhiều nghiên cứu đã cho thấy:
- KD + pruning: sau khi student được huấn luyện bằng KD, có thể tiếp tục cắt bớt các kết nối có trọng số gần bằng không để thu nhỏ thêm mô hình mà không làm giảm đáng kể độ chính xác (ví dụ: MobileNets).
- KD + quantization: huấn luyện student ở độ chính xác thấp (int8, int4, thậm chí ternary) đồng thời sử dụng KD để giảm thiểu sự suy giảm hiệu suất (ví dụ: TernaryBERT, DistilBERT‑int8).
- KD + kiến trúc nhẹ: thay vì bắt đầu từ một teacher cực lớn, có thể chọn một teacher vừa phải (ví dụ: DistilBERT) để train một student cực nhỏ (ví dụ: TinyBERT), đạt được kích thước cực nhỏ nhưng vẫn đủ dùng trên thiết bị nhúng.
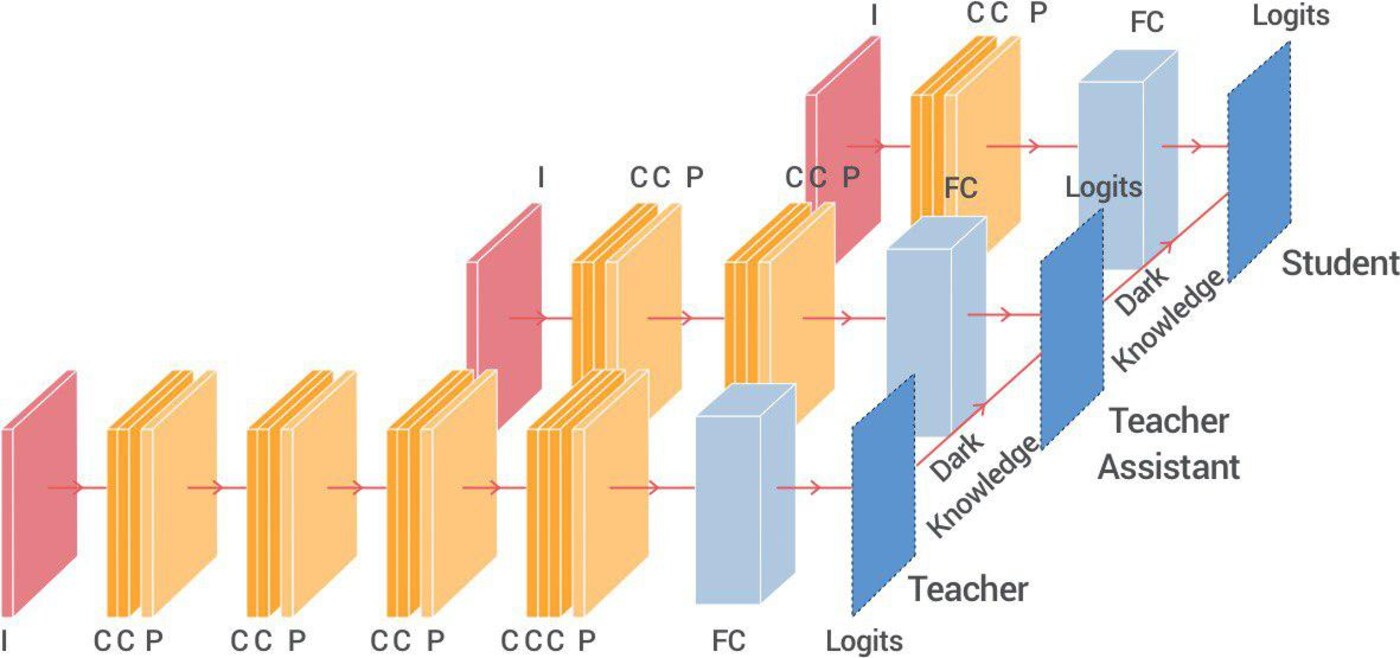
Teacher Assistant (TA): giảm chênh lệch dung lượng giữa teacher và student
Khi sự khác biệt về kích thước giữa teacher và student quá lớn (ví dụ: teacher 600M tham số, student 10M tham số), quá trình học trực tiếp từ teacher có thể gặp khó khăn do gradient biến đổi mạnh. Để giải quyết vấn đề này, các nghiên cứu đã đề xuất khái niệm Teacher Assistant (TA) – một mô hình trung gian có dung lượng nằm giữa teacher và student. Quy trình kiến tạo diễn ra theo hai giai đoạn: teacher → TA, sau đó TA → student. Kết quả từ bài báo “Improved Knowledge Distillation via Teacher Assistant” (arXiv:1902.03393) cho thấy phương pháp này làm giảm sự cố “vanishing gradient” khi student quá nhỏ so với teacher, giúp student hội tụ tốt hơn và đạt độ chính xác cao hơn KD trực tiếp. Đây là một cải tiến quan trọng khi áp dụng KD cho các mô hình cực nhỏ (ví dụ dưới 10M tham số).
Ứng dụng thực tế trong ngành
Knowledge distillation đã được áp dụng rộng rãi để triển khai mô hình AI lên các thiết bị có tài nguyên hạn chế và tăng tốc API suy luận đám mây. Một số ví dụ tiêu biểu bao gồm:
- DistilBERT: giảm 40% kích thước so với BERT, giữ 97% hiệu quả ngôn ngữ, nhanh hơn 60%, được sử dụng rộng rãi trong các ứng dụng xử lý ngôn ngữ tự nhiên trên thiết bị di động.
- MobileNetV2 và MobileNetV3: kết hợp KD với pruning và quantization để tạo ra các mô hình thị giác nhẹ chạy trên smartphone.
- DeepSeek‑R1 Distill: chuỗi các mô hình như DeepSeek‑R1‑Distill‑Qwen‑32B đạt 79.8 trên AIME 2024 và 97.3 trên MATH‑500, vượt trội so với qwen2.5‑32b‑zero, chứng minh khả năng chuyển giao mẫu suy luận phức tạp từ mô hình 671B tham số sang các mô hình dense nhỏ hơn.
- Phi‑1.5: mô hình 1.3B tham số đạt kết quả mạnh nhờ dữ liệu giáo khoa tổng hợp, cho thấy KD có thể hoạt động cùng với dữ liệu tổng hợp chất lượng cao.
Các hướng nghiên cứu và triển khai
Trong thực tế, các nhà phát triển thường sử dụng các framework như Hugging Face Transformers để tự động hóa quy trình teacher‑student. Các thành phần chính bao gồm:
- Chọn teacher là mô hình hiện có đạt SOTA (state‑of‑the‑art) trong nhiệm vụ mục tiêu (ví dụ: Llama‑3‑70B cho tạo văn bản, ResNet‑152 để phân loại hình ảnh).
- Chọn student là kiến trúc nhẹ hơn nhưng vẫn đủ sức để học (ví dụ: TinyBERT‑4L, DistilRoBERTa).
- Điều chỉnh nhiệt độ T (thường từ 2.0 tới 10.0) và trọng số loss KL divergence so với loss ground‑truth để tối ưu cho trường hợp cụ thể.
- Sử dụng dữ liệu không nhãn (unlabeled data) để tạo ra pseudo‑labels từ teacher khi dữ liệu có nhãn khan hiếm.
Kết luận, knowledge distillation không chỉ là một kỹ thuật nén mô hình độc lập mà là khung nền tảng cho phép kết hợp nhiều phương pháp (pruning, quantization, kiến trúc nhẹ) trong một quy trình huấn luyện thống nhất. Từ các mô hình ngôn ngữ lớn (LLM) như Llama‑3 cho đến các mạng nơ‑ron nhỏ trên thiết bị nhúng, KD đã và đang đóng vai trò then chốt trong việc làm cho AI trở nên tinh gọn, nhanh chóng và dễ tiếp cận hơn.