eBPF là gì? là câu hỏi thường gặp khi bạn đọc tài liệu vận hành hệ thống Linux hiện đại. eBPF (extended Berkeley Packet Filter) là một công nghệ cho phép chạy mã bytecode an toàn ngay bên trong nhân Linux, ở các điểm móc (hook) như lọc mạng, theo dõi hệ thống và kiểm soát bảo mật. Nhờ đó bạn theo dõi hay tăng tốc hệ thống mà không cần biên dịch lại nhân, không cần khởi động lại máy chủ.
Điểm cốt lõi của eBPF là cơ chế verifier: trước khi bất kỳ chương trình nào được nạp vào nhân, nhân phải chứng minh được chương trình đó an toàn bằng phân tích tĩnh. Nếu không chứng minh được, chương trình bị từ chối. Chính bước kiểm tra này đã loại bỏ phần lớn rủi ro của mô hình “nạp module vào nhân” truyền thống. Bài viết này đi từ nguyên lý, các giới hạn kỹ thuật, đến cách dùng thực tế với bpftool, libbpf và CO-RE.
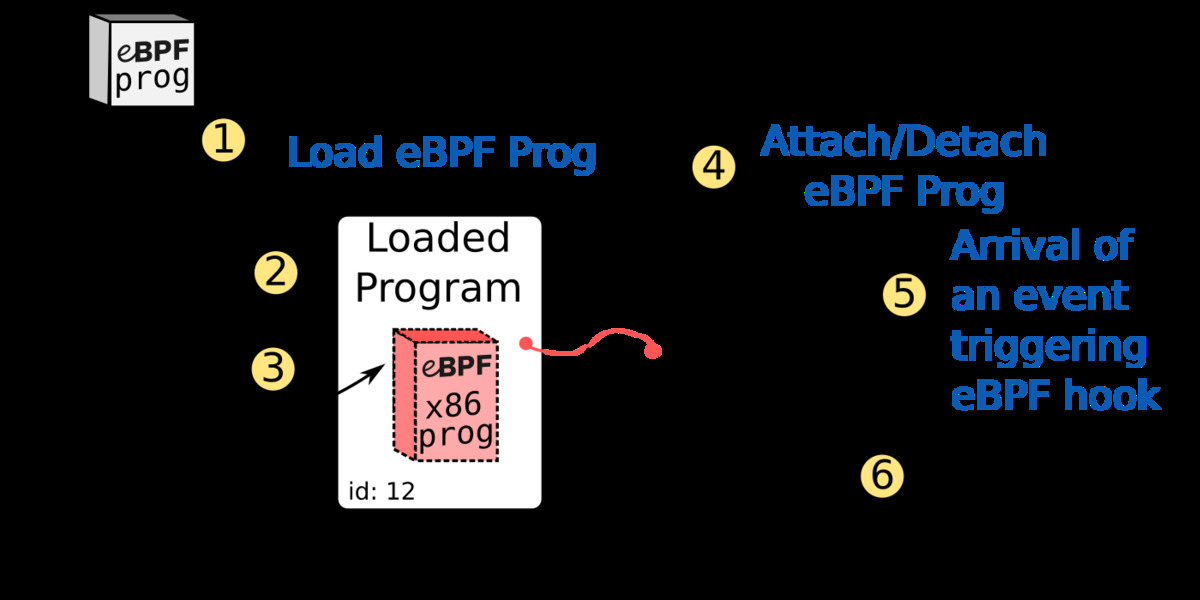
eBPF khác gì với module nhân và BPF cổ điển
BPF cổ điển (cBPF) là bộ lọc gói mạng ra đời từ thập niên 1990, vốn chỉ có hai thanh ghi 32 bit (A và X) và chỉ chạy ở một chỗ: đầu vào của stack mạng. eBPF mở rộng mô hình đó theo ba hướng:
- Tám mươi tư thanh ghi 64 bit thay cho hai thanh ghi 32 bit, đủ để làm phép số 64 bit và gọi hàm trực tiếp trong nhân.
- Nhiều loại chương trình chạy ở nhiều hook khác nhau, không chỉ ở đường vào của gói mạng.
- JIT compiler biên dịch bytecode sang mã máy ngay trong nhân. Bản JIT cho BPF cổ điển được hợp nhất vào Linux vào tháng 4 năm 2011; các bản JIT cho từng kiến trúc (x86-64, ARM32, AArch64 từ Linux 3.18; s390 từ 4.1; PowerPC 64 từ 4.8) lần lượt ra sau đó.
Các hook quan trọng nhất gồm XDP (chạy sớm ngay ở driver mạng, trước khi gói tin vào stack), TC (lưu lượng ở tầng traffic control), kprobe/tracepoint (theo dõi hàm lõi và điểm trace), LSM (móc vào khung bảo mật Linux Security Module) và UPROBE (móc vào hàm người dùng). Nhờ danh sách hook này, một chương trình eBPF duy nhất có thể theo dõi, lọc và kiểm soát ở nhiều tầng mà không cần sửa mã nguồn nhân.
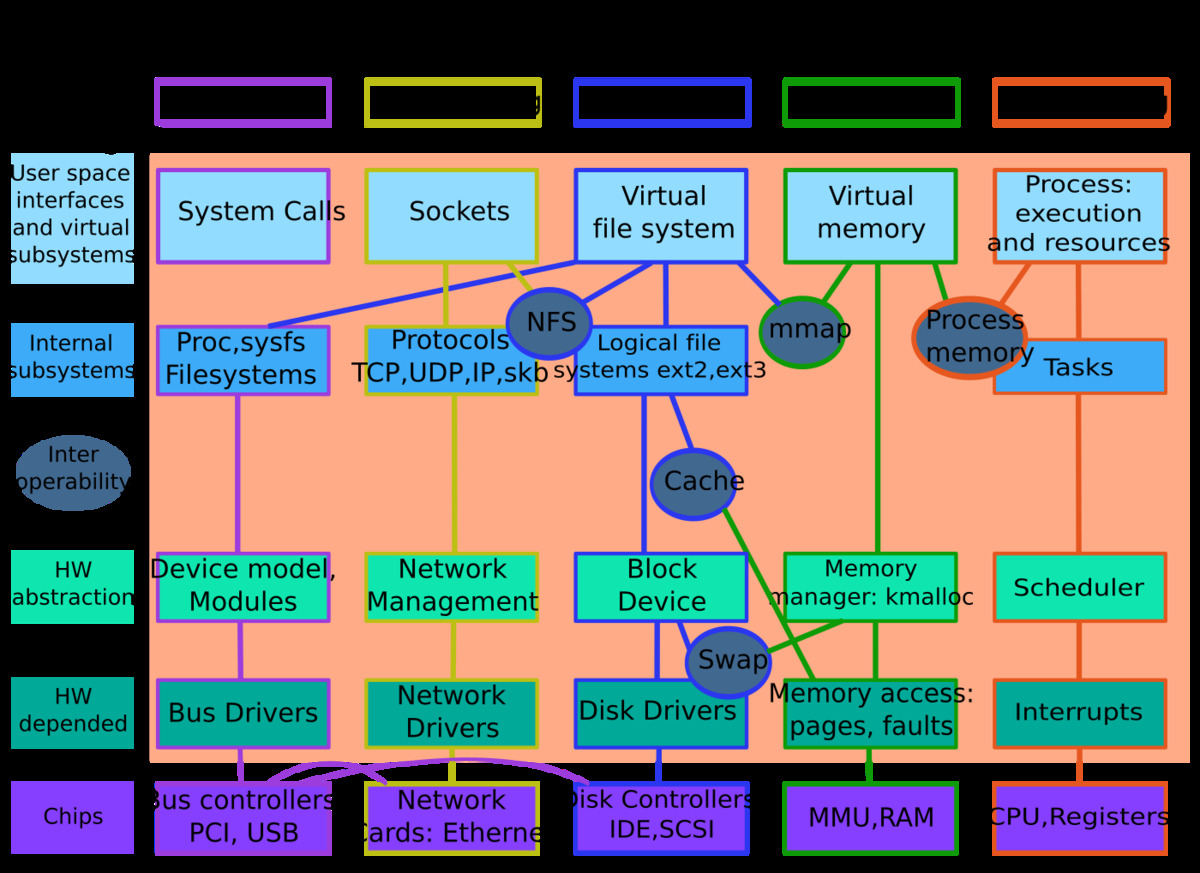
Verifier: lớp bảo vệ bắt buộc
Verifier là thành phần quyết định eBPF có an toàn hay không. Nó không chạy chương trình, mà phân tích tĩnh từng lệnh và mô phỏng trạng thái thanh ghi, con trỏ stack và giá trị biến tại mỗi nhánh điều khiển. Nếu tồn tại một đường đi khiến chương trình đọc hoặc ghi ra ngoài vùng được cấp, hoặc đọc biến chưa được khởi tạo, verifier từ chối ngay lập tức.
Chi tiết lấy từ tài liệu chính thức của nhân (docs.kernel.org/bpf/verifier.html) và mã nguồn include/linux/bpf.h, các giới hạn cứng hiện hành gồm:
| Giới hạn | Hằng số | Giá trị |
|---|---|---|
| Số lệnh tối đa mỗi chương trình | BPF_MAXINSNS |
1.000.000 |
| Ngân sách phức tạp của verifier | BPF_COMPLEXITY_LIMIT_INSNS |
1.000.000 |
| Kích thước stack của chương trình | MAX_BPF_STACK |
512 byte |
| Số thanh ghi | BPF_REG_0 đến BPF_REG_9 |
10 thanh ghi 64 bit |
Giới hạn stack 512 byte là con số đáng chú ý: chương trình eBPF không được phép khai báo mảng cục bộ lớn. Muốn giữ dữ liệu nhiều, bạn phải dùng map. Bản chất “stack nhỏ, map lớn” này là lý do eBPF hoạt động tốt trong các hook nóng như XDP, nơi mỗi gói tin đều phải xử lý thật nhanh.
Loại chương trình và loại map
Enum bpf_prog_type trong include/linux/bpf.h hiện có 33 loại chương trình (không tính BPF_PROG_TYPE_UNSPEC): từ SOCKET_FILTER, SCHED_CLS, KPROBE, TRACEPOINT, XDP, LSM cho tới SYSCALL, STRUCT_OPS và EXT. Mỗi loại có một tập hook và quyền được phép khác nhau, và verifier kiểm tra chương trình đúng với loại đã khai báo.
Enum bpf_map_type có 37 loại map. Nhóm phổ biến gồm HASH, ARRAY, LRU_HASH cho bảng tra cứu theo khóa; LPM_TRIE cho tra cứu tiền tố, rất tiện khi lọc địa chỉ IP; PROG_ARRAY để gắn nhiều chương trình vào cùng một hook; và RINGBUF để đẩy sự kiện sang userspace với chi phí rất thấp. Bản chất của map là vùng nhớ dùng chung giữa userspace và kernel, được bảo vệ bằng khóa đọc/ghi cơ bản thay vì cơ chế khóa nặng nề của hệ thống tệp thông thường.
CO-RE và libbpf: vì sao chương trình không vỡ khi nhân được nâng cấp
Khó khăn kinh điển của công cụ theo dõi hệ thống là phụ thuộc cấu trúc dữ liệu nhân. Nếu một tên trường trong struct task_struct đổi, công cụ cũ hỏng theo. eBPF giải quyết bằng CO-RE (Compile Once, Run Everywhere).
CO-RE dựa trên dữ liệu kiểu BTF (BPF Type Format) mà nhân xuất ra. Kiểu dữ liệu này nằm ở /sys/kernel/btf/vmlinux. Khi biên dịch, libbpf ghi lại offset tương đối thay vì offset cứng; đến lúc nạp chương trình, libbpf đọc BTF của nhân đang chạy để dịch offset đó sang offset thật. Kết quả là cùng một file đã biên dịch chạy được trên nhiều phiên bản nhân khác nhau. Tài liệu chi tiết nằm ở libbpf.readthedocs.io.
Chạy eBPF trong thực tế với bpftool
Hai lệnh nền tảng để kiểm tra chương trình đang chạy:
# liệt kê chương trình eBPF đang được nạp trong nhân
sudo bpftool prog list

# xem chi tiết một chương trình: loại, điểm gắn, số lệnh
sudo bpftool prog show id 42

# liệt kê map và loại map
sudo bpftool map list

# theo dõi tracepoint bằng chương trình mẫu có sẵn
sudo bpftool trace write /sys/kernel/tracing/trace_pipe
Để tự viết chương trình, bạn dùng thư viện libbpf và thường kèm clang với target bpf. Quy trình biên dịch tạo file object, sau đó libbpf nạp lên, gọi verifier, và nếu verifier duyệt thì gọi JIT để biên dịch sang mã máy rồi đính vào hook. Nếu hook là XDP, chương trình phải trả về một trong ba quyết định: XDP_PASS (cho gói tin đi tiếp), XDP_DROP (bỏ gói tin) hoặc XDP_TX (phát lại ra cổng khác).
Ứng dụng thực tế và hệ sinh thái
Ứng dụng nổi bật nhất của eBPF là mạng container. Cilium được giới thiệu tại LinuxCon vào tháng 8 năm 2016 như một dự án mạng container IPv6 tốc độ cao dựa trên eBPF và XDP, thay thế cho iptables và IPTables overlay truyền thống. Ngoài lĩnh vực mạng, eBPF còn dùng cho giám sát hiệu năng, truy vết phân tán, lọc log, bảo mật runtime và thống kê hệ thống.
Nền tảng eBPF Foundation được thành lập vào tháng 8 năm 2021 với các thành viên sáng lập gồm Meta, Google, Isovalent, Microsoft và Netflix. Quỹ này quản lý phần lõi và giúp eBPF trở thành công nghệ trung lập thay vì thuộc về một dự án thương mại đơn lẻ. Bối cảnh lịch sử đầy đủ được ghi trong bài Wikipedia về eBPF; chi tiết giao diện lập trình nằm ở trang hướng dẫn bpf(2) của man7.
Rủi ro cần biết
- Verifier là điểm thắt cổ chai. Chương trình phức tạp có thể bị từ chối vì hết ngân sách phân tích trong khi vẫn đúng ngữ nghĩa. Giải pháp là viết chương trình nhỏ, tách vòng lặp, dùng CO-RE và cây thư viện (CO-RE BTF) thay vì thử lại nhiều lần.
- Chương trình chạy ở ngữ cảnh nhân. Một vòng lặp vô hạn, một phép truy cập bộ nhớ sai hay một con trỏ treo trong hook XDP sẽ ảnh hưởng toàn hệ thống, không chỉ tiến trình của bạn.
- Bảo quản vòng đời map là bắt buộc. Map chỉ tồn tại khi có tham chiếu từ chương trình hoặc từ userspace. Đóng file descriptor sớm sẽ làm map biến mất, và các chương trình dùng map đó sẽ không tải lại được.
- Giới hạn stack 512 byte. Dữ liệu lớn bắt buộc phải nằm trong map; đây là giới hạn có chủ đích để bảo vệ hiệu năng trong đường nóng.
Kết luận
eBPF thay đổi bản chất của việc quan sát và thay đổi hệ thống Linux: thay vì biên dịch lại nhân hoặc nạp module không kiểm soát, bạn tải một chương trình nhỏ, để nhân tự chứng minh nó an toàn, rồi chạy nó ở đúng điểm móc cần thiết. Nhờ verifier và giới hạn stack 512 byte, bất kỳ lỗi trong chương trình eBPF cũng bị cô lập trong phạm vi hẹp hơn nhiều so với một lỗi trong module nhân thông thường.