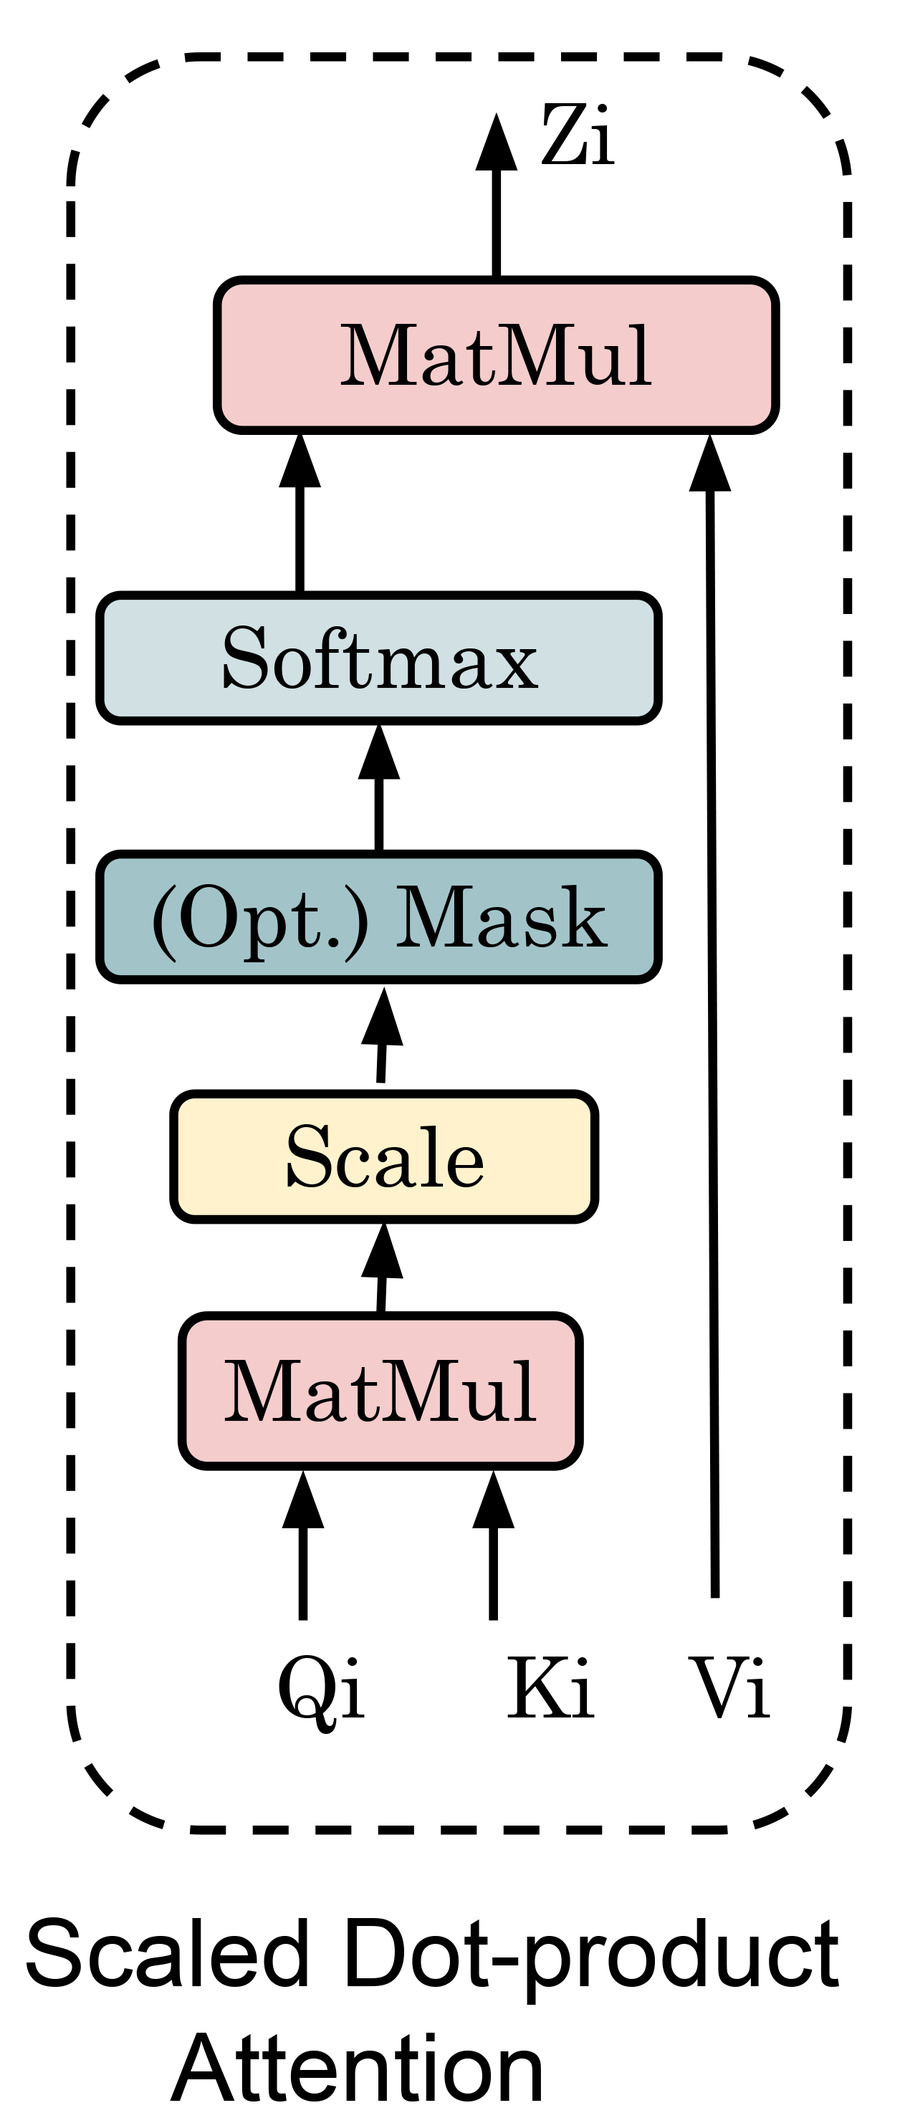
KV cache là gì? là bộ nhớ tạm trong quá trình suy luận mô hình ngôn ngữ lớn, dùng để lưu lại kết quả trung gian của lớp attention mỗi token được tạo ra. Khi mô hình sinh một token mới, nó không cần tính lại toàn bộ attention từ đầu vì các khóa (key) và giá trị (value) của tất cả token trước đã được lưu trong KV cache. Thiết kế này giúp độ trễ mỗi token được sinh ra chỉ phụ thuộc vào kích thước của cache thay vì độ dài toàn bộ prompt.
Điểm thắt cổ chai thực tế không phải là khả năng tính toán mà là băng thông bộ đệm cao cấp (HBM). Mỗi lần sinh token mới, nhân bản phải đọc toàn bộ KV cache ra để thực hiện phép nhân ma trận–vector, khiến đơn vị xử lý GRAPHIC (GPU) hoạt động ở mức využív năng thấp và độ trễ chủ yếu bị quyết định bởi thời gian truy xuất bộ nhớ. Bài viết này giải thích công thức bộ nhớ, cách các kỹ thuật như GQA, MQA và PagedAttention giảm bớt tải, và liệt kê các giải pháp nén và thổi bay cache để tăng công suất.
Công thức bộ nhớ mỗi token trong KV cache
Để lưu trữ khóa và giá trị cho một token trong một lớp attention, mô hình cần giữ hai ma trận: một cho khóa (K) và một cho giá trị (V). Kích thước của mỗi ma trận phụ thuộc vào:
- số lớp attention
n_layers - số đầu attention mỗi lớp
n_heads(đối với MHA) - kích thước vector mỗi đầu
head_dim - số byte mỗi phần tử (giả sử fp16 là 2 byte)
Công thức tổng bộ nhớ cho một token là:
2 × n_layers × n_heads × head_dim × 2 byte
Hệ số 2 xuất phát vì mỗi token cần lưu cả K và V. Đối với mô hình LLaMA-2 7B (32 lớp, 32 đầu attention, head_dim 128, sử dụng fp16):
2 × 32 × 32 × 128 × 2 = 524.288 byte ≈ 512 KiB/token
Đối với chuỗi dài 2048 token, bộ nhớ KV cache tầm 1,64 GB ≈ 1,7 GB, con số khớp với dữ liệu đo được trên vLLM blog. Theo cùng công thức, LLaMA-2 13B (40 lớp, 40 đầu) tốn khoảng 800 KiB/token, và bộ nhớ cache cho 2048 token khoảng 3,2 GB.
Tại sao KV cache làm giảm hiệu suất GPU trong giai đoạn sinh?
Giai đoạn tiền xử lý (prefill) xử lý toàn bộ prompt cùng lúc bằng phép nhân ma trận–ma trận, đơn vị xử lý GRAPHIC hoạt động ở mức sử dụng cao. Giai đoạn sinh (decode) xử lý một token một lần bằng phép nhân ma trận–vector, khi toàn bộ KV cache phải được đọc ra mỗi lần. Điều này đưa đơn vị xử lý GRAPHIC vào tình trạng “bị throttling bởi bộ nhớ”, nghĩa là bộ xử lý đứng chờ đợi dữ liệu từ HBM thay vì thực hiện phép tính. Kết quả là phần lớn thời gian mỗi token sinh ra được tiêu tốn cho truy xuất bộ nhớ chứ không phải cho tính toán.
Đo lường trong bài báo gốc về PagedAttention (arXiv:2309.06180) cho thấy giai đoạn sinh là “phần lớn delays trong một request” và “đơn vị xử lý GRAPHIC bị sử dụng thấp do IO–bound”.
Giảm kích thước cache bằng GQA và MQA
Thay vì mỗi đầu attention có bộ khóa và giá trị riêng, GQA (Grouped-Query Attention) và MQA (Multi-Query Attention) chia sẻ bộ khóa và giá trị cho nhiều đầu truy vấn. Khi số đầu truy vấn n_q lớn hơn số đầu khóa/giá trị n_kv, bộ nhớ mỗi token giảm theo tỉ lệ n_q / n_kv.
Ví dụ: Mistral 7B dùng GQA với 32 đầu truy vấn nhưng chỉ 8 đầu khóa và giá trị → bộ nhớ mỗi token giảm còn 1/4 so với MHA tiêu chuẩn. MQA đi một bước tới khi chỉ có một đầu khóa/giá trị cho toàn bộ lớp → giảm thiểu tối đa đến 1/32. Tham khảo bài báo gốc về GQA (arXiv:2305.13245) để thấy sự cân bằng giữa chất lượng mô hình và giảm kích thước bộ nhớ.
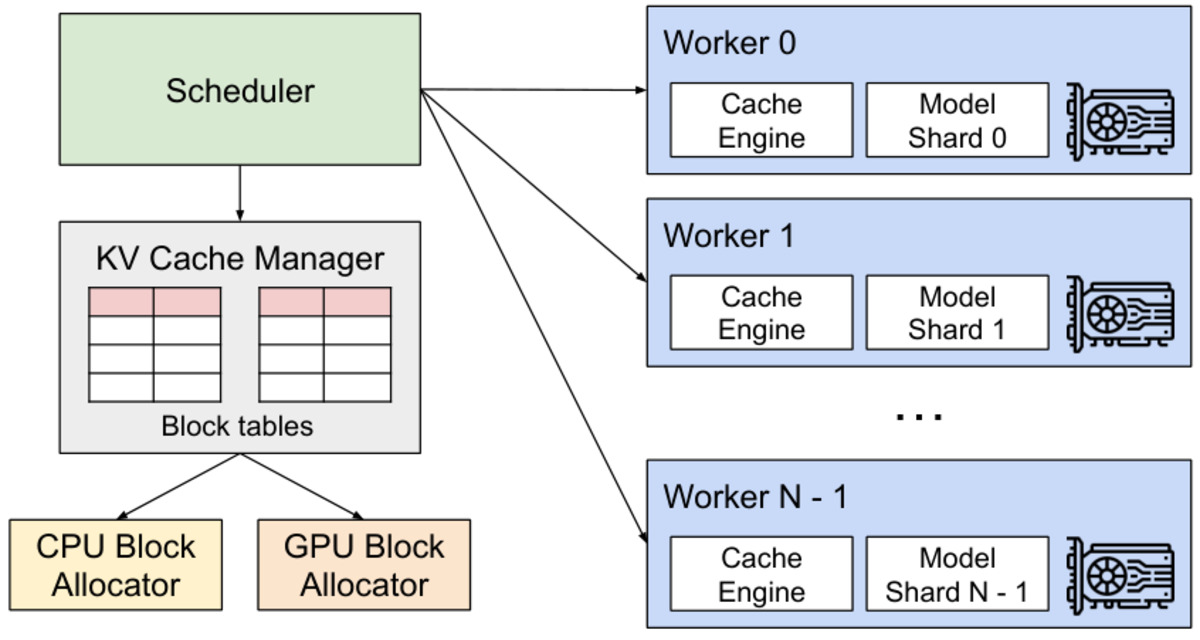
PagedAttention và vLLM: lưu trữ không liên tục để giảm lãng phí
Các hệ thống truyền thống thường lưu KV cache dưới dạng một mảnh bộ nhớ liên tục, dẫn tới tình trạng một phần lớn bộ nhớ được cấp giữ trống vì các chuỗi có độ dài khác nhau. PagedAttention thay đổi cách lưu trữ bằng cách chia KV cache thành các block có kích thước cố định (ví dụ 16 token mỗi block). Các block này có thể được đặt ở bất kỳ nơi nào trong bộ nhớ GPU, tương tự cách hệ thống quản lý bộ nhớ ảo bằng các trang.
Kết quả là tỷ lệ lãng phí bộ nhớ giảm xuống dưới 4% trong nhiều trường hợp thực tế, so với 60–80% trong hệ thống không có PagedAttention. Công suất sinh tăng 2–4 lần so với FasterTransformer và Orca khi cùng chạy trên cùng phần cứng. Tất cả thông số này được trích từ bài báo PagedAttention (arXiv:2309.06180), nơi tác giả cũng cho thấy tỷ lệ sử dụng bộ nhớ thực tế tăng từ 20–38% lên gần 100%.
Giảm bộ nhớ bằng nén KV cache
Một hướng tiếp cận khác là giảm số bit dùng để lưu mỗi phần tử trong KV cache. KIVI (2-bit KV quantization) áp dụng phân vị bất đối xứng 2-bit cho khóa và giá trị mỗi kênh và mỗi token. Kết quả là bộ nhớ mỗi token giảm xuống khoảng 38% so với fp16 (tức là giảm hơn 2,6 lần), cho phép xử lý nhiều chuỗi song song hơn cùng lúc và tăng công suất từ 2,35 lần lên 3,47 lần trên các mô hình như Llama, Falcon và Mistral.
Các giải pháp nén khác thường tập trung vào phần giá trị vì nó thường thay đổi chậm hơn khóa trong nhiều trường hợp sử dụng. Tuy nhiên, KIVI đã chứng minh mức độ nén 2-bit thực tế vẫn giữ được độ chính xác của mô hình phù hợp cho hầu hết các tình huống triển khai.
Giảm thời gian tăng cache bằng sliding window và streaming attention
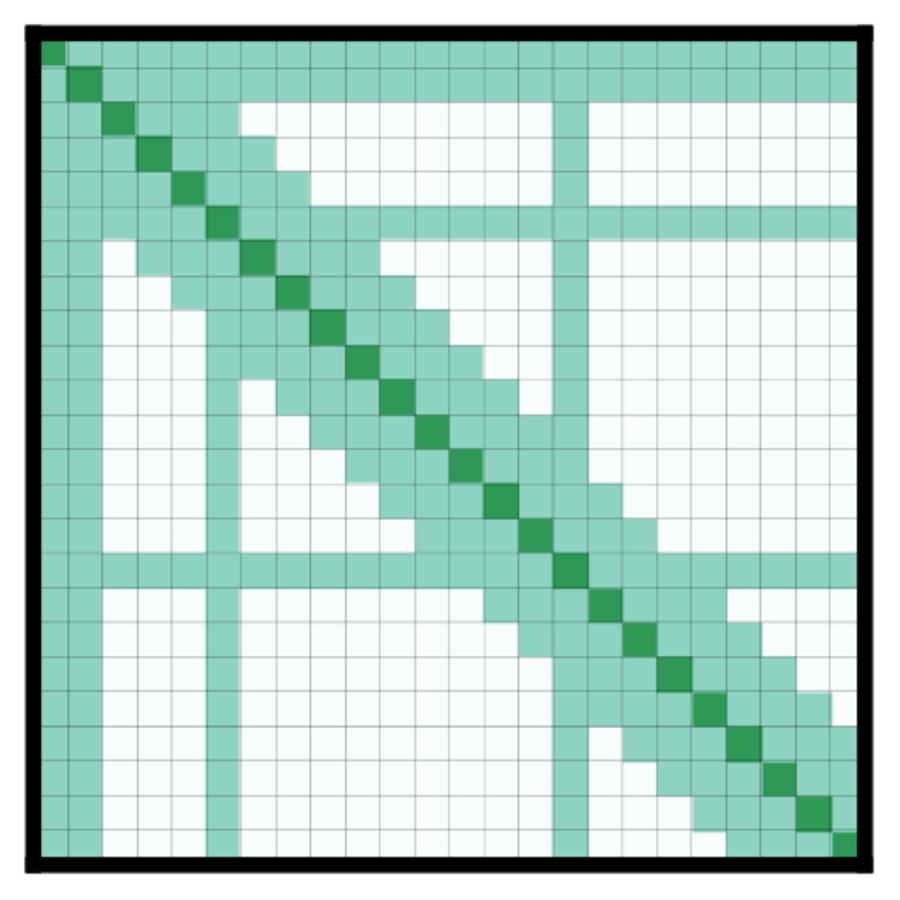
Nếu ứng dụng cho phép bỏ qua một phần lịch sử rất xa, mô hình có thể áp dụng cơ chế attention trượt (sliding window) hoặc attention theo luồng (streaming). Trong trường hợp sliding window, mô hình chỉ lưu khóa và giá trị của W token gần nhất; mỗi khi token mới đến, token cũ nhất bị đẩy ra khỏi bộ nhớ. Ví dụ: Mistral áp dụng cửa sổ trượt 4096 token, tức là bộ nhớ cache tối đa không bao giờ vượt quá W × 2 × n_layers × n_heads × head_dim × 2 byte.
Công cụ lưu trữ dài hạn khác là attention toàn cục task-specific như trong Longformer, nơi một số token được đánh dấu để luôn được lưu, trong khi chuỗi còn lại vẫn tuân theo luật sliding window. Kết hợp hai kỹ thuật này, bộ nhớ cache tăng gần như tuyến tính với độ dài chuỗi thay vì bậc hai, cho phép xử lý chuỗi rất dài mà không làm tràn bộ nhớ GPU.
Tối ưu tiền xử lý bằng Prefix Caching tự động
Trong môi trường dịch vụ, nhiều request thường có tiền tố giống nhau (ví dụ system prompt hoặc tài liệu chung). Thay vì lưu trữ và tính lại tiền tố đó cho mỗi request, vLLM tự động phát hiện và tái sử dụng KV cache của tiền tố đã thấy qua cơ chế Automatic Prefix Caching (APC). Khi một request mới đến, hệ thống kiểm tra xem tiền tố của nó đã có trong cache chưa; nếu có, nó bỏ qua bước tính toán và cấp phát bộ nhớ cho phần đó và chuyển ngay tới phần đầu tiên chưa từng thấy.
Tài liệu chính thức của vLLM cho biết APC cho phép hệ thống “xử lý một tài liệu dài chỉ một lần” và các request tiếp theo tránh lại tính toán lại cùng tài nguyên. Kết quả là lượng tài nguyên GPU được tiết kiệm cho các trường hợp có nhiều tài liệu chung hoặc lời nhắc chung.
Các chính sách thi bay cache
Khi bộ nhớ GPU bắt đầu khan hiếm, hệ thống buộc phải lựa chọn token nào được giữ lại trong cache và token nào bị loại bỏ. Ba chiến lược nghiên cứu gần đây là:
- H2O: giữ lại token mới hiện hạng và token “trọng tượng” (heavy-hitter). Kết quả là độ trễ giảm tới 1,9 lần và công suất tăng tới 29 lần so với các hệ thống không có chiến lược.
- Scissorhands: duy trì ước lượng tầm quan trọng của mỗi token trong một cửa sổ trượt, từ đó giữ lại bộ nhớ cố định và xóa đi các token thấp thước. Kết hợp với nén 4-bit, đạt được mức nén tới 20 lần.
- SnapKV: chỉ giữ lại vị trí khóa quan trọng trong mỗi đầu attention, sau đó nén chúng. Kết quả là tốc độ sinh tăng tới 3,6 lần và hiệu suất bộ nhớ tăng tới 8,2 lần, cho phép xử lý tới 380.000 token trên một card A100-80GB.
Tất cả ba phương pháp đều được công bố trên arXiv: H2O (arXiv:2306.14048), Scissorhands (arXiv:2305.17118) và SnapKV (arXiv:2404.14469).
Tình quan hệ giữa FlashAttention và KV cache
FlashAttention (và các phiên bản sau như FlashAttention-2 và FlashAttention-3) là một kernel IO-aware để tính toán attention nhanh hơn bằng cách chia lại các phép đọc và ghi vào HBM. Tuy nhiên, FlashAttention thay đổi chỉ cách tính toán attention mà thay đổi kích thước bộ nhớ cần lưu trữ cho mỗi token. Khóa và giá trị vẫn phải được lưu trữ trong HBM vì chúng sẽ được dùng lại trong các token sinh sau đó.
Nói cách khác, FlashAttention giúp phép tính attention chạy nhanh hơn và tiêu tốn ít điện hơn, nhưng bộ nhớ cần để lưu trữ khóa và giá trị của mỗi token không đổi. Kết quả là bạn vẫn cần PagedAttention, GQA/MQA hoặc một trong các chiến lược thi bay cache để kiểm soát mức tiêu thụ bộ nhớ thực tế.
Kết luận
KV cache là trái tim của quá trình suy luận mô hình ngôn ngữ lớn mà cũng là nguyên nhân chính mà độ trễ mỗi token sinh ra trở nên cao trong nhiều trường hợp thực tế. Để giảm bớt độ trễ và tăng công suất, nhà phát triển có tới ba bộ công cụ:
- Giảm kích thước cache mỗi token bằng GQA, MQA hoặc các mô hình có số đầu attention ít.
- Thay đổi cách lưu trữ để giảm lãng phí bộ nhớ bằng PagedAttention hoặc các hệ thống tương tự.
- Thi bay cache khi bộ nhớ gần đầy bằng H2O, Scissorhands hoặc SnapKV.
Kết hợp ba bộ công cụ trên, một hệ thống suy luận có thể xử lý hàng nghìn request mỗi giây trên cùng một thiết bị phần cứng, trong khi vẫn duy trì chất lượng và độ trễ ở mức khả dụng cho sản phẩm.