BERT là gì: mô hình nền tảng cho xử lý ngôn ngữ tự nhiên
BERT (Bidirectional Encoder Representations from Transformers) là mô hình ngôn ngữ hai chiều dựa trên kiến trúc Transformer, được giới thiệu bởi Google năm 2018. BERT đã trở thành nền tảng cho phần lớn các mô hình ngôn ngữ hiện đại, từ tìm kiếm, phân loại văn bản cho tới chatbot và trích xuất thông tin.
Vấn đề BERT giải quyết
Trước đây, để đọc hiểu câu văn, các mô hình chỉ nhìn được một chiều. Mô hình dự đoán từ kế tiếp phải xử lý câu từ trái sang phải, nên khi gặp một từ chưa rõ nghĩa, nó buộc phải đoán mà không có ý nghĩa của những từ phía sau. Với tiếng Việt hay tiếng Anh, đây là hạn chế lớn vì nhiều từ chỉ có nghĩa khi nhìn toàn bộ câu.
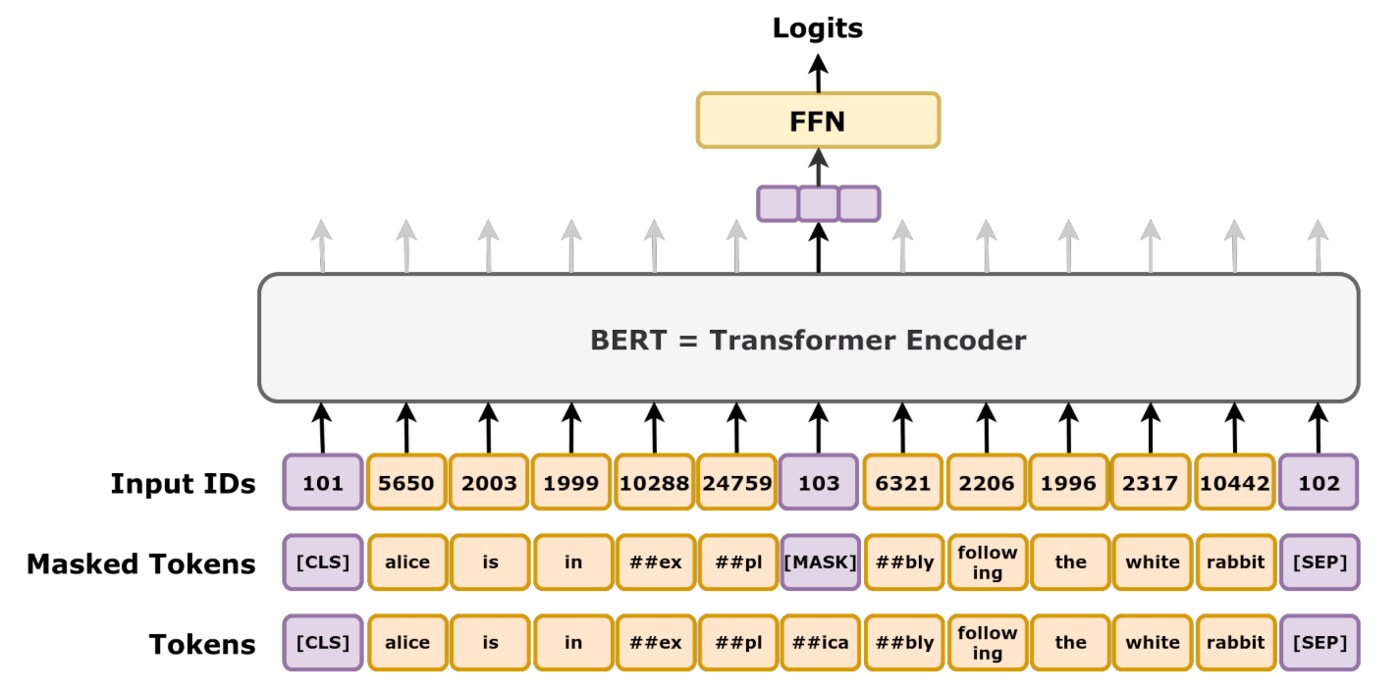
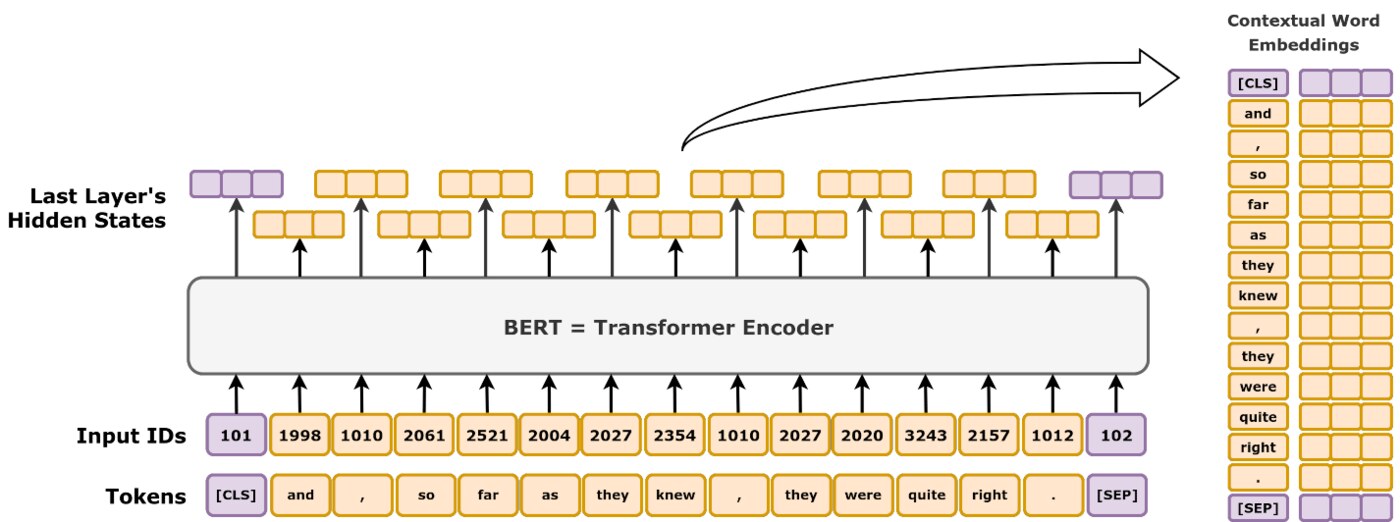
BERT xử lý vấn đề này bằng cách làm ngược lại: che bớt các từ trong câu rồi bắt mô hình đoán lại từ bị che, nhờ đó mỗi từ đều phải dựa vào ngữ cảnh hai bên để hình thành biểu diễn. Nhờ đó một từ trong ngữ cảnh khác nhau sẽ có vector khác nhau, ví dụ từ bóng đèn trong câu về đèn và bóng đèn trong câu về bóng đáy cùng.
Kiến trúc của BERT
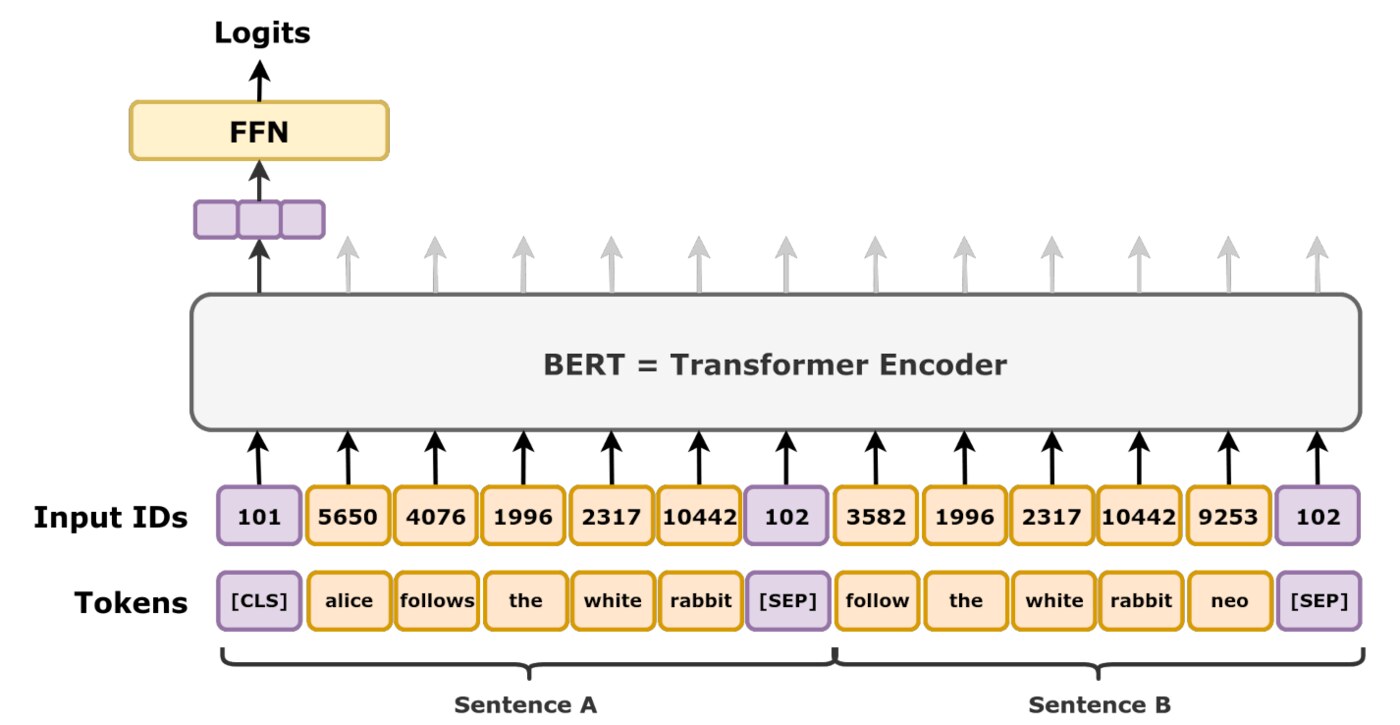
BERT chỉ dùng phần encoder của kiến trúc Transformer, không có decoder như các mô hình sinh văn bản, nên được gọi là mô hình chỉ-encoder. Đầu vào là một chuỗi token đã được tách nhỏ bằng thuật toán WordPiece, rồi qua ba phép biến đổi: mỗi token được ánh xạ thành vector nhúng, cộng với vector vị trí để biết thứ tự, và cộng với vector phân loại đoạn để phân biệt câu nào thuộc đoạn nào.
Kích thước các phiên bản
| Phiên bản | Số tầng | Chiều ẩn | Đầu chú ý | Số tham số |
|---|---|---|---|---|
| BERT-base | 12 | 768 | 12 | 110 triệu |
| BERT-large | 24 | 1024 | 16 | 340 triệu |
Cấu hình mặc định của BERT-base gồm 12 tầng, chiều ẩn 768, kích thước tầng trung gian 3072, từ điển 30.522 token WordPiece và tối đa 512 vị trí. Bản BERT-large có kích thước tầng trung gian 4096 và vẫn giữ giới hạn 512 vị trí.
Hai bài toán tiền huấn luyện
BERT không huấn luyện bằng cách dự đoán từ kế tiếp như GPT, mà dùng hai bài toán song song để mô hình vừa hiểu cấu trúc từ vừa hiểu quan hệ giữa các câu.
Bài toán một: mô hình hóa ngôn ngữ có che
BERT che ngẫu nhiên 15% các token WordPiece trong chuỗi đầu vào, rồi yêu cầu mô hình dự đoán lại những token đó. Vì phải suy luận từ cả phía trước lẫn phía sau, mô hình buộc phải học cách dựng một biểu diễn ngữ cảnh cho mỗi từ thay vì chỉ ghi nhớ một nghĩa cố định.
Bài toán hai: dự đoán câu kế tiếp
BERT nhận một cặp câu và phân loại nhị phân xem câu thứ hai có thực sự nối tiếp câu đầu hay chỉ được ghép cạnh nhau ngẫu nhiên. Bài toán này buộc mô hình học cách đánh giá sự liên kết giữa các câu, hữu ích cho những tác vụ cần hiểu nội dung trải rộng nhiều đoạn.
Dữ liệu và kết quả tinh chỉnh
BERT được tiền huấn luyện trên kho văn bản BooksCorpus khoảng 800 triệu từ cộng với bản Wikipedia tiếng Anh khoảng 2,5 tỷ từ. Sau đó chỉ cần thêm một lớp đầu ra đơn giản và tinh chỉnh trên tập dữ liệu nhỏ của từng tác vụ, mô hình đã đạt kết quả dẫn đầu trên 11 nhiệm vụ xử lý ngôn ngữ tự nhiên.
Trên bộ GLUE, BERT-base đạt điểm trung bình 79,6 và BERT-large đạt 82,1. Trên bộ SQuAD 1.1, BERT-base đạt 80,8 điểm khớp chính xác và 88,5 điểm F1, còn BERT-large đạt 84,1 và 90,9. Với bản kết hợp nhiều mô hình, điểm F1 đạt 91,6 trong khi mốc trung bình của con người là 91,2. Trước khi BERT xuất hiện, kỷ lục trên GLUE kém trung bình tới 7,6 điểm tuyệt đối.
Các biến thể đáng chú ý
- RoBERTa năm 2019: huấn luyện trên 160 GB văn bản với cách che token thay đổi liên tục, cho thấy BERT gốc thực ra bị huấn luyện chưa đủ.
- DistilBERT năm 2019: nhỏ hơn 40%, nhanh hơn 60%, vẫn giữ khoảng 97% năng lực của bản gốc.
- ALBERT năm 2019: tách riêng phần nhúng và dùng chung tham số giữa các tầng để tiết kiệm bộ nhớ, bản base chỉ còn khoảng 12 triệu tham số.
- DeBERTa năm 2020: tách cơ chế chú ý thành hai phần, đạt 89,9 điểm SuperGLUE với mô hình 1,5 tỷ tham số, sát người với mức 89,8.
Cách dùng BERT trong thực tế
Do được phát hành với giấy phép mở nguồn, BERT có sẵn trên các thư viện như Hugging Face Transformers, nên việc tải và tinh chỉnh rất nhanh. Người dùng phổ thông chỉ cần tải một mô hình đã huấn luyện sẵn cho tác vụ cần dùng, ví dụ phân loại văn bản, trả lời câu hỏi theo đoạn hay gán nhãn thực thể trong câu. Bản BERT tiếng Anh phổ biến nhất là bert-base-uncased và bert-large-uncased, còn với tiếng Việt thì mô hình đa ngôn ngữ thường phù hợp hơn vì BERT gốc chỉ huấn luyện trên tiếng Anh.
Nguồn tham khảo: bài báo BERT hội nghị NAACL, bản thảo BERT trên arXiv, tài liệu mô hình BERT trên Hugging Face, thông báo phát hành mã nguồn mở của Google.