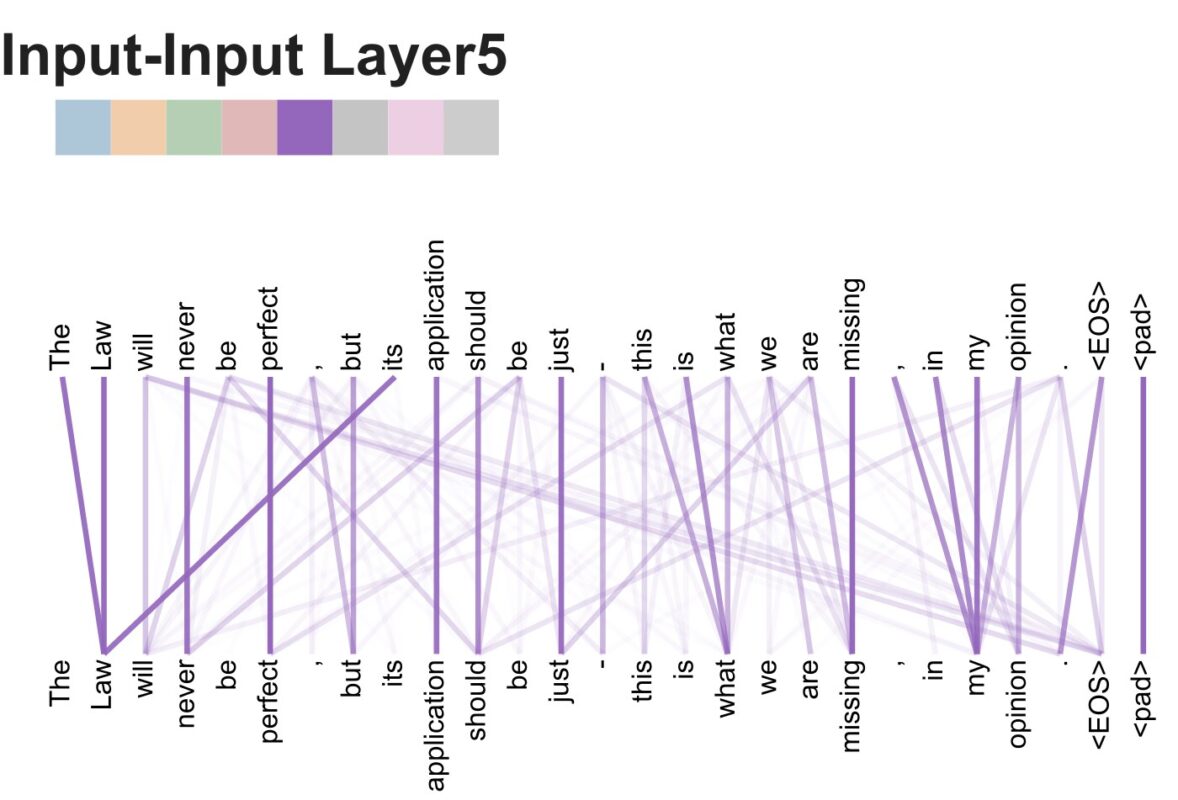
Self-attention là gì: Q, K, V và cách mô hình ngôn ngữ tính ngữ cảnh
Self-attention là cơ chế cho phép mô hình ngôn ngữ tự tính mối quan hệ giữa mọi vị trí trong cùng một chuỗi, thay vì đọc chuỗi theo thứ tự như RNN hay tích chập. Nhờ đó, khi xử lý từ “nó” ở cuối câu, mô hình biết ngay “nó” chỉ đường dẫn tới danh từ nào đứng trước đó, bất kể hai từ đó cách nhau bao nhiêu token. Bài viết này bóc từng bước cách cơ chế này hoạt động, từ ba ma trận Q, K, V đến multi-head attention và lý do chi phí tính toán tăng theo bậc hai với độ dài chuỗi.
Self-attention sinh ra từ đâu
Khái niệm self-attention được hình thức hoá trong bài A Structured Self-attentive Sentence Embedding của Lin và cộng sự, nhưng chính bài báo Attention Is All You Need mới đưa nó vào kiến trúc Transformer và làm nó trở thành chuẩn mực của mọi mô hình ngôn ngữ lớn sau này. Điểm đột phá của Transformer nằm ở chỗ kiến trúc này không dùng tích chập hay hồi quy, mà chỉ dựa hoàn toàn vào cơ chế chú ý để truyền thông tin giữa các vị trí.
Trước đó, kiến trúc đọc chuỗi tuần tự gặp một giới hạn cứng: muốn kết nối từ ở vị trí i với từ ở vị trí j, đường đi của thông tin phải đi qua trung gian mọi vị trí ở giữa. Chuỗi càng dài, đường đi càng xa và thông tin càng bị suy hao. Self-attention bỏ hẳn giới hạn đó: mỗi vị trí được kết nối trực tiếp với mọi vị trí khác trong chỉ một bước.
Ba ma trận Q, K, V sinh ra từ đâu
Bước đầu tiên của self-attention là biến mỗi token thành ba vector: query (truy vấn), key (khóa) và value (giá trị). Trong bài minh hoạ của Jay Alammar, mỗi word embedding được nhân với ba ma trận trọng số riêng biệt để sinh ra ba vector tương ứng. Nói cách khác, cùng một token sẽ mang ba vai trò khác nhau trong cùng một phép tính.
Sau đó mỗi vị trí tính điểm tương tự giữa query của nó và key của tất cả các vị trí khác. Điểm số đó được chia cho căn bậc hai của số chiều khóa, rồi đưa qua hàm softmax để thành trọng số có tổng bằng 1. Cuối cùng, đầu ra của vị trí đó là tổng có trọng số của tất cả vector value, theo đúng trọng số vừa tính.
scores = matmul(query, key.transpose(-2, -1)) / sqrt(d_k)
weights = softmax(masked_fill(scores, mask, -1e9))
output = matmul(weights, value)
Đoạn mã trên là cách The Annotated Transformer của Harvard NLP hiện thực hoá phép tính này bằng PyTorch. Ba dòng lệnh tương ứng ba bước: tính điểm, chuẩn hoá softmax, rồi trộn value.
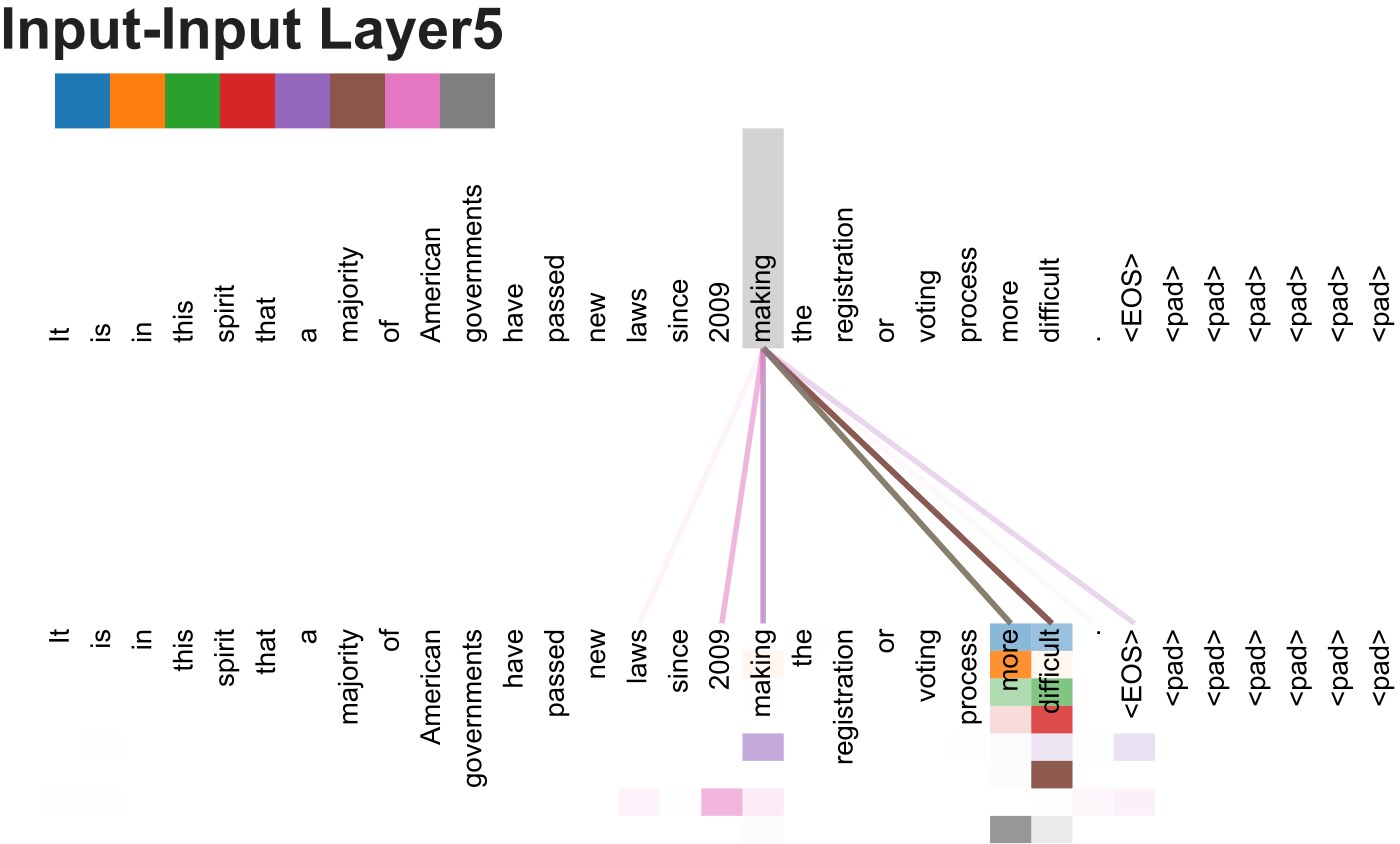
Hình thể hiện trực quan hóa từ các thí nghiệm trong bài gốc: mỗi lần đầu vào được nối với các từ khác bằng đường mảnh, độ đậm cho biết trọng số chú ý. Điều đáng chú ý là mô hình không được lập trình để học quan hệ này, mà tự tìm ra từ dữ liệu: từ “making” và “difficult” chằng chằng có đường nối đậm, vì chúng là hai từ đi nghĩa với nhau trong ngữ cảnh.
Tại sao phải chia cho căn bậc hai
Bước chia cho căn bậc hai của số chiều khóa không phải chi tiết vụn vặt. Khi số chiều lớn, tích chập giữa các vector có xu hướng phình to về độ lớn, đẩy đầu vào softmax vào vùng bão hoà nơi gradient gần bằng không, khiến quá trình huấn luyện chậm và dễ bất ổn. Trong ví dụ của Alammar với số chiều 64, hệ số chia là 8, và đây chính là hệ số được dùng trong bài gốc cũng như trong phần lớn triển khai thực tế.
| Bước | Ý nghĩa |
|---|---|
| Ma trận Q, K, V | Ba góc nhìn khác nhau của cùng một token |
| Tích chập Q với K | Điểm tương tự giữa mọi cặp vị trí |
| Chia cho căn bậc hai d_k | Ổn định độ lớn đầu vào softmax |
| Softmax | Đổi điểm thành trọng số tổng bằng 1 |
| Nhân với V | Tạo vector đầu ra đã gộp ngữ cảnh |
Che mặt nạ: vì sao mô hình không được nhìn tương lai
Ở phía bộ giải mã, vị trí thứ i chỉ được phép nhìn về trước, không được nhìn các token phía sau. Để thực thi điều đó, các vị trí không hợp lệ bị gán điểm âm cực lớn trước khi softmax, khiến trọng số của chúng tiến gần bằng 0. Kỹ thuật này gọi là che mặt nạ theo nguyên nhân. Nhờ đó, mô hình chỉ dựa vào các token đã sinh ra để dự đoán token tiếp theo, đúng như mục tiêu huấn luyện.
Multi-head attention: một đầu không đủ
Một câu hỏi tự chú ý duy nhất có xu hướng chỉ nắm bắt một kiểu quan hệ ngữ nghĩa. Bài gốc giải quyết vấn đề này bằng cách chạy nhiều đầu chú ý song song, mỗi đầu có bộ W_Q, W_K, W_V riêng, rồi nối kết quả lại. Bài gốc dùng 8 đầu cho cả bộ giải mã và bộ mã hoá.
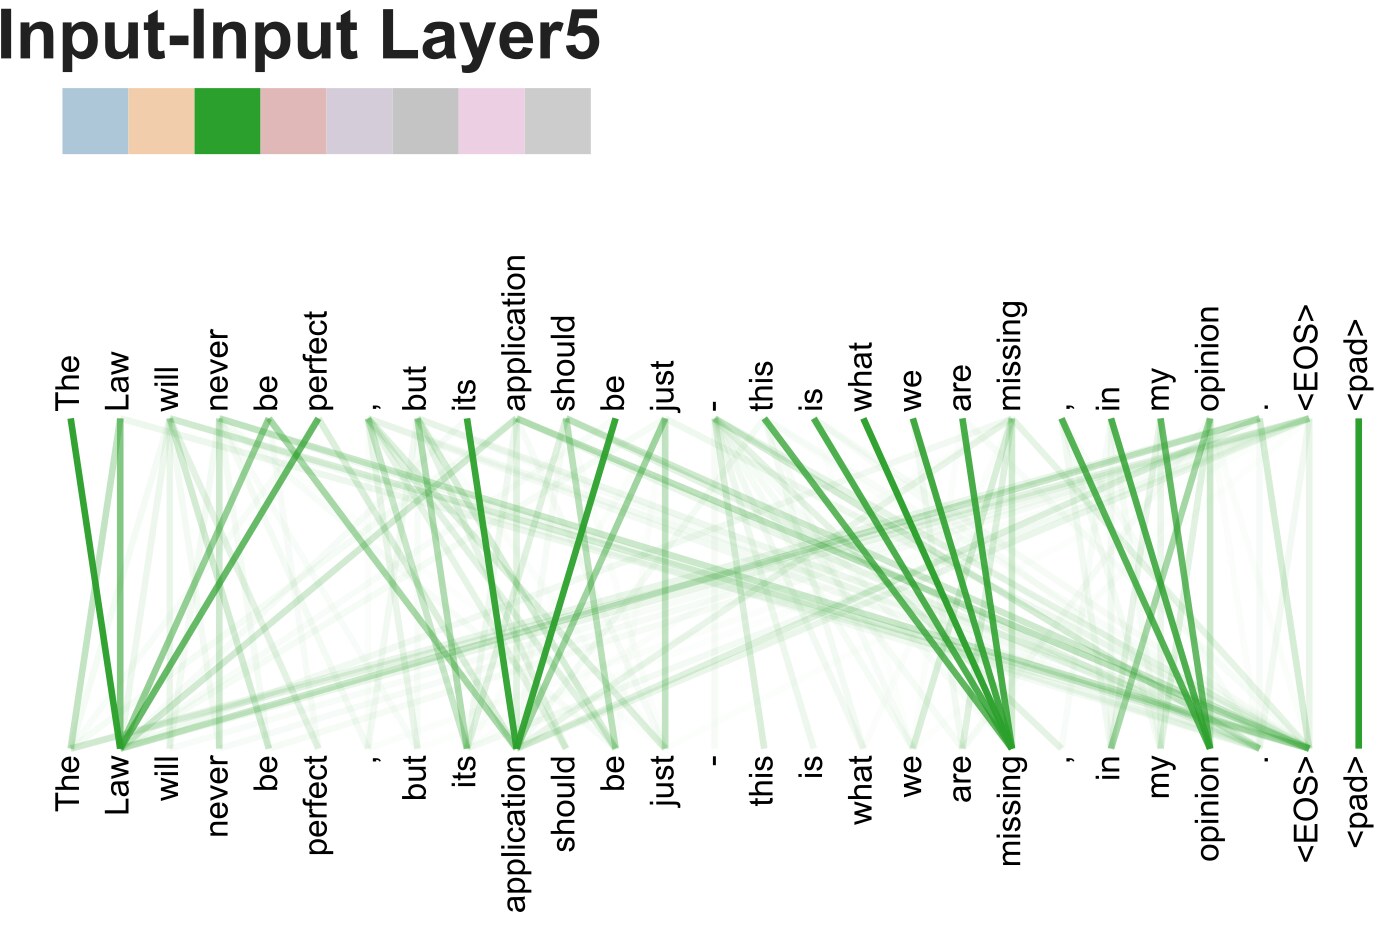
Mỗi đầu chú ý một khía cạnh khác nhau của cùng câu. Trong ví dụ đa giải, một đầu theo dõi từ chủ ngữ, đầu khác theo dõi những từ cần giải thích, đầu thứ ba bám vào cấu trúc cú pháp. Chỉ số chiều của đầu được rút từ tổng số chiều mô hình chia cho số đầu, nên tổng chi phí tính toán gần như giữ nguyên so với một đầu lớn tương đương.
Một chi tiết dễ gây nhầm: nếu đặt tổng số chiều cố định và tăng số đầu, mỗi đầu sẽ mỏng đi. Bài gốc giữ nguyên tổng chiều, nên thêm đầu là thêm năng lực quan sát chứ không phải chia nhỏ năng lực sẵn có.
Chi phí bậc hai: giới hạn thật của self-attention
Đây là hệ quả quan trọng nhất khi tìm hiểu về cơ chế này. Vì mỗi vị trí phải tính điểm với mọi vị trí khác, ma trận điểm có kích thước bằng bình phương độ dài chuỗi. Với một mô hình 8 tỉ tham số, bộ nhớ cần cho ma trận điểm ở chuỗi 1.024 token đã vượt xa bộ nhớ của một GPU thông thường.
Nghiên cứu sau đó đặt tên rõ vấn đề này. Bài FlashAttention nói thẳng rằng thời gian và bộ nhớ của self-attention tăng theo bậc hai so với độ dài chuỗi. Bài Longformer cũng chỉ ra cùng điều và đề xuất giới hạn cửa sổ chú ý cục bộ, đưa chi phí về tuyến tính. Ở mảng thị giác, Swin Transformer chỉ cho phép chú ý trong các cửa sổ không chồng lấn rồi dịch chuyển cửa sổ giữa các tầng.
| Hướng tiếp cận | Cách xử lý bậc hai |
|---|---|
| FlashAttention | Tối ưu thứ tự truy xuất bộ nhớ, giữ kết quả chính xác |
| Longformer | Cửa sổ chú ý cục bộ kèm chú ý toàn cục có chọn lọc |
| Swin Transformer | Cửa sổ cục bộ dịch chuyển giữa các tầng |
| FlashAttention-2 | Chia công việc song song tốt hơn, tăng tốc thêm 2 đến 4 lần |
Self-attention định hình cách các mô hình lớn học
Kiến trúc Transformer và cơ chế self-attention tạo nền tảng cho hàng loạt mô hình ngôn ngữ sau này. Bài BERT chỉ dùng phần bộ mã hoá của Transformer, cho phép mỗi vị trí nhìn được cả hai phía của câu, từ đó tạo ra biểu diễn hai chiều. Chính nhờ đó BERT đạt điểm F1 93.2 trên SQuAD v1.1 và 80.5 phần trăm trên bộ GLUE, những con số khiến việc tiền huấn luyện theo ngôn ngữ trở thành chuẩn mực.
Bản thân self-attention cũng được tách ra dùng độc lập trong nhiều lĩnh vực khác. Trong bài về nhúng câu có cấu trúc, mỗi hàng của ma trận biểu diễn là một kiểu chú ý khác nhau, cho phép so sánh nhiều phần của câu cùng lúc thay vì gộp về một vector duy nhất. Cách tiếp cận này sau này được dùng rộng rãi trong các bài toán truy xuất và so khớp văn bản.
Kết luận
Self-attention thay đổi cách mô hình ngôn ngữ nghĩ về ngữ cảnh: thay vì truyền thông tin tuần tự, nó cho phép mọi vị trí trao đổi thông tin trực tiếp với nhau. Ba ma trận Q, K, V là xương sống của cơ chế, phép chia cho căn bậc hai giữ cho quá trình huấn luyện ổn định, còn che mặt nạ bảo đảm mô hình không nhìn thấy token tương lai. Cái giá phải trả là chi phí bậc hai theo độ dài chuỗi, và phần lớn nghiên cứu cải tiến sau này tập trung vào đúng giới hạn đó.
Nếu bạn muốn tự thử nghiệm, hãy bắt đầu với một trong ba cụm tài liệu thường dùng nhất: bài gốc trên arXiv để hiểu công thức, Annotated Transformer để đọc code PyTorch thực tế, và bài minh hoạ của Alammar để xem cách mỗi con số được tạo ra.